Gibt es verlässliche KI-Sichtbarkeit Benchmarks für meine Branche? Nicht in der Form, die man sich oft wünscht. Ein "Branchendurchschnitt" für KI-Sichtbarkeit vermischt unterschiedliche Fragen, Modelle, Städte und Zeiträume und sagt deshalb wenig darüber aus, wo Sie tatsächlich stehen. Brauchbare KI-Sichtbarkeit Benchmarks entstehen, indem Sie denselben Fragenkatalog mit denselben KI-Systemen im selben Zeitraum für sich selbst und für die wenigen Betriebe auswerten, mit denen Sie wirklich um Kundschaft konkurrieren. Dieser Beitrag zeigt, wie Sie einen solchen Vergleich aufbauen, wie Sie ihn lesen und wie Welda diese Arbeit angeht.
Was KI-Sichtbarkeit Benchmarks eigentlich messen
In der klassischen Suchmaschinenoptimierung war der Vergleich einfach: Sie sahen Ihre Position für ein Keyword, der Mitbewerber stand auf derselben Ergebnisseite, und der Abstand war eine Zahl. In der KI-Suche gibt es diese Liste nicht. Eine Kundin fragt ChatGPT, Gemini, Perplexity oder die KI-Übersichten und den KI-Modus von Google, und die Antwort nennt einige Betriebe beim Namen oder keinen. Stellt man dieselbe Frage zweimal, kann sich die Auswahl ändern. KI-Sichtbarkeit ist also keine einzelne Position, sondern die Summe aus vielen Fragen und vielen Durchläufen.
Genau deshalb braucht GEO (Generative Engine Optimization) eine andere Art von Vergleich. Im englischsprachigen Raum spricht man oft von AEO, Answer Engine Optimization; gemeint ist im Kern dasselbe. Drei Messgrößen zählen:
- Nennungsquote: In welchem Anteil der Fragen wird Ihr Betrieb überhaupt genannt?
- Position: Wenn Sie genannt werden, an welcher Stelle der Antwort?
- Anteil im Wettbewerbsumfeld: Wie viele aller Nennungen in Ihrer Vergleichsgruppe entfallen auf Sie?
Ein Benchmark entsteht, wenn Sie diese drei Werte für sich und für Ihre Mitbewerber unter identischen Bedingungen ermitteln. Die Branche spielt dabei eine große Rolle, denn welche Fragen gestellt werden, welche Quellen die Modelle lesen und wer überhaupt als Mitbewerber gilt, unterscheidet sich stark. Ein Boutiquehotel und eine Zahnarztpraxis lassen sich nicht mit derselben Vorlage vergleichen.
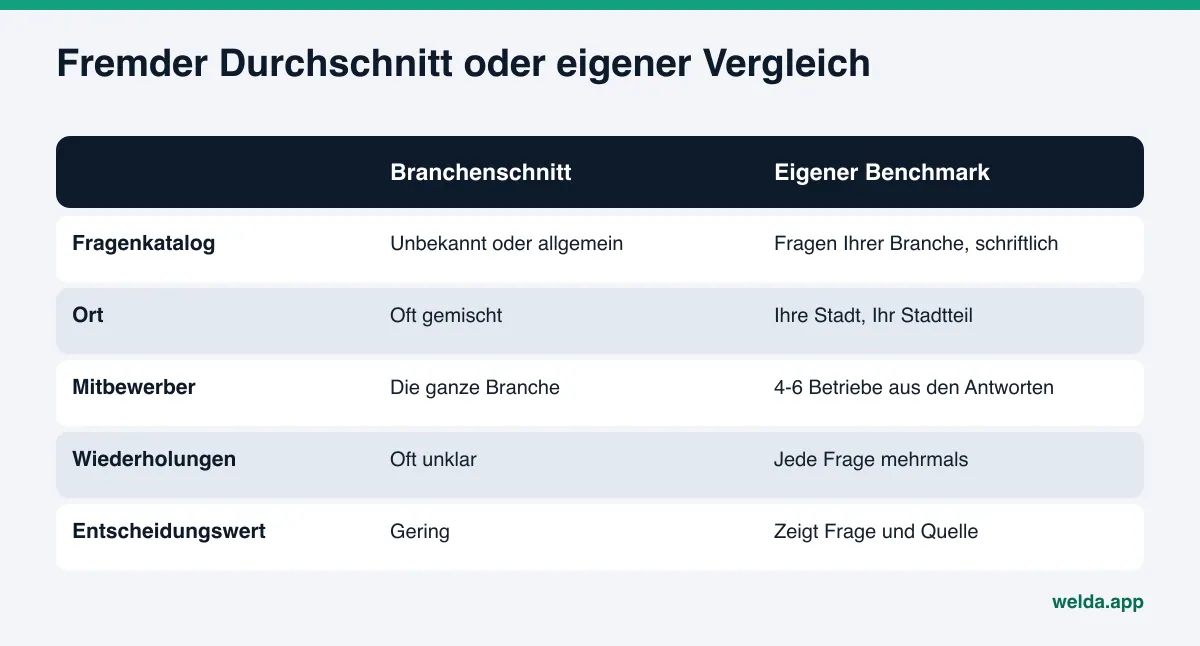
Warum ein veröffentlichter Branchendurchschnitt nicht trägt
Aussagen wie "Restaurants erreichen im Schnitt X Prozent KI-Sichtbarkeit" sind mit Vorsicht zu lesen. Es gibt konkrete Gründe, warum sich eine fremde Zahl nicht auf Ihren Betrieb übertragen lässt.
| Einflussgröße | Warum der Vergleich daran scheitert |
|---|---|
| Fragenkatalog | "Bestes Restaurant in Hamburg" und "Restaurant in Ottensen, das nach 22 Uhr noch Küche hat" begünstigen völlig unterschiedliche Betriebe. |
| Modell und Zugangsweg | Systeme mit Websuche antworten anders als solche ohne, und App-Antworten können von API-Antworten abweichen. |
| Ort | Lokale Antworten hängen von der Stadt, oft vom Viertel ab. Ein Wert aus Zürich sagt nichts über Graz. |
| Sprache | Dieselbe Frage auf Deutsch und auf Englisch führt zu anderen Quellen und anderen Namen. |
| Zeitpunkt | Modelle werden aktualisiert, Quellen ändern sich. Ein Durchschnitt von vor sechs Monaten entstand unter anderen Bedingungen. |
| Wiederholungen | Ein einzelner Durchlauf verdeckt die normale Schwankung zwischen Abfragen; kleine Abstände wirken größer, als sie sind. |
Der Punkt mit dem Zugangsweg überrascht viele Teams. Wir haben ihn in unserem Beitrag zu API- und App-Antworten im KI-Tracking ausführlich behandelt. Die allgemeine Regel lautet: Zwei Zahlen sind nur vergleichbar, wenn sie auf dieselbe Weise entstanden sind.
Aus diesem Grund veröffentlicht Welda keine Branchendurchschnitte und keine Schwellenwerte für einen "guten" Wert. Der Vergleich, der zählt, ist der mit den Betrieben, die um dieselbe Kundschaft werben, gemessen auf dieselbe Weise. Einen ersten Ausgangspunkt bekommen Sie heute mit der kostenlosen Website-Analyse. Sie liest Ihre Website so, wie Google und KI-Systeme sie lesen, vergibt einen Wert von 100 Punkten und enthält einen Wettbewerbsvergleich, der zeigt, wo Ihre Website hinter der eines Mitbewerbers zurückbleibt. Das ist schmaler als eine laufende Messung, aber eine saubere Ausgangsbasis.
Wie sich KI-Sichtbarkeit Benchmarks je nach Branche unterscheiden
Bevor Sie etwas aufbauen, lohnt sich ein Blick darauf, wie in Ihrer Branche gefragt wird. Drei Dinge verschieben sich von Branche zu Branche.
Die Mischung der Fragen. Ein Restaurant bekommt viele Fragen nach "jetzt geöffnet" und "in der Nähe". Ein Hotel bekommt Vergleichsfragen ("Altstadt oder nahe der Messe?") und Bedingungsfragen ("Hund erlaubt, mit Parkplatz?"). Eine Zahnarztpraxis bekommt dringende Fragen ("Zahnarzt-Notdienst am Wochenende") und dazu Fragen zu Kosten und Vertrauen ("Ist die Krone im Implantat-Kostenvoranschlag enthalten?"). Ein Handwerksbetrieb bekommt sehr konkrete Auftragsfragen ("Wer repariert Gasthermen in Wien-Favoriten?"). Wer seinen Fragenkatalog vor allem auf "bester X in Stadt" aufbaut, verpasst die Fragen, die tatsächlich Kundschaft bringen.
Die Quellen, auf die sich die Modelle stützen. In der Hotellerie spielen Buchungsportale, Bewertungsseiten und Karteneinträge oft eine große Rolle. Im Gesundheitsbereich tauchen Arztportale wie Jameda, das Google Unternehmensprofil und Praxiswebsites auf. Bei Dienstleistern stehen häufig Gelbe Seiten, ProvenExpert oder Trustpilot neben der eigenen Website. Welche Quellen in Ihrem Markt dominieren, ist eine Frage der Messung, nicht der Annahme. Aber das Wissen, dass die Quellenlandschaft in manchen Branchen breit und in anderen schmal ist, verändert die Deutung eines Abstands. In einer breiten Landschaft kann der Vorsprung eines Mitbewerbers aus vielen kleinen Einträgen bestehen. In einer schmalen können wenige vollständige Profile entscheiden.
Wer als Mitbewerber zählt. In einer überregionalen Onlineshop-Kategorie sind es vielleicht einige bekannte Marken. Bei lokalen Dienstleistungen ist es meist der Betrieb drei Straßen weiter mit ähnlichem Angebot und ähnlichem Preis, nicht der bekannteste Name im Bundesland.
Beispiel: ein Fragenkatalog für eine Zahnarztpraxis
Hier ein beispielhafter Fragenkatalog für eine fiktive Zahnarztpraxis in Köln. Die Fragen wurden für diesen Beitrag als Modell formuliert und stammen nicht aus einer Messung. Entscheidend ist die Verteilung auf verschiedene Fragengruppen.
| Fragengruppe | Beispielfrage | Was der Vergleich prüft |
|---|---|---|
| Allgemein | Kannst du mir eine gute Zahnarztpraxis für die ganze Familie in Köln-Nippes empfehlen? | Werden Sie für Ihre Kernleistung genannt? |
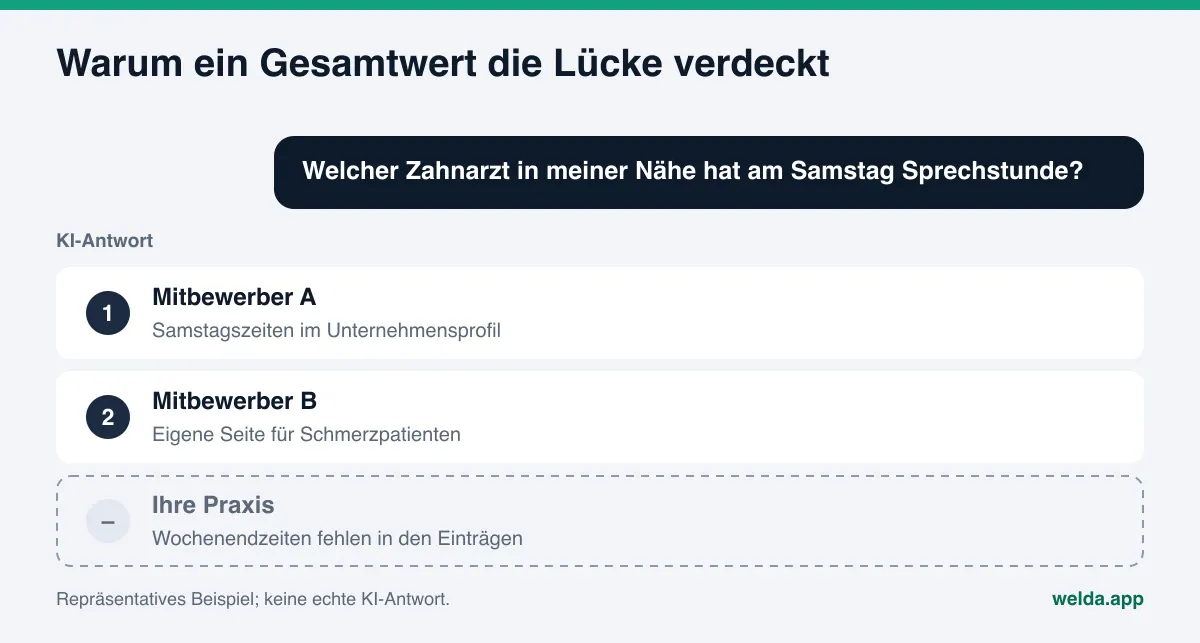
| Dringend | Welcher Zahnarzt in Köln hat am Samstag Sprechstunde? | Stimmen Ihre Öffnungszeiten in den Quellen? |
| Kosten und Vertrauen | Was zahlt die gesetzliche Krankenkasse bei einer Krone dazu? | Gibt es Inhalte, die den Ablauf erklären? |
| Viertel | Zahnarzt in Ehrenfeld mit Abendterminen? | Sind Lage und Abendtermine eindeutig angegeben? |
| Sprache | English-speaking dentist in Cologne city centre? | Beantworten Ihre englischen Seiten diese Frage? |
Nach Fragengruppen gelesen kann die Beispielpraxis bei allgemeinen Fragen gleichauf mit den Mitbewerbern liegen und bei dringenden Fragen gar nicht vorkommen. Die Ursache ist oft schlicht: Die Samstagssprechstunde fehlt im Google Unternehmensprofil, oder die Website erwähnt nirgends, dass Schmerzpatienten kurzfristig Termine bekommen. Ein einziger Gesamtwert würde das verdecken. Ein Vergleich nach Fragengruppen verbindet jede Lücke mit einer konkreten Aufgabe.
Im Gesundheitsbereich gilt: Inhalte, die Kosten- und Vertrauensfragen beantworten, müssen die Werberegeln Ihres Berufsstands beachten, in Deutschland etwa das Heilmittelwerbegesetz (HWG) und das Berufsrecht. Vermeiden Sie Erfolgsversprechen, Überlegenheitsbehauptungen und alles, was wie eine Diagnose klingt. Das ist keine Rechtsberatung; klären Sie Inhalte vor der Veröffentlichung mit Ihrer eigenen Beratung ab.
Die richtige Vergleichsgruppe wählen
Der häufigste Fehler beim Benchmarking ist die falsche Auswahl der Mitbewerber. Betriebe tragen gern den bekanntesten Namen ihrer Branche ein. In KI-Antworten nimmt Ihren Platz aber meist ein Nachbarbetrieb mit ähnlicher Leistung und ähnlichem Preis ein.
- Bei den Antworten anfangen. Stellen Sie Ihren Fragenkatalog einigen KI-Systemen und notieren Sie, welche Betriebe statt Ihnen genannt werden. Diese Liste ist Ihre erste Vergleichsgruppe, nicht die aus dem Kopf.
- Den Raum eingrenzen. Als lokaler Betrieb bleiben Sie bei Ihrer Stadt und möglichst Ihrem Stadtteil.
- Die Leistung abgleichen. Ein Boutiquehotel konkurriert nicht zwingend mit einer großen Kette, eine auf Implantate spezialisierte Praxis nicht zwingend mit einer allgemeinen Praxis.
- Einen Spitzenreiter aufnehmen. Nehmen Sie den Betrieb dazu, der am häufigsten genannt wird. Der Abstand zu ihm zeigt, wie weit das Ziel entfernt ist.
- Die Gruppe klein halten. Vier bis sechs Mitbewerber reichen für die meisten lokalen Betriebe. Eine größere Gruppe verwässert den Anteil und wird schwer lesbar.
Warum ein Mitbewerber vorne liegt und wie Sie den Vorsprung auf seine Quellen zurückführen, beschreiben wir in unserem Beitrag zur Wettbewerbsanalyse in KI-Antworten.
KI-Sichtbarkeit Benchmarks Schritt für Schritt aufbauen
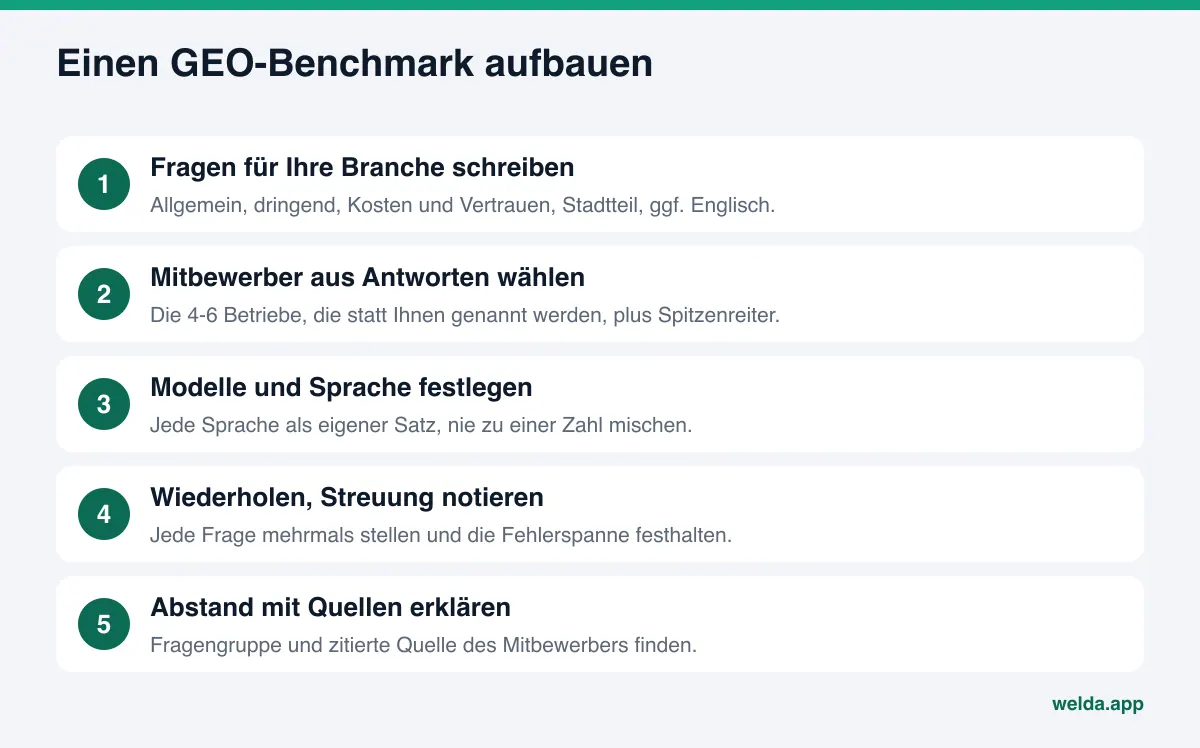
Steht die Vergleichsgruppe fest, folgt die Messung selbst. Das geht von Hand oder mit einem Werkzeug. Wichtig ist, dass die Bedingungen in jedem Schritt gleich bleiben.
1. Fragenkatalog für Ihre Branche schreiben. Formulieren Sie die Fragen so, wie Ihre Kundschaft spricht. Decken Sie alle relevanten Gruppen ab: allgemeine Fragen, dringende oder situative Fragen, Kosten und Vertrauen, Stadtteil und, falls Sie Gäste aus dem Ausland haben, Fragen auf Englisch.
2. Den Katalog einfrieren. Ein Benchmark ist nur dann etwas wert, wenn er wiederholbar ist. Legen Sie die Fragen für den Zeitraum fest. Neue Fragen kommen erst zu Beginn des nächsten Zeitraums hinzu; die alten Ergebnisse bleiben, wie sie sind.
3. Modelle und Sprache festlegen. Entscheiden Sie, welche KI-Systeme Sie messen und in welcher Sprache jede Frage gestellt wird. Deutsch- und englischsprachige Fragen gehören in getrennte Sätze; mischen Sie sie nicht zu einer Zahl. Mehr dazu in unserem Beitrag zum mehrsprachigen KI-Tracking.
4. Jede Frage wiederholen. KI-Antworten sind nicht jedes Mal gleich. Ein einzelner Durchlauf kann eine zufällige Nennung erwischen oder eine echte verpassen. Stellen Sie jede Frage mehrmals, bilden Sie den Mittelwert und notieren Sie die Streuung.
5. Für alle dieselben drei Werte berechnen. Nennungsquote, durchschnittliche Position und Anteil, für Sie und für jeden Mitbewerber, aus denselben Fragen und denselben Durchläufen.
6. Den Abstand mit Quellen erklären. Bei welchen Fragen liegt ein Mitbewerber vorne, und welche Websites werden in diesen Antworten zitiert? Ein Benchmark sollte mit "Wir liegen bei dringenden Fragen wegen dieser zwei Einträge zurück" enden, nicht mit "Wir liegen zurück".
7. Unter gleichen Bedingungen erneut messen. Der erste Durchlauf ist die Ausgangsbasis. Aussagekräftig wird der Vergleich, wenn Sie etwas ändern und mit demselben Katalog erneut messen. Zum Rhythmus lesen Sie unseren Beitrag wie oft Sie KI-Sichtbarkeit messen sollten.
Ergebnisse lesen, ohne sich zu täuschen
Der Blick geht zuerst auf den Gesamtwert. Entscheidungen ergeben sich aber meist aus den Teilen darunter. Die folgende Tabelle ordnet typische Muster ein. Sie ist eine qualitative Lesehilfe, keine Messung, und jedes Muster kann mehr als eine Ursache haben.
| Was Sie sehen | Wahrscheinliche Bedeutung | Wo Sie zuerst hinschauen |
|---|---|---|
| Selten genannt, dann aber weit oben | Die Modelle kennen Sie, verbinden Sie aber mit wenigen Anliegen | Klare, getrennte Leistungsbeschreibungen auf der Website |
| Oft genannt, aber immer weit unten | Sie stehen auf der Liste, aber nichts hebt Sie ab | Bewertungen, Vertrauenssignale, unterscheidende Details |
| In einer ganzen Fragengruppe nicht vorhanden | Sie fehlen in den Quellen, die für dieses Anliegen gelesen werden | Zitierte Quellen, wenn Mitbewerber dort gewinnen |
| Stark bei einem Modell, schwach bei einem anderen | Die Modelle vertrauen unterschiedlichen Quellen | Quellen des schwächeren Modells |
| Weit hinter dem Spitzenreiter, gleichauf mit dem Rest | Sie teilen die Lücken der übrigen Gruppe | Fragengruppen und Quellen des Spitzenreiters |
| Kleine Bewegung zwischen zwei Messungen | Kann innerhalb der Fehlerspanne liegen | Streuung der Durchläufe und nächste Messung |
Die letzte Zeile verdient Nachdruck. Es ist verlockend, zwei Punkte Zuwachs als "überholt" zu lesen. Wenn die Fehlerspanne aus den Wiederholungen diesen Abstand abdeckt, lautet die ehrliche Lesart: Sie stehen am selben Punkt.
Wie Welda diese Arbeit macht
Bei Welda ist der Vergleich nie ein Branchendurchschnitt. Er wird gegen die Mitbewerber aufgebaut, die Sie auswählen und die in den Antworten immer wieder auftauchen. Drei Teile des Produkts tragen diese Arbeit.
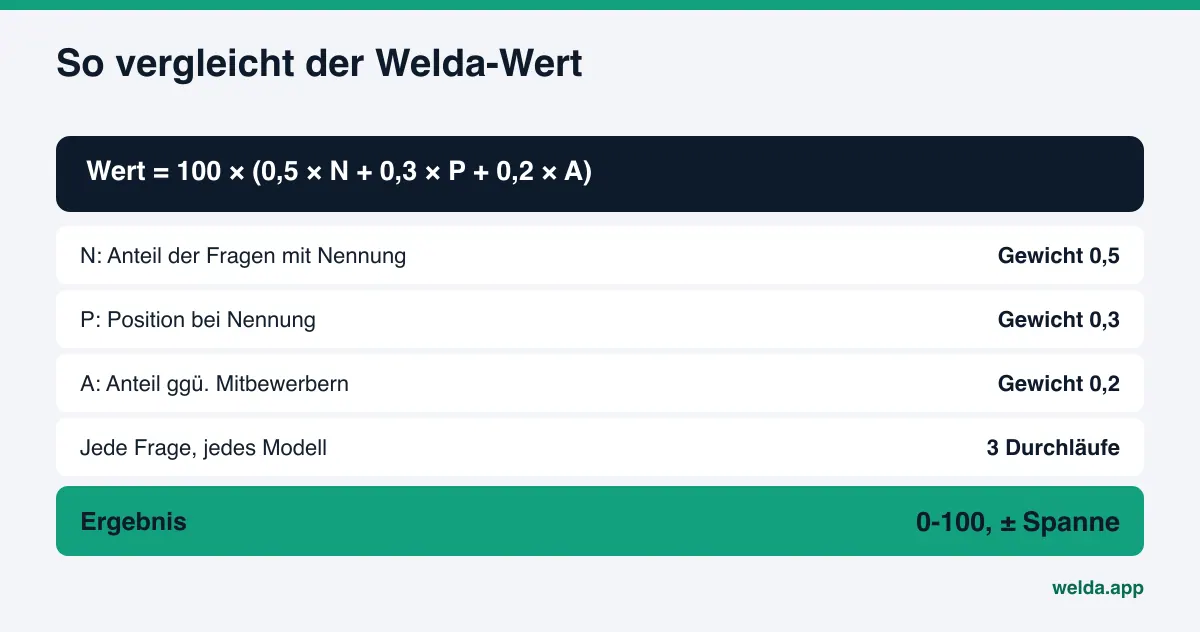
Ein gemeinsamer Fragenkatalog, wiederholte Durchläufe. Im Welda-Dashboard werden die Fragen, die Ihre Kundschaft stellen würde, einmal festgelegt und jeweils dreimal an ChatGPT, Gemini, Perplexity und Google AI gestellt. Ihre Mitbewerber werden mit denselben Fragen im selben Durchlauf ausgewertet; Ihr Wert und der des Mitbewerbers entstehen also unter gleichen Bedingungen. Die Fragensprache ist derzeit Türkisch oder Englisch wählbar.
Eine offene Formel mit Fehlerspanne. Der Wert gewichtet die Nennungsquote mit 50 Prozent, die Position mit 30 Prozent und den Anteil gegenüber Mitbewerbern mit 20 Prozent. Weil die Formel offen ist, sehen Sie, welcher Teil den Abstand erklärt: Werden Sie bei weniger Fragen genannt, oder stehen Sie weiter unten, wenn Sie genannt werden? Aus der Streuung der drei Durchläufe ergibt sich eine Fehlerspanne (±), die verhindert, dass Sie kleine Bewegungen überbewerten.
Die Ansicht Mitbewerber. Hier wird der Vergleich gelesen. Für jeden Betrieb der Gruppe stehen Wert, Nennungsquote und Anteil nebeneinander, Ihre Zeile ist hervorgehoben. Daneben steht, in welcher Fragengruppe ein Mitbewerber gewinnt und aus welcher Quelle er zitiert wird. Die Entscheidung, die diese Ansicht unterstützt, ist konkret: an welcher Fragengruppe und an welcher Quelle zuerst gearbeitet wird.
Lücken aus dem Vergleich landen auf einer einzigen Aufgabenliste. Fehlt eine Information, fragt Welda nach, statt zu raten. Wird Text gebraucht, liegt ein Entwurf bereit. Ist ein Profil nicht verbunden, wird die Aufgabe als manuell markiert. Die Freigabe zur Veröffentlichung bleibt bei Ihnen, und Inhalte liegen immer auf Ihrer eigenen Website. Ein einseitiger Monatsbericht fasst zusammen, wie sich Ihr Anteil gegenüber den Mitbewerbern verändert hat; wie Sie ihn lesen, erklärt unser Beitrag zum monatlichen GEO-Report.
Early Access, Grenzen und was Welda nicht tut
Zum aktuellen Stand: Das Welda-Dashboard befindet sich im Early Access und wird zuerst für Betriebe in der Türkei geöffnet. Die regelmäßige Messung mit vier KI-Systemen kommt im Laufe des Early Access hinzu; Beispielansichten des Dashboards zeigen repräsentative Daten. Was alle heute nutzen können, ist die kostenlose Website-Analyse, die auch auf Deutsch funktioniert. Über Preise sprechen wir im Early-Access-Gespräch.
Speziell für Benchmarks gelten diese Grenzen:
- Welda veröffentlicht keine Branchendurchschnitte und keine Angaben wie "guter Wert für Ihre Branche". Der Vergleich ist Ihre Vergleichsgruppe.
- Welda garantiert keine Platzierung und kein "Erscheinen in ChatGPT". Ein Benchmark zeigt, wo Sie stehen und was fehlt; er verspricht kein Ergebnis.
- Welda erfindet keine Fakten über Sie oder Ihre Mitbewerber. Was unbekannt ist, wird erfragt.
- Welda schreibt keine gefälschten Bewertungen. Der Umgang mit negativen Bewertungen, Verzeichniskonten und Pressearbeit bleibt bei Ihnen.
- Neue Inhalte brauchen in der Regel Wochen, bis sie in KI-Antworten auftauchen. Erwarten Sie keine Bewegung im Vergleich wenige Tage nach einer Änderung.
Auch die kostenlose Analyse hat als Vergleichswerkzeug Grenzen. Sie misst keine Rankings. Sie stellt einmalig fünf Kundenfragen an einen KI-Assistenten mit Websuche und prüft, ob Ihr Betrieb genannt wird. Das ist eine nützliche Momentaufnahme, keine laufende Messung.
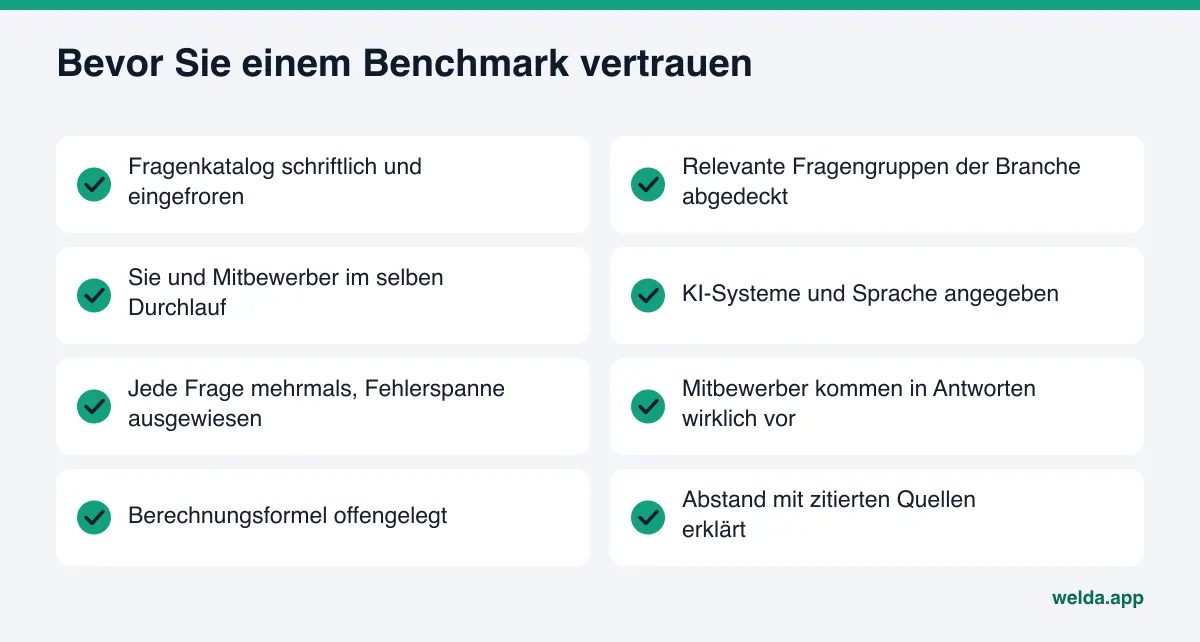
Checkliste, bevor Sie einem Benchmark vertrauen
Ob Sie den Vergleich selbst erstellen oder eine Agentur bzw. ein Anbieter ihn liefert, stellen Sie zuerst diese Fragen:
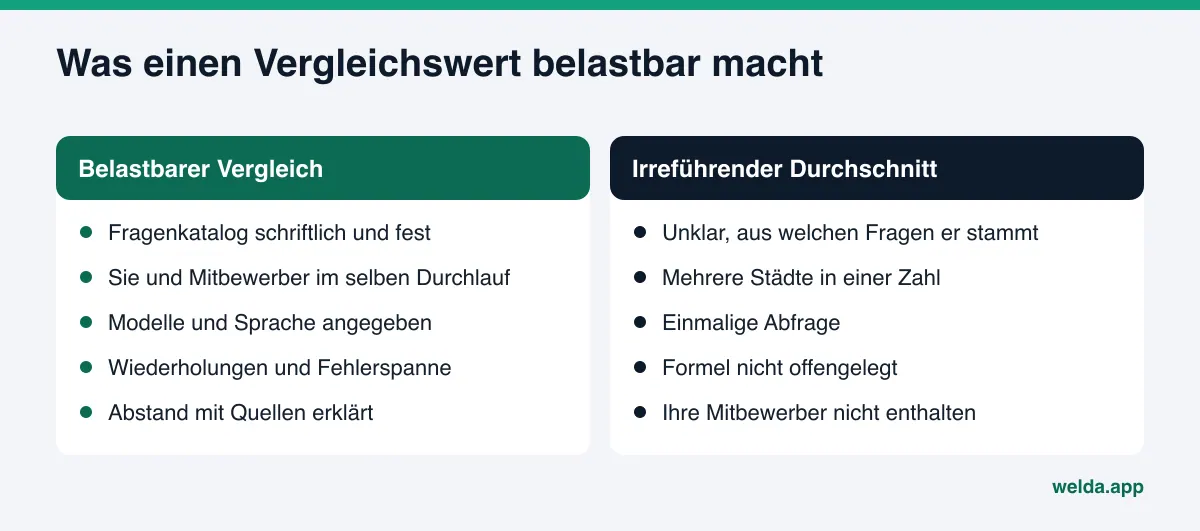
- Ist der Fragenkatalog schriftlich festgehalten und deckt er die relevanten Fragengruppen Ihrer Branche ab?
- Wurden Sie und die Mitbewerber mit denselben Fragen im selben Durchlauf gemessen?
- Sind die KI-Systeme und die Sprache angegeben?
- Wurde jede Frage mehrmals gestellt, und ist eine Fehlerspanne ausgewiesen?
- Sind die Mitbewerber Betriebe, die tatsächlich in Antworten vorkommen, oder eine geschätzte Liste?
- Ist die Berechnungsformel offengelegt?
- Wird der Abstand mit Quellen erklärt?
- Findet die nächste Messung unter denselben Bedingungen statt?
Lautet die Antwort meist "nein", halten Sie eine Momentaufnahme in der Hand, keinen Benchmark. Auch Momentaufnahmen haben ihren Nutzen, aber für Entscheidungen reichen sie nicht.
Häufige Fragen
Welcher Wert für KI-Sichtbarkeit ist in meiner Branche gut?
Eine verlässliche Einzelzahl gibt es nicht. Der Wert hängt vom Fragenkatalog, den KI-Systemen, dem Ort und der Vergleichsgruppe ab. Entscheidend ist Ihre Position gegenüber gleich gemessenen Mitbewerbern und wie sich dieser Abstand entwickelt.
Kann ich den Welda-Wert mit dem Wert eines anderen Werkzeugs vergleichen?
Nicht direkt. Werkzeuge arbeiten mit anderen Fragen, Modellen und Formeln. Vergleichen Sie innerhalb eines Werkzeugs, mit demselben Fragenkatalog und denselben Mitbewerbern.
Mit wie vielen Mitbewerbern sollte ich mich vergleichen?
Für die meisten lokalen Betriebe genügen vier bis sechs. Nehmen Sie einen häufig genannten Spitzenreiter und einige Nachbarbetriebe auf, die Ihnen am ähnlichsten sind.
Mein Hauptkonkurrent ist eine große Kette. Gehört sie in die Gruppe?
Ja, wenn sie in den Antworten auf Ihre Fragen tatsächlich vorkommt. Bei Fragen nach Stadtteil und konkreter Leistung sind Ihre eigentlichen Mitbewerber aber oft ähnlich große lokale Betriebe. Behalten Sie die Kette als Spitzenreiter und bauen Sie den Vergleich um Ihre Nachbarn auf.
Was zeigt der Wettbewerbsvergleich in der kostenlosen Analyse?
Der Bericht enthält einen Vergleich Ihrer Website mit der eines Mitbewerbers und hilft Ihnen zu sehen, wo Ihre Website zurückbleibt. Eine laufende Messung des Anteils in KI-Antworten ist er nicht; das ist Aufgabe der Mitbewerber-Ansicht im Dashboard.
Wie schnell ändern sich Benchmark-Ergebnisse?
Neue Inhalte brauchen in der Regel Wochen, bis sie sich in KI-Antworten zeigen. Wiederholen Sie den Vergleich in festem Abstand mit demselben Katalog, statt täglich nachzusehen.
Ihren eigenen Vergleich starten
Gute KI-Sichtbarkeit Benchmarks entstehen aus Ihrer eigenen Vergleichsgruppe, einem eingefrorenen Fragenkatalog und wiederholten Durchläufen, nicht aus einem fremden Durchschnitt. Der erste Schritt ist, zu sehen, wo Ihre Website heute steht. Starten Sie die kostenlose Analyse Ihrer KI-Sichtbarkeit und erhalten Sie Ihren Wert, Ihre Lücken, einen Wettbewerbsvergleich und einen KI-Test mit fünf Fragen in einem Bericht.