Unterscheiden sich API- und App-Antworten im KI-Tracking? Ja. Wenn Sie ChatGPT in der App mit Ihrem eigenen Konto fragen, ist das nicht dasselbe, wie wenn eine Software dieselbe Frage über die API an das Modell schickt. Gedächtnis, Standort, gewähltes Modell, ob eine Websuche läuft und die Tatsache, dass jede Antwort neu erzeugt wird, verändern das Ergebnis. Ein einzelner Screenshot ist deshalb keine Messung, ein einzelner API-Aufruf auch nicht.
Dieser Beitrag erklärt, woher der Unterschied zwischen API- und App-Antworten im KI-Tracking kommt, wie Sie die Antwort auf Ihrem eigenen Smartphone einordnen, wie Sie die Messung Ihrer KI-Sichtbarkeit trotzdem verlässlich halten und was Welda dabei tut und was nicht. Wenn Sie noch keinen Ausgangswert haben, beginnen Sie am besten mit der kostenlosen Analyse Ihrer KI-Sichtbarkeit.
Was unterscheidet API-Antworten von App-Antworten?
Eine Frage kann auf zwei Wegen an eine KI gestellt werden. Der erste Weg ist der bekannte: Sie öffnen ChatGPT, Gemini oder Perplexity, melden sich an und tippen. Bei Google geben Sie die Frage in das Suchfeld ein, und die Antwort erscheint als KI-Übersicht oder im KI-Modus auf der Ergebnisseite. Der zweite Weg ist der von Entwicklern: Eine Software schickt die Frage an die Programmierschnittstelle des Anbieters, die API, und erhält die Antwort als Text zurück.
Beide Wege können die Modelle desselben Anbieters nutzen, laufen aber nicht unter denselben Bedingungen. Die App kennt Sie. Ihr Konto, Ihre bisherigen Chats, der Standort Ihres Geräts, das gewählte Modell und die eigenen Vorgaben der App fließen in die Antwort ein. Die API kennt nur, was die Software mitschickt: das genannte Modell, die aktivierten Werkzeuge, den übergebenen Standort. Was nicht mitgeschickt wird, gehört nicht zur Antwort.
Auf die Frage "Was sagt ChatGPT über meinen Betrieb?" gibt es daher keine einzige Antwort. ChatGPT kann je nach Person, Ort, Modus und den in dieser Suche gelesenen Quellen Unterschiedliches sagen. Wer seine KI-Sichtbarkeit misst, schützt sich mit diesem Wissen vor Fehlalarm und vor falscher Beruhigung.
Sechs Gründe für unterschiedliche Antworten
Die wichtigsten Ursachen im Überblick. Nicht jede wiegt bei jeder Engine gleich schwer, für lokale Betriebe sind die ersten drei aber meist entscheidend.
- Gedächtnis und Personalisierung. Ist in der ChatGPT-App das Gedächtnis aktiv, können gespeicherte Erinnerungen und frühere Chats genutzt werden, um Antworten zu personalisieren. Wer die eigene Praxis oder das eigene Hotel oft erfragt hat, wird es in der App leichter genannt bekommen. Eine Frage über die API bringt diese Vorgeschichte nicht mit.
- Standort. Der Hilfeartikel von OpenAI zur ChatGPT-Suche beschreibt, dass die App für lokale Ergebnisse einen ungefähren, aus der IP-Adresse abgeleiteten Standort nutzen kann und dass das Teilen des genauen Gerätestandorts optional ist. In der API gibt es einen Standort nur, wenn die Software ihn übergibt: Die Entwicklerdokumentation von OpenAI zur Websuche nennt dafür Land, Stadt, Region und Zeitzone als ungefähre Angabe. Bei einer Frage mit "in meiner Nähe" kann allein das die Antwort verändern.
- Ob eine Websuche stattfindet. In der API ist die Websuche ein Werkzeug, das in der Anfrage aktiviert werden muss; selbst dann entscheidet das Modell anhand der Frage, ob es sucht. Die Dokumentation zur Gemini API mit Google-Suche beschreibt dasselbe Muster: Das Suchwerkzeug wird in der Anfrage angegeben, und das Modell prüft, ob eine Suche die Antwort verbessert. Ohne Suche spricht das Modell nur aus seinen Trainingsdaten, also meist ohne aktuelle Informationen und oft ohne lokale Betriebe.
- Modell und Modus. In der App kann je nach Tarif und gewähltem Modus ein anderes Modell antworten. In der API legt die Software das Modell per Namen fest. Zwei Modelle desselben Anbieters beantworten dieselbe Frage unterschiedlich lang und mit anderen Quellen.
- Vorgaben und Oberfläche der App. Die App formatiert die Antwort und ergänzt teils Karten, Ortskarten, Quellenlisten oder Einkaufsmodule. Eine API-Antwort ist meist reiner Text. Ein Betrieb kann in der App in einer Kartenansicht erscheinen und im API-Text fehlen, oder umgekehrt.
- Jede Antwort wird neu erzeugt. Auch bei identischen Bedingungen schreibt die Engine die Antwort jedes Mal neu. Fragen Sie zweimal hintereinander, kann ein Betrieb vom zweiten auf den vierten Platz rutschen oder verschwinden. Diese Schwankung gibt es in der App und in der API.
Ein eigener Hinweis zu Google: KI-Übersichten und KI-Modus laufen innerhalb der Suchergebnisseite. Eine Antwort aus der Gemini API ist nicht dasselbe Produkt wie die KI-Übersicht, die eine suchende Person zur selben Frage sieht. Die eine nutzt Standort, Sprache und Suchergebnisse der Person, die andere nur das, was die Software übergibt.
Warum der Unterschied für Ihren Betrieb zählt
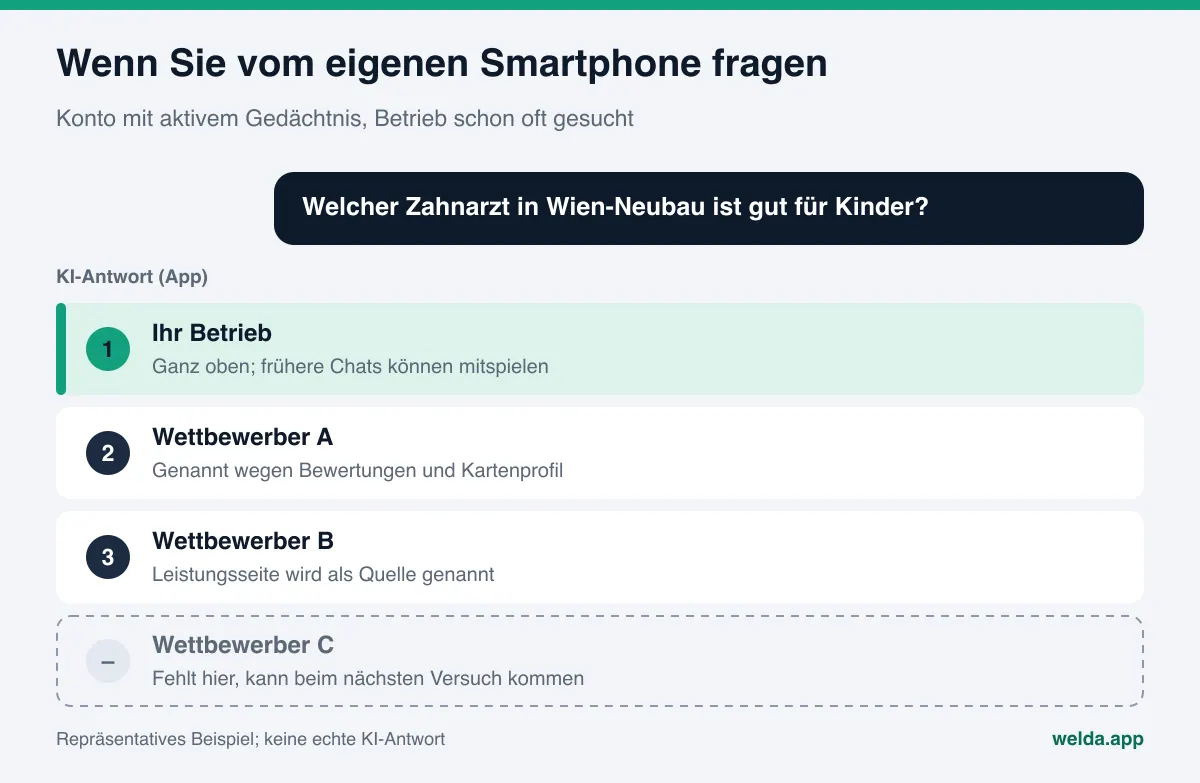
Der häufigste Fall: Die Inhaberin einer Zahnarztpraxis fragt auf dem eigenen Smartphone "Welcher Zahnarzt in Wien-Neubau ist gut für Kinder?", sieht ihre Praxis an erster Stelle und ist beruhigt. Doch das Smartphone liegt in der Praxis, das Konto hat die Praxis Dutzende Male gesucht, vielleicht wurde die Website schon einmal in einen Chat kopiert. Was sie sieht, ist nicht das, was eine neue Patientin aus einem anderen Bezirk sieht, die die Praxis nicht kennt.
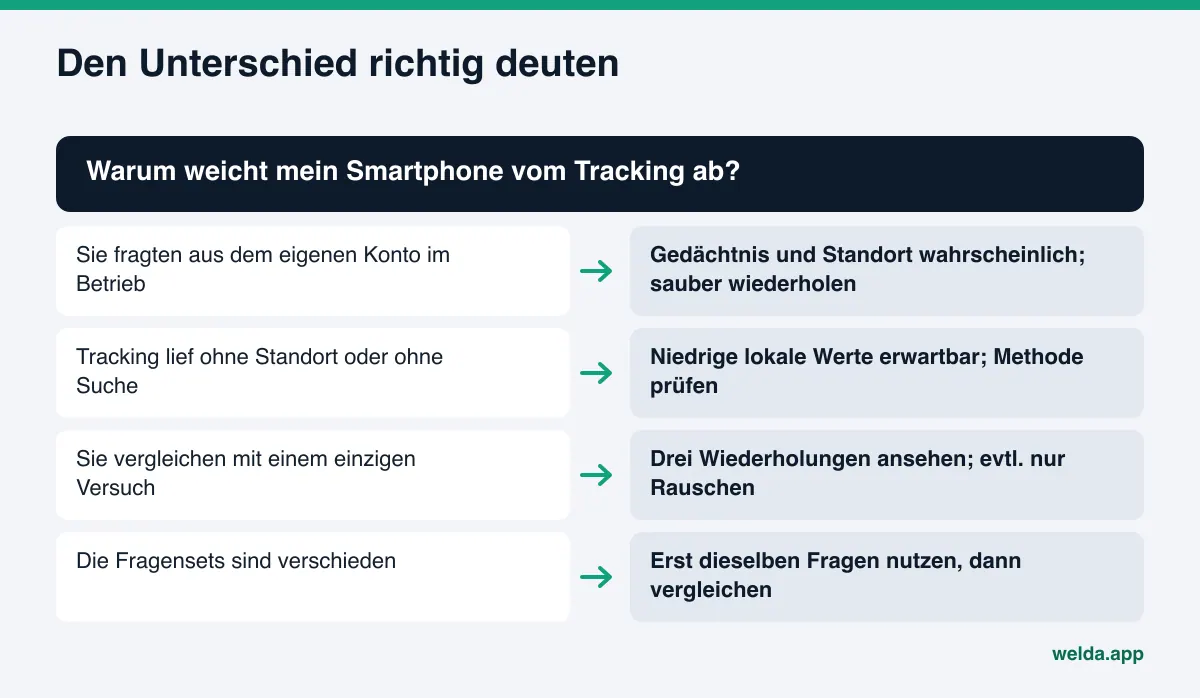
Auch das Gegenteil kommt vor. Eine Agentur lässt eine Reihe von Prompts über die API laufen, der Name des Betriebs taucht in keiner Antwort auf, und der Bericht lautet "nicht sichtbar". Möglicherweise wurden die Prompts aber ohne Standort und ohne Websuche gesendet. Dann ist es zu erwarten, dass ein lokaler Betrieb nirgends erscheint, und das Ergebnis sagt wenig darüber, was echte Kundinnen und Kunden sehen.
Beide Fehler kosten. Im ersten Fall wird notwendige Arbeit aufgeschoben: Die strukturierten Unternehmensdaten bleiben lückenhaft, eine alte Telefonnummer bei Gelbe Seiten oder im Google Unternehmensprofil wird nicht korrigiert. Im zweiten Fall fließt Budget aus Sorge in die falsche Maßnahme. Ziel des Trackings ist ein wiederholbares Bild, das möglichst nah an dem liegt, was Kundschaft im Allgemeinen sieht. Dafür müssen Sie wissen, was jeder Weg zeigt.
Dazu kommt ein Vergleichsproblem. Wenn Sie letzten Monat in der App und diesen Monat über die API geschaut haben, lässt sich nicht trennen, welcher Teil der Veränderung echt ist und welcher aus der Methode stammt. Die erste Regel jeder Messung lautet: Methode konstant halten.
Ein Beispiel macht es greifbar. Der Inhaber eines Beispiel-Boutiquehotels fragt am Rezeptionsrechner "ruhiges Hotel nahe am See in Konstanz" und sieht sein Haus auf Platz zwei. Am selben Abend stellt ein Bekannter in Zürich, der das Hotel nie gesucht hat, dieselbe Frage im eigenen Konto; das Hotel fehlt. Ein dritter Versuch ist ein API-Aufruf ohne Standort und ohne Websuche; die Antwort beschreibt allgemein die Region und nennt kein einziges Hotel. Alle drei Antworten sind echt, aber jede beantwortet andere Bedingungen. Für eine Entscheidung brauchen Sie eine wiederholte Messung mit festen Bedingungen, die zwischen diesen dreien liegt.
API- und App-Antworten im KI-Tracking: was welcher Weg zeigt
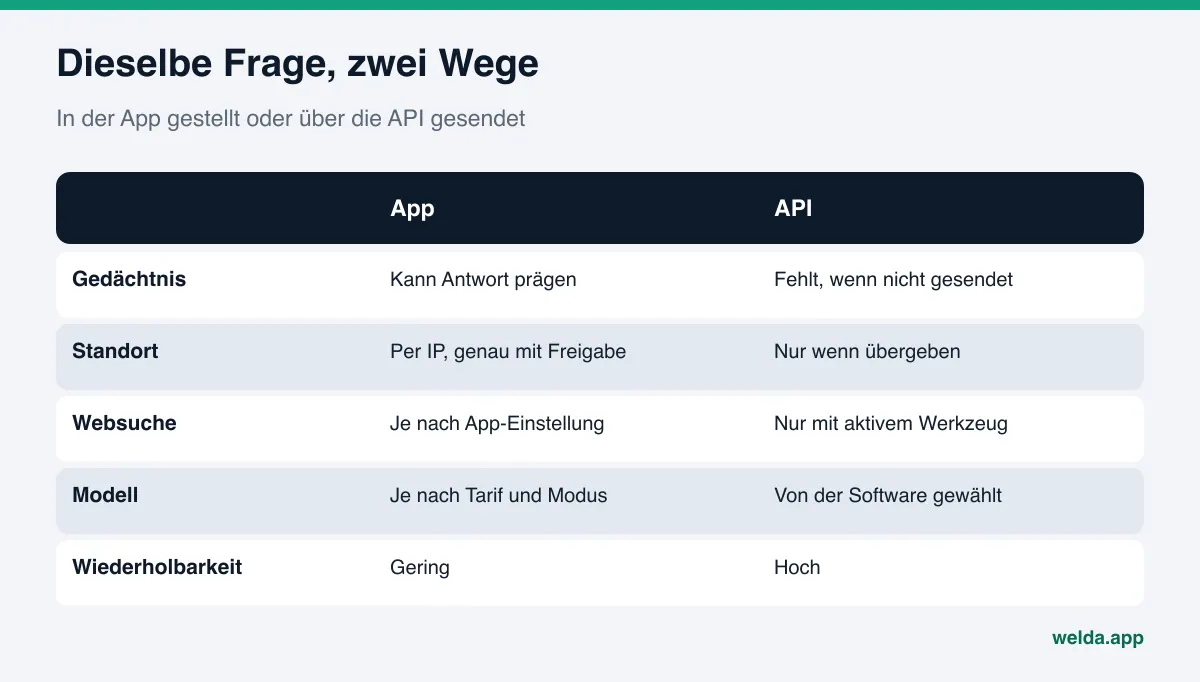
Die Tabelle fasst Stärken und Schwächen beider Wege aus Sicht eines Betriebs zusammen. Es geht nicht um einen Sieger, sondern darum, welcher Weg welche Frage beantwortet.
| Aspekt | Frage in der App | Frage über die API |
|---|---|---|
| Wessen Blick | Konto, Gerät und Standort der fragenden Person | Die von der Software festgelegten Bedingungen |
| Gedächtnis und Verlauf | Kann die Antwort prägen, wenn aktiv | Fehlt, sofern nicht mitgeschickt |
| Standort | Ungefähr per IP, genau mit Freigabe | Ungefähr, nur wenn übergeben |
| Websuche | Abhängig von App-Einstellung und Frage | Nur bei aktivem Werkzeug und Modellentscheidung |
| Wiederholbarkeit | Gering; Bedingungen ändern sich | Hoch; Bedingungen lassen sich fixieren |
| Umfang | Wenige Fragen von Hand | Viele Fragen, regelmäßig |
| Bester Einsatz | Eine echte Kundenerfahrung stichprobenartig prüfen | Trends und Vergleiche verfolgen |
Die Schlussfolgerung ist einfach. Eine Frage in der App ist eine Stichprobe, keine Messung. Eine Frage über die API eignet sich besser zum Messen, entfernt sich aber von der Realität, wenn die Bedingungen nicht realistisch gesetzt sind. Gutes GEO-Tracking (Generative Engine Optimization) liegt dazwischen: feste Bedingungen, nah an der echten Kundenfrage und am echten Ort.
So lesen Sie die Antwort in Ihrer App richtig
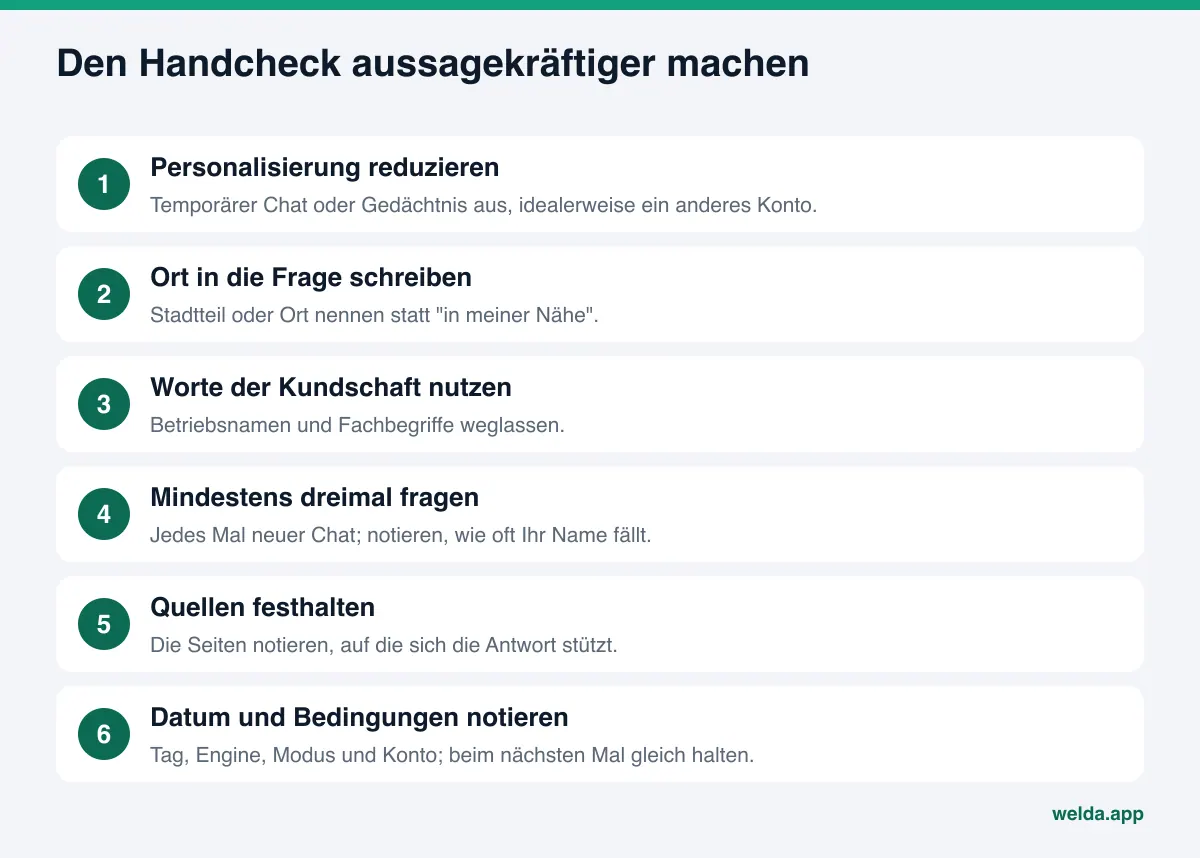
Ein Check vom eigenen Smartphone ist erlaubt, er muss nur sauber aufgesetzt sein. Diese Schritte nehmen so viel persönliche Vorgeschichte wie möglich heraus.
- Personalisierung reduzieren. Nutzen Sie in ChatGPT einen temporären Chat oder eine Sitzung ohne Gedächtnis. Wenn möglich, fragen Sie von einem Konto oder Gerät, das Ihren Betrieb nie gesucht hat.
- Den Ort in die Frage schreiben. Statt "in meiner Nähe" nennen Sie Stadtteil oder Ort: "in München-Schwabing" oder "in Graz-Lend". So richtet sich die Antwort nach dem Ort in der Frage, nicht nach dem Standort Ihres Geräts. Das ist besonders wichtig, wenn Sie aus dem eigenen Betrieb heraus fragen.
- Die Worte der Kundschaft verwenden. Lassen Sie Ihren Betriebsnamen, Fachbegriffe und eigene Leistungsnamen weg. Fragen Sie so, wie Kundschaft fragen würde: "Kannst du ein familienfreundliches Hotel mit Pool am Bodensee empfehlen?"
- Mindestens dreimal fragen. Jedes Mal einen neuen Chat öffnen. Notieren Sie, wie oft Ihr Name in den drei Antworten vorkommt und an welcher Stelle.
- Quellen festhalten. Prüfen Sie, welche Seiten die Antwort nennt: Google Unternehmensprofil, Jameda, Gelbe Seiten, ProvenExpert, Trustpilot oder ein Branchenverzeichnis? Diese Liste zeigt, wo Sie fehlen.
- Datum und Bedingungen notieren. Tag, Engine, Modus, Konto. Ohne dieselben Bedingungen beim nächsten Mal sind zwei Ergebnisse nicht vergleichbar.
Diese Schritte machen einen Handcheck aussagekräftiger, aber sie machen keine Messung daraus. Drei Fragen dreimal gestellt ergeben neun Antworten, mit vier Engines sind es sechsunddreißig. Für eine regelmäßig verfolgte Fragenliste reicht der Handbetrieb schnell nicht mehr. Welche Fragen sich eignen, lesen Sie im Beitrag Prompts für KI-Sichtbarkeit tracken.
API- und App-Antworten im KI-Tracking sauber handhaben
Den Unterschied können Sie nicht beseitigen. Keine Messmethode bildet die persönliche Sitzung jeder Nutzerin und jedes Nutzers nach. Sie können aber seine Wirkung verkleinern und Ergebnisse mit diesem Wissen lesen. Vier Regeln helfen.
Erstens: das Fragenset festlegen. Schreiben Sie die Fragen auf, die Kundschaft tatsächlich stellt, und lassen Sie sie zwischen den Messungen unverändert. Neue Fragen kommen in festen Abständen hinzu, mit Datum.
Zweitens: jede Frage mehrfach stellen. Eine einzelne Antwort ist ein Münzwurf. Drei Wiederholungen zeigen, wie stabil ein Betrieb bei dieser Frage erscheint, und die Streuung zwischen ihnen ergibt die Fehlermarge. Mehr dazu im Beitrag zu Schwankungen im KI-Sichtbarkeits-Tracking.
Drittens: jede Engine einzeln lesen. ChatGPT, Gemini, Perplexity und Google AI stützen sich auf unterschiedliche Quellen. Vier Engines in einer Zahl sind bequem, verdecken aber, wo Sie schwach sind. Zuerst Engine für Engine, dann der Gesamtwert.
Viertens: die Methode im Bericht nennen. Ein Bericht ohne Angabe zu Fragen, Engines, Wiederholungen und Datum ist für Lesende nicht von einem Screenshot zu unterscheiden. Wie ein solcher Bericht aufgebaut wird, steht im Beitrag GEO-Reporting für die Geschäftsführung.
Mit diesen vier Regeln zerstört der Unterschied zwischen API und App die Messung nicht; Sie wissen dann, wofür sie steht. Das Ergebnis ist nicht "der Bildschirm jeder Kundin", sondern "wie oft Ihr Name erscheint, wenn dieselben Fragen unter denselben Bedingungen gestellt werden". Genau das braucht eine Entscheidung. Im englischsprachigen Raum heißt diese Disziplin übrigens oft AEO (Answer Engine Optimization); gemeint ist dieselbe Arbeit.
Wie Welda diese Arbeit macht
Welda setzt auf wiederholte Messung statt auf den einzelnen Screenshot. Zwei Teile davon betreffen dieses Thema direkt.
Die Fragenansicht. Im Welda-Dashboard wird jede Frage, die Kundschaft voraussichtlich stellt, ChatGPT, Gemini, Perplexity und Google AI jeweils dreimal gestellt. In der Fragenansicht gehen Sie Frage für Frage vor: bei welcher Engine Ihr Name erscheint, an welcher Stelle, was die drei Wiederholungen ergeben haben und auf welche Quellen sich die Antwort stützt. Eine Beobachtung wie "gestern war ich bei ChatGPT auf Platz zwei, heute gar nicht" bewerten Sie so anhand von drei Wiederholungen statt einer Antwort. Die Entscheidung, die diese Ansicht ermöglicht: echte Schwachstellen von bloß schwankenden Fragen trennen.
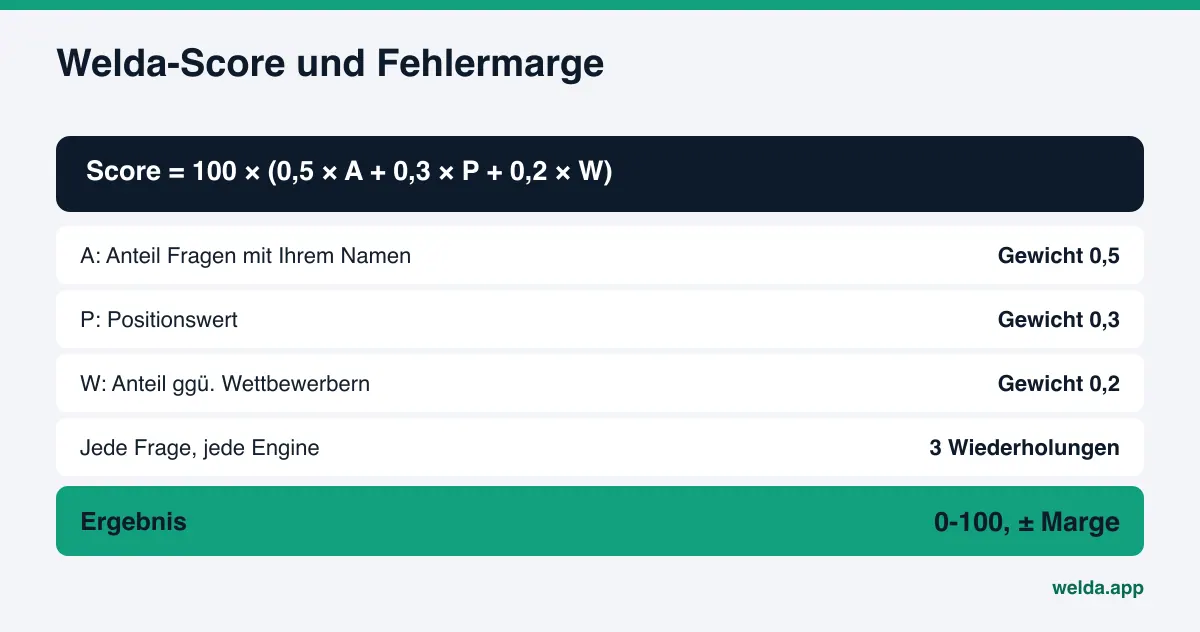
Eine offene Score-Formel mit Fehlermarge. Der Score ist keine Blackbox: 100 × (0,5 × Anteil der Fragen mit Ihrem Namen + 0,3 × Positionswert + 0,2 × Anteil gegenüber Wettbewerbern). Aus der Streuung der drei Wiederholungen ergibt sich eine ± Fehlermarge. Bewegt sich Ihr Score in einem Monat um zwei Punkte und liegt die Marge in derselben Größenordnung, lesen Sie das als Rauschen, nicht als Veränderung. Eine einzelne Antwort auf dem Smartphone erlaubt diese Unterscheidung nicht.
Offen gesagt: Auch Weldas Messung ist eine Methode. Sie bildet nicht den persönlichen Bildschirm einer Person ab, die das Gedächtnis aktiviert und Ihren Betrieb schon gesucht hat; das kann kein Tracking-Werkzeug. Welda zeigt, wie Ihr Name erscheint, wenn dieselben Fragen unter denselben Bedingungen wiederholt werden. Als Fragesprache sind Türkisch und Englisch wählbar.
Darüber hinaus zeigt das Dashboard, bei welchen Themen und über welche Quellen Wettbewerber vorne liegen, welche Seiten KI-Antworten speisen, eine zentrale Aufgabenliste und einen einseitigen Monatsbericht. Um Lücken zu schließen, entwirft Welda Inhalte, Profiltexte und Antworten auf Bewertungen; die Freigabe bleibt beim Betrieb, und Inhalte liegen immer auf der eigenen Website des Betriebs.
Heute für alle nutzbar ist die kostenlose Website-Analyse; sie funktioniert auf Deutsch und Englisch. Sie liest Ihre Website so, wie Google und KI-Systeme sie lesen, stellt außerdem fünf typische Kundenfragen an einen KI-Assistenten mit Websuche und prüft, ob Ihr Betriebsname in den Antworten vorkommt. Das ist eine einmalige Prüfung, kein laufendes Tracking über vier Engines, und sie ersetzt nicht, was Sie in der App sehen. Sie beantwortet aber die erste Frage: Was auf Ihrer Website erschwert es der KI, Sie zu verstehen?
Das vollständige Welda-Dashboard befindet sich im Early Access und startet zunächst in der Türkei. Die regelmäßige Messung über vier Engines kommt im Lauf des Early Access hinzu; Beispielansichten im Dashboard zeigen repräsentative Daten. Preise werden im Early-Access-Gespräch besprochen.
Grenzen und was Welda nicht tut
Wenn der Unterschied zwischen API und App klar ist, wird auch klar, was Sie von einem Tracking-Werkzeug erwarten können und was nicht.
- Kein Abbild persönlicher Bildschirme. Weldas Messung greift nicht auf Konten, Gedächtnis oder Gerätestandorte einzelner Personen zu. Sie läuft unter wiederholbaren, nicht personalisierten Bedingungen.
- Keine Ranking-Garantie und kein Versprechen, "in ChatGPT zu erscheinen". KI-Antworten werden jedes Mal neu erzeugt; kein Anbieter kann zusagen, dass ein Betrieb in jeder Antwort vorkommt.
- Keine erfundenen Angaben. Sind Preis, Öffnungszeiten oder Einzugsgebiet unbekannt, fragt Welda beim Betrieb nach, statt zu raten.
- Keine gefälschten Bewertungen. Bewertungen sind ein Signal, dem KI vertraut. Eine Antwort zu entwerfen ist aber etwas anderes, als eine Bewertung zu schreiben. Welda entwirft nur Antworten.
- Manches bleibt beim Betrieb. Der Umgang mit negativen Bewertungen, Einträge in Verzeichnissen und Pressearbeit bleiben Aufgabe des Betriebs.
- Ergebnisse brauchen Zeit. Neue Inhalte oder ein korrigiertes Profil zeigen sich in KI-Antworten meist erst nach Wochen. Wer am Tag nach einer Änderung auf dem Smartphone nachsieht, wird getäuscht.
Eine Grenze liegt auch in der Methode selbst. Egal welcher Weg: Ein Score ist eine Schätzung dessen, was Kundschaft sieht. Je mehr Fragen, Wiederholungen und feste Bedingungen dahinterstehen, desto verlässlicher ist sie, aber sie ist nie identisch mit dem, was eine bestimmte Person sieht.
Checkliste: Tracking-Ergebnisse richtig lesen
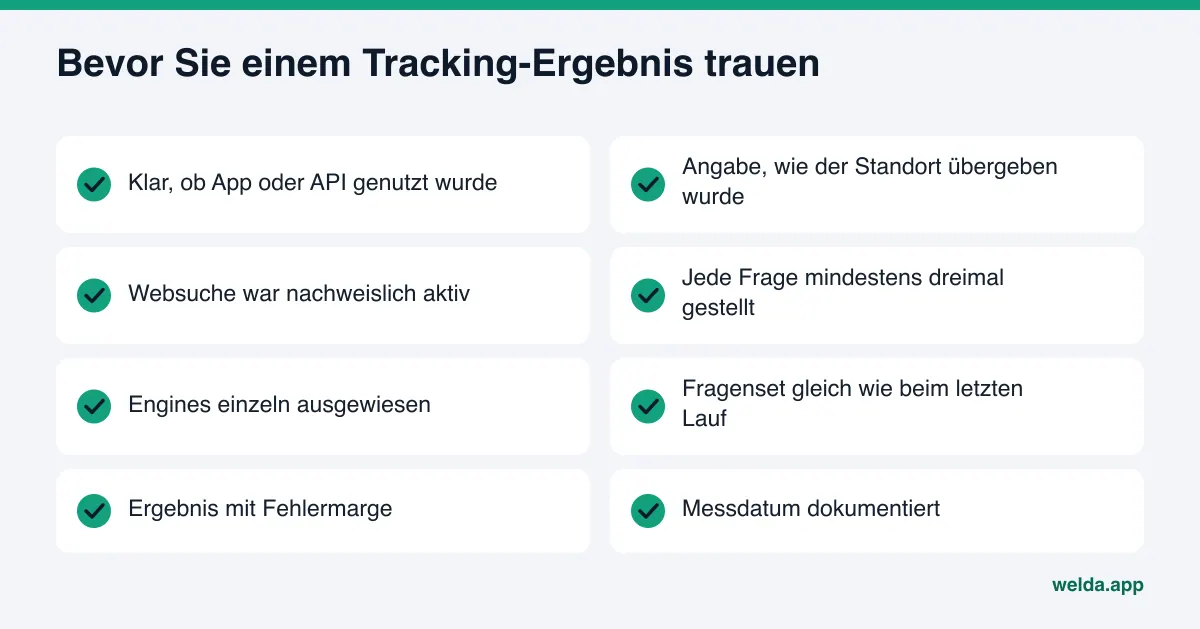
Wenn ein Tracking-Bericht oder ein Screenshot vor Ihnen liegt, stellen Sie diese Fragen der Reihe nach. Jedes "Nein" senkt das Gewicht des Ergebnisses.
| Frage | Warum sie zählt |
|---|---|
| App oder API? | Zeigt, ob Personalisierung die Antwort geprägt hat |
| Wie wurde der Standort angegeben? | Bei lokalen Fragen der stärkste Einzelfaktor |
| War die Websuche aktiv? | Ohne sie fehlen oft aktuelle Infos und lokale Betriebe |
| Wie oft wurde jede Frage gestellt? | Eine Antwort lässt Rauschen wie Veränderung aussehen |
| Werden die Engines einzeln gezeigt? | Ein Gesamtwert kann eine schwache Engine verdecken |
| Ist das Fragenset dasselbe wie zuletzt? | Sonst sind die Ergebnisse nicht vergleichbar |
| Ist eine Fehlermarge angegeben? | Zeigt, ob ein kleiner Unterschied etwas bedeutet |
Nutzen Sie dieselbe Liste für Wettbewerbsvergleiche. "Wettbewerber A ist überall" beruht oft auf einem Versuch, aus einem Konto, zu einem Zeitpunkt. Wie Sie Ihre Position gegenüber Wettbewerbern richtig einordnen, lesen Sie unter Share of Voice in KI-Antworten.
Häufige Fragen
Auf meinem Smartphone nennt ChatGPT meinen Betrieb zuerst. Warum ist der gemessene Wert niedriger?
Die Antwort auf Ihrem Smartphone kann Kontoverlauf, Gedächtnis und Standort enthalten. Haben Sie Ihren Betrieb früher gesucht, nennt die App ihn Ihnen eher. Das Tracking läuft unter wiederholbaren, nicht personalisierten Bedingungen und liegt meist näher an dem, was neue Kundschaft sieht.
Was ist genauer, die API-Antwort oder die App-Antwort?
Beide beantworten unterschiedliche Fragen. Die App-Antwort zeigt die Erfahrung einer Person zu einem Zeitpunkt. Eine feste, wiederholte Messung über eine API zeigt den Trend. Für Entscheidungen zählt der Trend, für das Verständnis einer einzelnen Kundenerfahrung die Stichprobe.
Worauf sollte ich beim Handcheck achten?
Temporären Chat oder Chat ohne Gedächtnis nutzen, den Ort in die Frage schreiben, den Betriebsnamen weglassen, dieselbe Frage mindestens dreimal in neuen Chats stellen und Datum sowie Bedingungen notieren.
Lassen sich KI-Übersichten von Google per API messen?
KI-Übersichten und KI-Modus laufen innerhalb der Google-Ergebnisseite. Eine Antwort aus der Gemini API ist nicht dasselbe Produkt. Ergebnisse auf Google-Seite sollten Sie deshalb immer zusammen mit der verwendeten Methode lesen.
Misst Welda, was ich in meinem eigenen Konto sehe?
Nein. Welda greift nicht auf persönliche Konten, Gedächtnis oder Gerätestandorte zu. Die Fragen werden jeder der vier Engines dreimal gestellt; das Ergebnis zeigt, wie Ihr Name unter wiederholten, gleichen Bedingungen erscheint. Das Dashboard ist im Early Access und startet zunächst in der Türkei.
Entspricht der Test mit fünf Fragen in der kostenlosen Analyse dem, was ich in der App sehe?
Nein. Die Analyse stellt fünf Fragen einmalig an einen KI-Assistenten mit Websuche. Das ist ein erstes Signal zum Zustand Ihrer Website, keine Kopie Ihrer App-Antwort und kein laufendes Tracking.
Fazit: wiederholte Messung statt Screenshots
Der Unterschied zwischen API- und App-Antworten ist kein Fehler, sondern liegt in der Natur von KI-Antworten. Die App kennt Sie, die API kennt nur, was man ihr sagt, und beide erzeugen die Antwort jedes Mal neu. Entscheidungen auf Basis einer Antwort auf dem Smartphone führen in die Irre, ebenso ein "nicht sichtbar" aus einem API-Aufruf ohne Standort und ohne Suche. Ein festes Fragenset, drei Wiederholungen, die Betrachtung Engine für Engine und eine Fehlermarge sind der Weg, mit dem Unterschied umzugehen.
Wenn Sie zuerst sehen möchten, wie KI-Systeme Ihre Website lesen, starten Sie die kostenlose KI-Sichtbarkeitsanalyse. Sie erhalten einen Score auf einer Skala bis 100, zu jeder Lücke den Befund und die Lösung, fertige Textvorschläge für Ihre Startseite und das Ergebnis des KI-Tests mit fünf Fragen.