API cevabı ile uygulama cevabı arasında fark var mı? Evet. Aynı soruyu ChatGPT uygulamasına kendi hesabınızdan sormakla, aynı motora bir yazılım üzerinden (API ile) sormak her zaman aynı cevabı vermez. Hafıza, konum, seçili model, web aramasının açık olup olmaması ve cevabın her seferinde yeniden kurulması bu farkı yaratır. Bu yüzden tek bir ekran görüntüsü de, tek bir API sorgusu da tek başına ölçüm sayılmaz.
Bu yazıda API cevabı ile uygulama cevabı farkının nereden çıktığını, işletme sahibi olarak telefonunuzda gördüğünüz cevabı nasıl okumanız gerektiğini, ölçümü bu farka rağmen nasıl güvenilir tutacağınızı ve Welda'nın bu işte neyi yapıp neyi yapmadığını anlatıyoruz. Bugünkü durumunuzu bilmiyorsanız önce sitenizin ücretsiz AI görünürlük analizini yaptırıp bir başlangıç noktası alabilirsiniz.
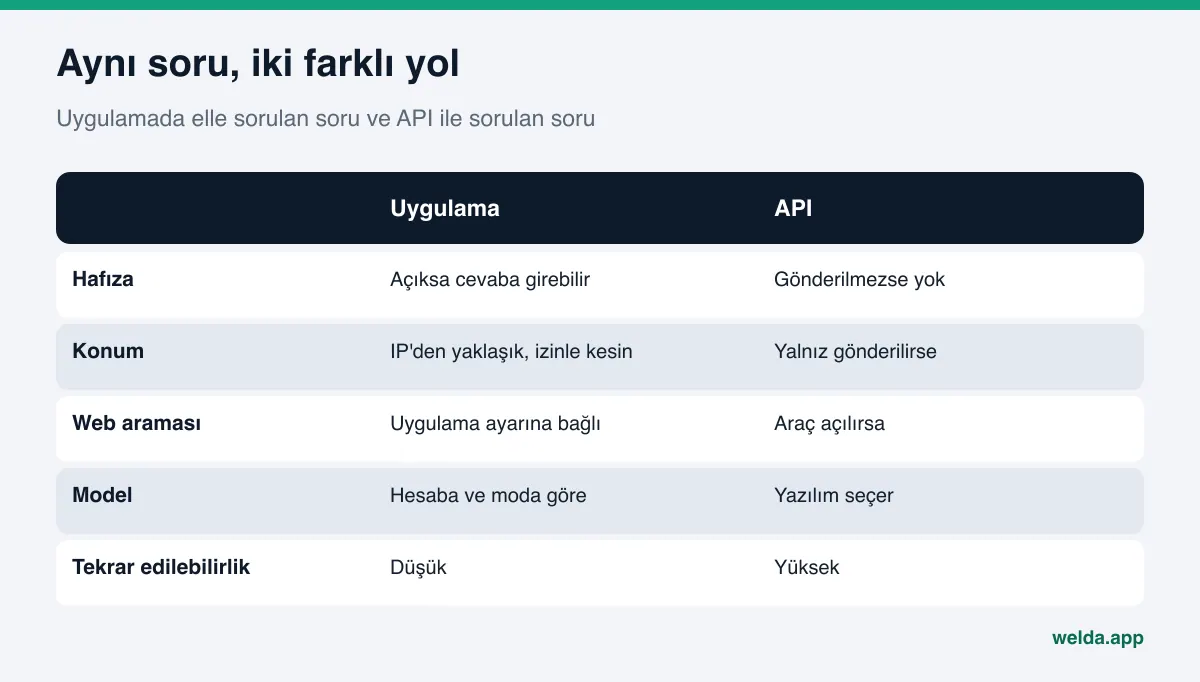
API cevabı ile uygulama cevabı farkı nedir
Bir yapay zeka motoruna iki yoldan soru sorulabilir. Birincisi herkesin bildiği yol: ChatGPT, Gemini ya da Perplexity uygulamasını açar, giriş yaptığınız hesapla soruyu yazarsınız. Google tarafında ise soru arama kutusuna yazılır, cevap AI Bakışı ya da AI Modu olarak arama sayfasında çıkar. İkinci yol yazılımcıların kullandığı yoldur: motoru sunan şirketin programlama arayüzüne, yani API'sine, bir yazılım soru gönderir ve cevabı metin olarak geri alır.
İki yol aynı şirketin modellerini kullanabilir, ama aynı koşulda çalışmaz. Uygulama, sizi tanıyan bir ortamdır: hesabınız, geçmiş sohbetleriniz, cihazınızın konumu, seçtiğiniz model ve uygulamanın kendi talimatları cevabın içine girer. API ise yazılımın gönderdiği şeyle sınırlıdır: hangi model seçildiyse o model, hangi araç açıldıysa o araç, hangi konum bilgisi verildiyse o konum. Bir şey gönderilmediyse cevapta da yoktur.
Sonuç olarak "ChatGPT ne diyor?" sorusunun tek bir cevabı yoktur. ChatGPT, kimin sorduğuna, nereden sorduğuna, hangi modda sorduğuna ve o anki aramada hangi kaynakları okuduğuna göre farklı şey söyleyebilir. Yapay zeka görünürlüğünü ölçerken bu farkı bilmek, yanlış alarmdan da yersiz rahatlıktan da korur.
Fark nereden çıkar: altı etken
API cevabı ile uygulama cevabı arasındaki farkın kaynakları aşağıda. Hepsi her motorda aynı ağırlıkta değildir; ama yerel bir işletme için ilk üçü genellikle en belirleyici olanlardır.
- Hafıza ve kişiselleştirme. ChatGPT uygulamasında hafıza açıksa, kaydedilmiş bilgiler ve geçmiş sohbetler cevabı kişiselleştirmek için kullanılabilir. Daha önce bir oteli ya da kliniği sık sık sorduysanız, uygulamanın o işletmeyi size daha kolay anması şaşırtıcı değildir. API'ye giden bir soruda bu geçmiş yoktur.
- Konum. OpenAI'ın ChatGPT arama yardım sayfası, uygulamanın yerel sonuçlar için IP adresinden çıkarılan yaklaşık konumu kullanabildiğini, isteğe bağlı olarak da cihazın kesin konumunu paylaşmanın mümkün olduğunu anlatır. API tarafında ise konum ancak yazılım gönderirse vardır: OpenAI'ın web araması geliştirici belgesi ülke, şehir, bölge ve saat dilimiyle yaklaşık bir konum verilebildiğini söyler. "Yakınımdaki" diye başlayan bir soruda bu fark cevabı tamamen değiştirebilir.
- Web aramasının açık olup olmaması. API'de web araması bir araçtır ve istekte açılması gerekir. Açıldığında bile modelin aramaya gidip gitmeyeceğine soruya bakarak kendisi karar verir. Google'ın Gemini API arama belgesi de aynı mantığı anlatır: Google Arama aracı istekte tanımlanır, model aramanın cevabı iyileştirip iyileştirmeyeceğini kendisi değerlendirir. Arama kapalı bir sorguda motor yalnız eğitim verisinden konuşur; bu da güncel bilgisi olmayan, çoğu zaman yerel işletmeleri hiç anmayan bir cevap demektir.
- Seçili model ve mod. Uygulamada hesap türüne ve seçtiğiniz moda göre farklı bir model çalışabilir. API'de model adını yazılım belirler. Aynı şirketin iki farklı modeli aynı soruya farklı uzunlukta, farklı kaynak tercihiyle cevap verir.
- Uygulamanın kendi talimatları ve arayüzü. Uygulama cevabı biçimlendirir: harita, kart, kaynak listesi, alışveriş kutusu gibi parçalar ekleyebilir. API'den gelen cevap çoğu zaman düz metindir. Bir işletme uygulamada bir harita kartında görünüp API metninde geçmeyebilir ya da tersi olabilir.
- Cevabın her seferinde yeniden kurulması. Koşullar birebir aynı olsa bile motor cevabı her seferinde yeniden yazar. Aynı soruyu art arda sorduğunuzda bir işletme ikinci sıradan dördüncü sıraya düşebilir ya da listeden çıkabilir. Bu oynama hem uygulamada hem API'de vardır.
Google'ın AI Bakışı ve AI Modu için ayrıca bir not: bunlar arama sayfasının içinde çalışan özelliklerdir. Gemini API ile alınan bir cevap, arama sayfasında aynı soruya çıkan AI Bakışı'yla aynı ürün değildir. Biri sizin konumunuzu, arama dilinizi ve arama sonuçlarını kullanır; diğeri yazılımın gönderdiği bilgiyle sınırlıdır.
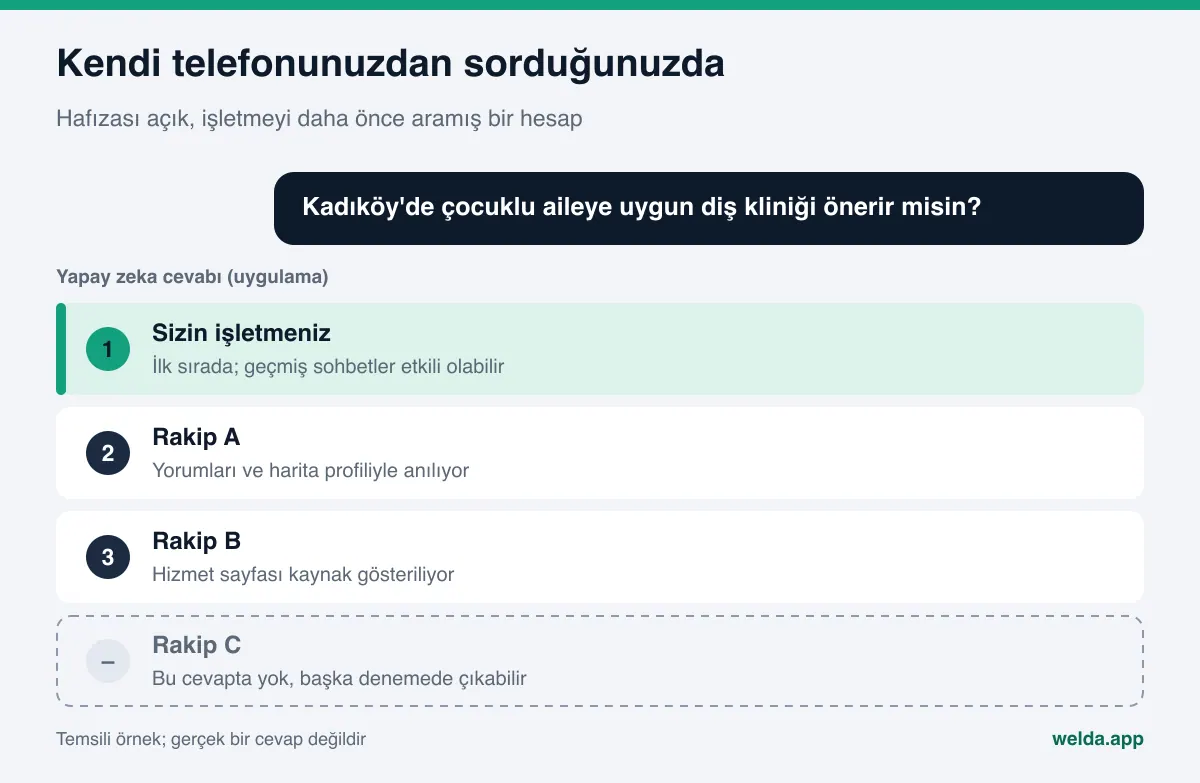
Bu fark işletme sahibi için neden önemli
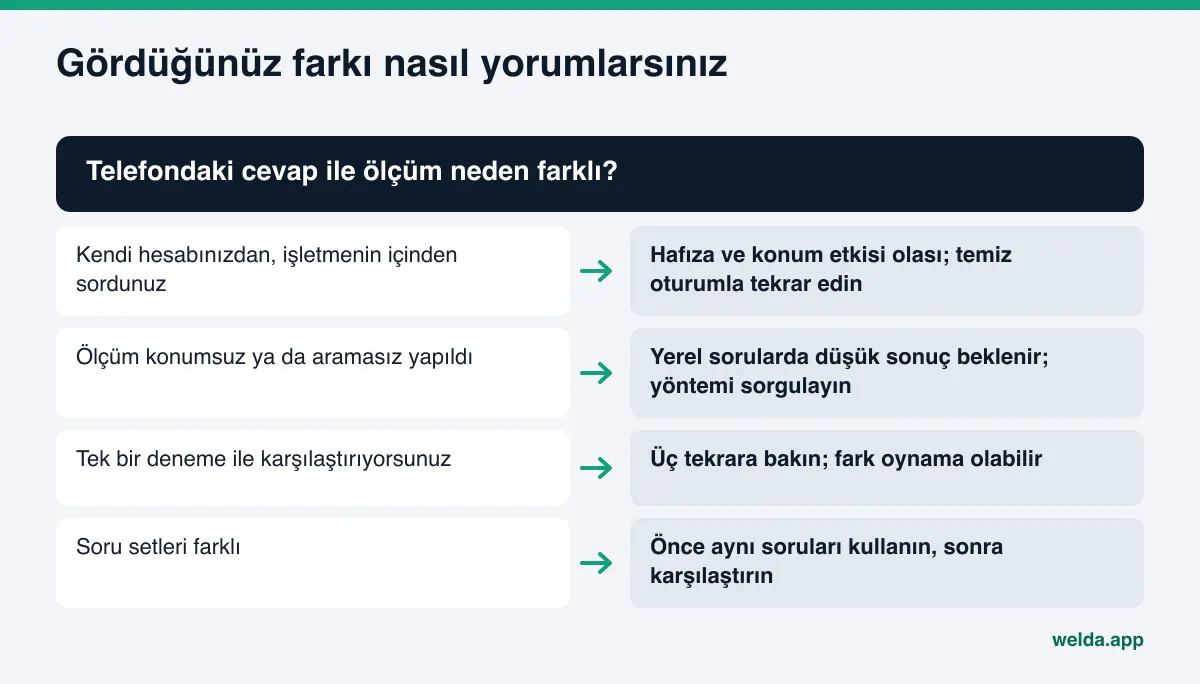
En sık görülen durum şudur: işletme sahibi kendi telefonundan "Bölgemde en iyi diş kliniği hangisi?" diye sorar, kendi kliniğini ilk sırada görür ve rahatlar. Oysa o telefon kliniğin içindedir, hesap sahibi kliniği defalarca aramıştır, belki web sitesini de sohbette paylaşmıştır. Gördüğü cevap, kliniği hiç duymamış ve şehrin öbür ucundan soran bir hastanın göreceği cevap değildir.
Tersi de olur. Bir ajans ya da danışman API üzerinden toplu sorgu çalıştırır, işletmenin adı hiçbir cevapta geçmez ve rapor "görünmüyorsunuz" der. Ama sorgular konumsuz gönderilmiş, web araması kapalı kalmış olabilir. Bu durumda yerel bir işletmenin hiçbir cevapta geçmemesi beklenen bir sonuçtur ve gerçek müşterinin ne gördüğünü anlatmaz.
İki hatanın da maliyeti var. Birincisinde işletme yapması gereken işi ertelemiş olur: işletme bilgisi eksik kalır, rehber sitelerindeki eski telefon numarası düzeltilmez. İkincisinde gereksiz bir telaşla yanlış işe bütçe harcanır. Ölçümün amacı, müşterinin genel olarak ne gördüğüne mümkün olduğunca yakın, tekrar edilebilir bir resim çıkarmaktır. Bunun için hangi yolun neyi gösterdiğini bilmek gerekir.
Bir de karşılaştırma sorunu var. Geçen ay uygulamadan, bu ay API'den bakıp iki sonucu yan yana koyarsanız aradaki farkın ne kadarının gerçek değişim, ne kadarının yöntem değişikliği olduğunu ayıramazsınız. Ölçümün ilk kuralı, yöntemi sabit tutmaktır.
Bir örnekle somutlaştıralım. Örnek bir butik otelin sahibi, resepsiyondaki bilgisayardan "Yalıkavak'ta denize yakın sessiz otel" diye sorar ve oteli ikinci sırada görür. Aynı akşam İzmir'deki bir arkadaşı, bu oteli hiç aramamış kendi hesabından aynı soruyu sorar; otel listede yoktur. Üçüncü bir deneme konumsuz ve web araması kapalı bir API sorgusudur; cevap genel bir bölge tanıtımıdır ve hiçbir otelin adı geçmez. Üç cevap da gerçektir, ama üçü de farklı bir koşulun cevabıdır. Karar için gereken, bu üçünün arasında duran, koşulu sabit ve tekrarlı bir ölçümdür.
Hangi yol neyi gösterir: karşılaştırma tablosu
Aşağıdaki tablo, iki yolun güçlü ve zayıf yanlarını iş sorusu açısından özetler. Amaç birini kazanan ilan etmek değil, hangi soru için hangisine bakılacağını netleştirmektir.
| Konu | Uygulamada elle sorulan soru | API ile sorulan soru |
|---|---|---|
| Kimin gözüyle bakar | Sorunun sorulduğu hesabın, cihazın ve konumun | Yazılımın tanımladığı koşulun |
| Hafıza ve geçmiş | Açıksa cevaba girebilir | Yazılım göndermediyse yok |
| Konum | IP'den yaklaşık, izin verilirse kesin | Yalnız gönderilirse, yaklaşık |
| Web araması | Uygulamanın ayarına ve soruya bağlı | Araç açıldıysa, model karar verirse |
| Tekrar edilebilirlik | Düşük; her denemede koşul değişebilir | Yüksek; koşul sabitlenebilir |
| Ölçek | Birkaç soru, elle | Çok sayıda soru, düzenli |
| En iyi kullanım | Gerçek bir müşteri deneyimini örneklemek | Eğilim ve karşılaştırma izlemek |
Tablodan çıkan sonuç basit: uygulamada sorulan soru bir örnektir, ölçüm değildir. API ile sorulan soru ise ölçüme daha uygundur, ama koşulları gerçekçi kurulmazsa müşterinin gördüğünden uzaklaşır. İyi bir ölçüm ikisinin arasında durur: koşulu sabit, ama gerçek müşteri sorusuna ve konumuna yakın.
Uygulamada gördüğünüz cevabı nasıl okumalısınız
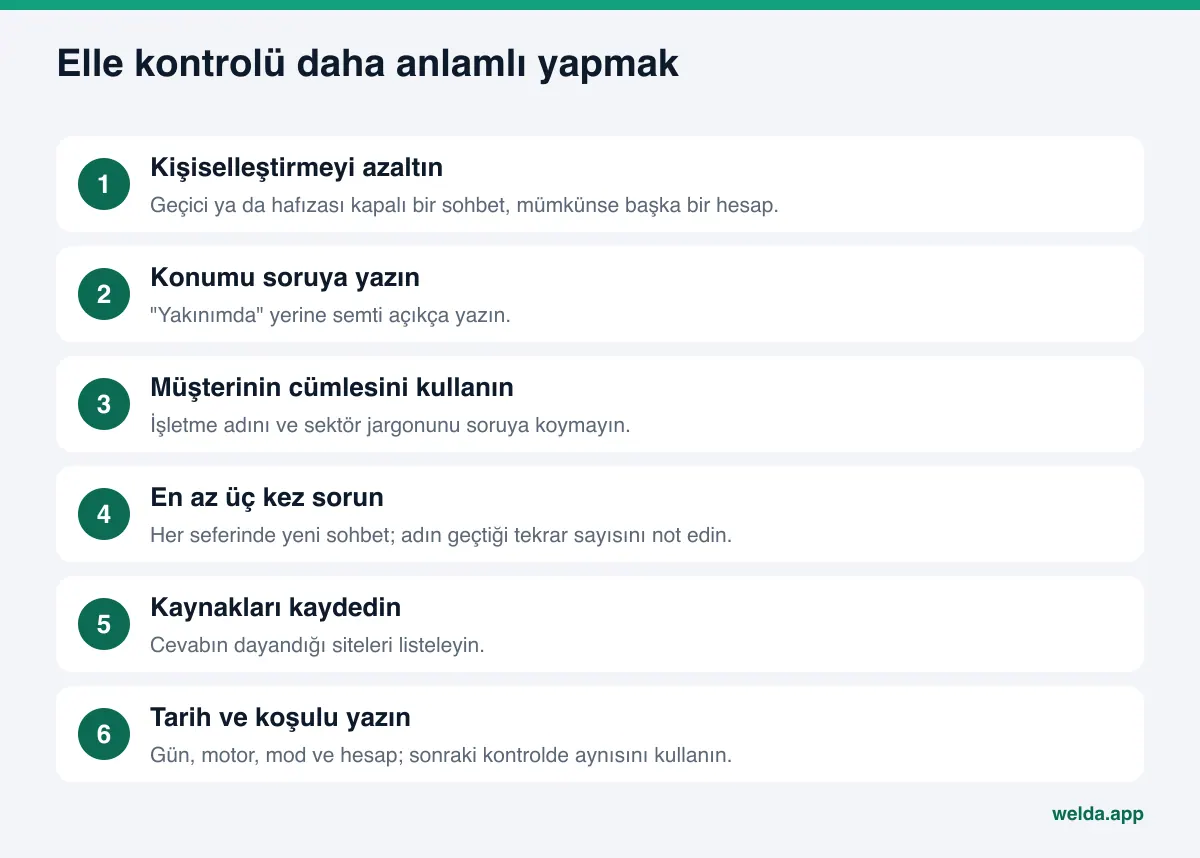
Kendi telefonunuzdan kontrol yapmak yasak değil; sadece doğru kurmak gerekir. Aşağıdaki adımlar, elle yapılan bir kontrolü kişisel geçmişin etkisinden olabildiğince arındırır.
- Kişiselleştirmeyi azaltın. ChatGPT'de geçici sohbet ya da hafızanın kapalı olduğu bir oturum kullanın. Mümkünse işletmeyle hiç ilgilenmemiş bir hesaptan ya da başka bir cihazdan sorun.
- Konumu soruya yazın. "Yakınımda" yerine "Kadıköy'de" ya da "Bodrum Yalıkavak'ta" gibi semti açıkça yazın. Böylece cevap cihazınızın konumuna değil, sorunun içindeki yere göre kurulur. Kliniğin içinden sorarken bu adım özellikle önemlidir.
- Müşterinin cümlesini kullanın. İşletme adını, sektör jargonunu ya da kendi hizmet adınızı soruya koymayın. Müşterinin yazacağı gibi sorun: "Çocuklu aileye uygun, havuzlu butik otel önerir misin?"
- Aynı soruyu en az üç kez sorun. Her seferinde yeni bir sohbet açın. Üç cevapta adınız kaç kez geçiyor, kaçıncı sırada geçiyor, not edin.
- Kaynakları kaydedin. Cevabın altında hangi siteler listeleniyor, bakın. Google İşletme Profili, Google Haritalar, Şikayetvar, Ekşi Sözlük ya da bir sektör rehberi mi? Bu liste, nerede eksik olduğunuzu gösterir.
- Tarih ve koşulu yazın. Hangi gün, hangi motor, hangi mod, hangi hesap. Bir ay sonra aynı koşulla tekrar etmezseniz iki sonucu karşılaştıramazsınız.
Bu adımlar elle yapılan bir kontrolü daha anlamlı yapar, ama onu ölçüme çevirmez. Üç soru üç kez sorulduğunda dokuz cevap çıkar; dört motor eklendiğinde otuz altı. Düzenli izlenecek bir soru listesi için elle yöntem kısa sürede yetmez. Hangi soruların izleneceğini seçmek için takip edilecek soru listesi yazısına bakabilirsiniz.
API cevabı ile uygulama cevabı farkını ölçümde yönetmek
Farkı ortadan kaldırmak mümkün değil. Hiçbir ölçüm yöntemi her kullanıcının kişisel oturumunu kopyalayamaz. Yapılabilecek şey, farkın etkisini küçültmek ve sonucu bu bilgiyle okumaktır. Bunun dört kuralı var.
Birincisi, soru setini sabitleyin. Müşterinin gerçekten soracağı soruları yazılı bir listeye dökün ve ölçümler arasında değiştirmeyin. Yeni soru eklemek gerekiyorsa bunu belli aralıklarla yapın ve hangi tarihte eklendiğini not edin.
İkincisi, her soruyu birden çok kez sorun. Tek cevap bir zar atışıdır. Üç tekrar, bir işletmenin o soruda ne kadar istikrarlı göründüğünü gösterir. Tekrarlar arasındaki sapma, sonucun ne kadar oynayabileceğini, yani hata payını verir. Bu konuyu AI görünürlük ölçümünde hata payı yazısında ayrıntılı anlattık.
Üçüncüsü, motorları ayrı okuyun. ChatGPT, Gemini, Perplexity ve Google AI farklı kaynaklara güvenir. Dört motoru tek bir sayıda birleştirmek kolaydır, ama hangi motorda neyin eksik olduğunu gizler. Önce motor motor bakın, sonra toplam skora.
Dördüncüsü, yöntemi raporda yazın. Bir ölçüm raporu "hangi sorular, hangi motorlar, kaç tekrar, hangi tarih" bilgisini taşımıyorsa okuyan kişi sonucu bir ekran görüntüsünden ayıramaz. Yöneticiye giden raporun nasıl kurulacağını yöneticiye GEO raporu yazısında anlattık.
Bu dört kural uygulandığında API ile uygulama arasındaki fark ölçümü bozmaz; ölçümün neyi temsil ettiği bilinir. Sonuç "her müşterinin ekranı" değil, "aynı koşulda tekrarlanan sorularda adınızın geçme eğilimi" olur. Karar vermek için gereken de budur.
Welda bu işi nasıl yapar
Welda'nın bu konudaki yaklaşımı, tek ekran görüntüsünü değil tekrarlanan ölçümü esas almaktır. İki parçası bu yazının konusuyla doğrudan ilgili.
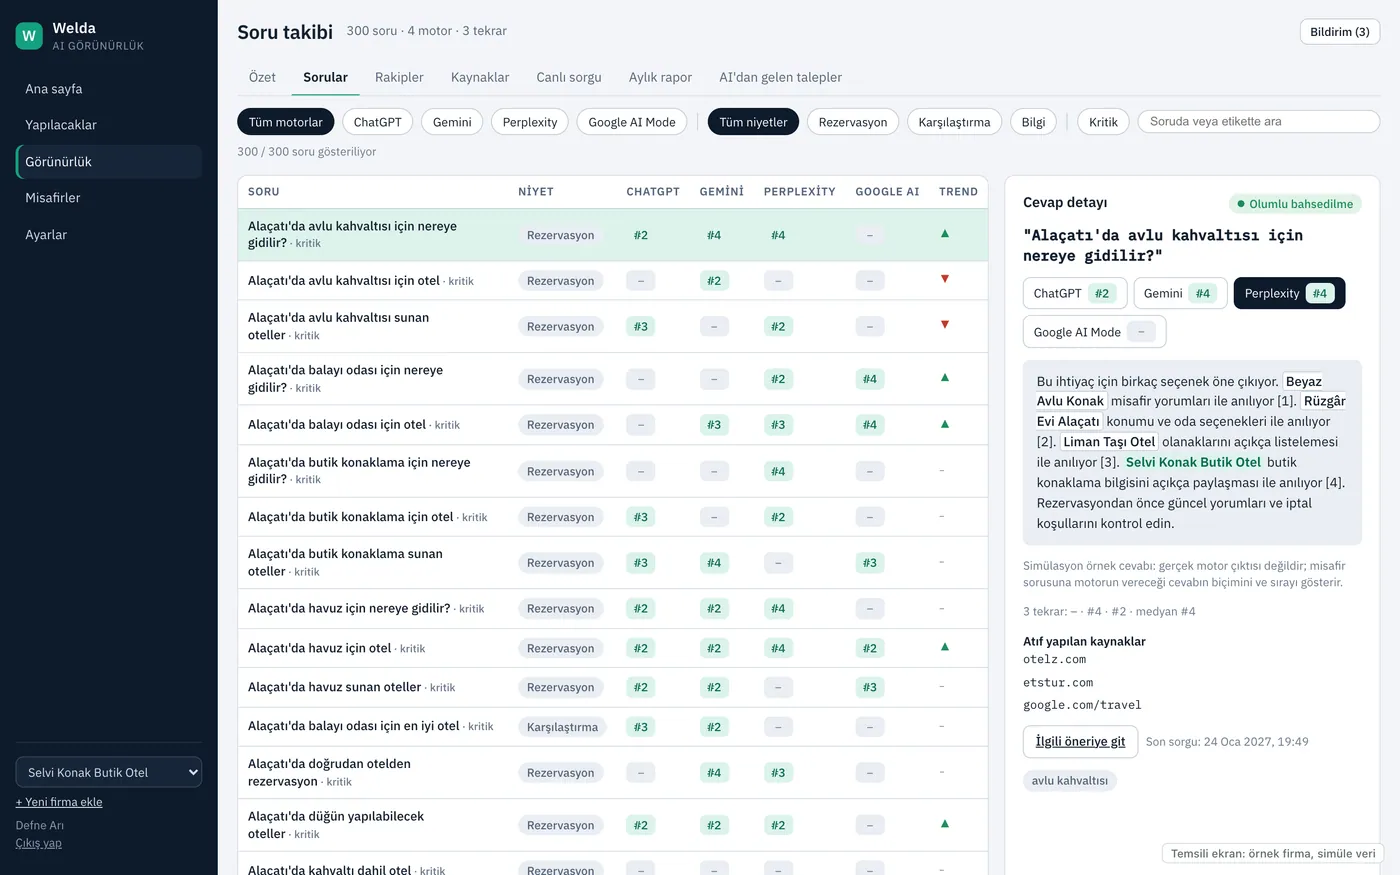
Sorular ekranı. Welda panelinde müşterilerin soracağı her soru ChatGPT, Gemini, Perplexity ve Google AI'a üçer kez sorulur. Sorular ekranında soru soru ilerlersiniz: bu soruda adınız hangi motorda geçiyor, kaçıncı sırada anılıyorsunuz, üç tekrarın sonucu ne, cevap hangi kaynaklara dayanıyor. Bir soruya tıkladığınızda tekrarların tek tek sonucu ve ortanca sıra görünür. Böylece "dün ChatGPT'de ikinciydim, bugün yokum" gibi bir gözlemi tek cevaba değil üç tekrara bakarak değerlendirirsiniz. Bu ekranda vereceğiniz karar, hangi soruların gerçekten zayıf olduğunu ve hangilerinin yalnız oynak olduğunu ayırmaktır.
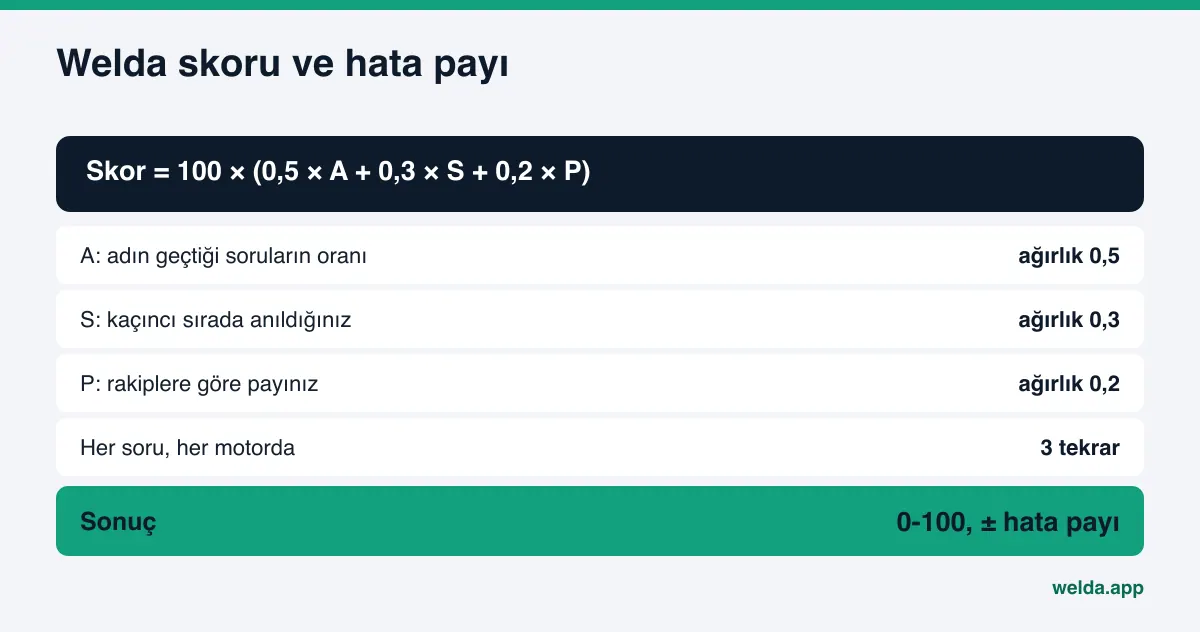
Açık skor formülü ve hata payı. Panel skoru gizli bir puan değildir: 100 × (0,5 × adın geçtiği soruların oranı + 0,3 × sıra puanı + 0,2 × rakiplere göre pay). Üç tekrar arasındaki sapmadan bir ± hata payı hesaplanır. Skorunuz bir ayda iki puan oynadıysa ve hata payı da bu civardaysa, bunu değişim değil gürültü olarak okursunuz. Telefonda gördüğünüz tek bir cevap bu ayrımı yapmanıza izin vermez.
Burada dürüst olmak gerekiyor: Welda'nın ölçümü de bir ölçüm yöntemidir. Hafızası açık, işletmeyi daha önce aramış bir kullanıcının kişisel ekranını birebir kopyalamaz; hiçbir ölçüm aracı bunu yapamaz. Welda'nın sunduğu, aynı sorular aynı koşulda tekrarlandığında adınızın nasıl göründüğüdür. Soru dili Türkçe ya da İngilizce seçilebilir; yabancı misafir alan bir otel iki dilde ayrı soru seti izleyebilir.
Panelde bunların yanında rakiplerin hangi konuda ve hangi kaynaktan önde olduğunu gösteren ekran, yapay zekanın beslendiği kaynakları listeleyen ekran, yapılacaklar listesi ve aylık tek sayfalık rapor da var. Eksikleri tamamlamak için Welda içerik, profil metni ve yorum yanıtı hazırlar; yayın onayı işletmede kalır ve içerik işletmenin kendi sitesinde durur.
Bugün herkesin kullanabildiği parça ücretsiz site analizidir. Analiz sitenizi Google ve yapay zeka gözüyle okur, ayrıca müşterilerin sorabileceği 5 soruyu web araması yapabilen bir yapay zeka asistanına sorar ve cevaplarda işletme adınızın geçip geçmediğine bakar. Bu tek seferlik bir ölçümdür; dört motorlu düzenli takip değildir ve uygulamada gördüğünüz cevabın yerine geçmez. Ama ilk soruyu cevaplar: sitenizde yapay zekanın sizi anlamasını zorlaştıran hangi eksikler var.
Panel erken erişimdedir ve sırayla açılıyor, bugün Türkiye'deki işletmelerle. Dört motorlu düzenli ölçüm erken erişim sürecinde ekleniyor; paneldeki örnek ekranlar temsili veriyle gösterilir. Fiyat erken erişim görüşmesinde konuşulur.
Sınırlar ve Welda'nın yapmadıkları
API ile uygulama arasındaki fark bir kez anlaşıldığında, bir ölçüm aracından ne beklenip ne beklenmeyeceği de netleşir.
- Kişisel ekranı kopyalamaz. Welda tek tek kullanıcıların hesaplarına, hafızalarına ya da cihaz konumlarına erişmez. Ölçüm, kişiselleştirilmemiş ve tekrarlanabilir bir koşulda yapılır.
- Sıralama ya da "ChatGPT'de çıkma" garantisi vermez. Yapay zeka cevapları her seferinde yeniden kurulur; hiçbir hizmet bir işletmenin her cevapta görüneceğini vaat edemez.
- Bilmediği bilgiyi yazmaz. Bir hizmetin fiyatı, çalışma saati ya da hangi semtte hizmet verildiği belli değilse Welda bunu uydurmaz, işletmeye sorar.
- Sahte yorum üretmez. Yorumlar yapay zekanın güvendiği işaretlerden biridir, ama yorum yanıtı hazırlamak ile yorum yazmak farklı işlerdir. Welda yalnız yanıt taslağı hazırlar.
- Bazı işler işletmede kalır. Olumsuz yorumlarla ilgilenmek, dizin ve rehber hesaplarını açmak, basın çalışması işletmenin kendi işidir.
- Sonuç hemen görünmez. Yeni bir içeriğin ya da düzeltilmiş bir profilin yapay zeka cevaplarına yansıması genelde haftalar sürer. Bu yüzden değişiklikten hemen sonra telefondan bakıp sonuç beklemek yanıltıcıdır.
Bir sınır da yöntemin kendisinde. Hangi yöntemle ölçerseniz ölçün, skor müşterinin ekranının bir tahminidir. Bu tahmin ne kadar çok soru, ne kadar çok tekrar ve ne kadar sabit koşulla yapılırsa o kadar güvenilir olur; ama hiçbir zaman tek bir kişinin gördüğüyle birebir aynı değildir.
Karar listesi: ölçüm sonucunu nasıl okursunuz
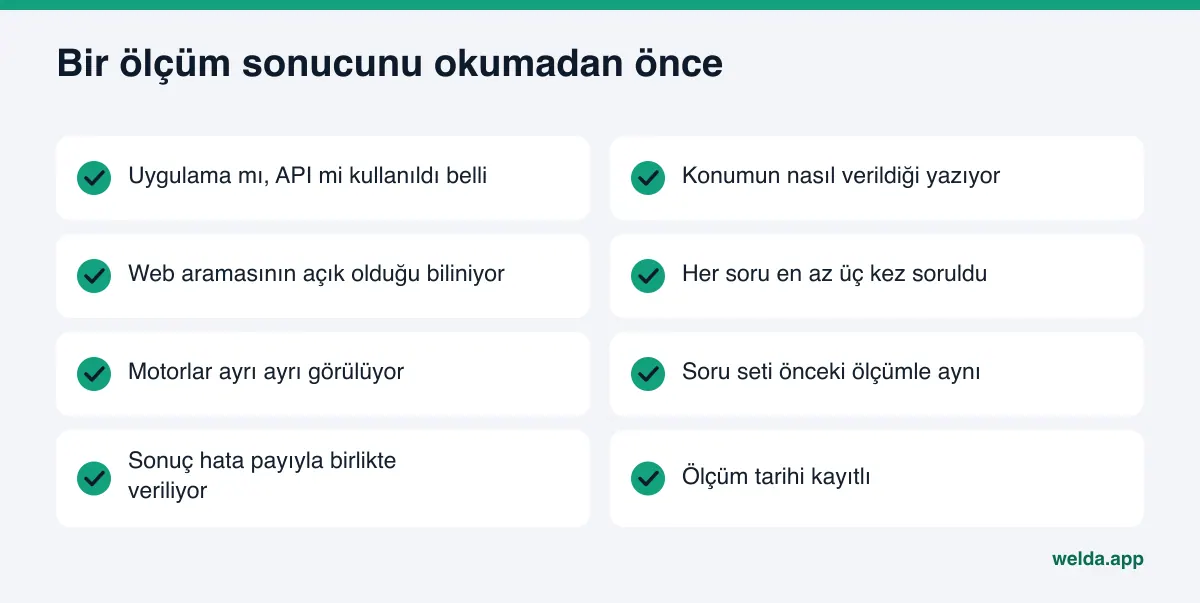
Bir ölçüm raporu ya da bir ekran görüntüsü önünüze geldiğinde şu soruları sırayla sorun. Cevabı "hayır" olan her madde, sonucun güvenilirliğini düşürür.
| Soru | Neden önemli |
|---|---|
| Hangi yolla soruldu: uygulama mı, API mi? | Kişiselleştirmenin cevaba girip girmediğini belirler |
| Konum nasıl verildi? | Yerel sorularda cevabı en çok değiştiren etkendir |
| Web araması açık mıydı? | Kapalıysa güncel bilgi ve yerel işletme cevaba girmeyebilir |
| Her soru kaç kez soruldu? | Tek cevap oynamayı değişim sanmanıza yol açar |
| Hangi motorlar ayrı ayrı görülüyor? | Toplam skor motor bazındaki eksiği gizleyebilir |
| Soru seti önceki ölçümle aynı mı? | Değilse iki sonuç karşılaştırılamaz |
| Hata payı yazıyor mu? | Küçük farkın anlamlı olup olmadığını gösterir |
Bu listeyi rakip karşılaştırmasında da kullanın. "Rakip A her yerde çıkıyor" diyen bir gözlem çoğu zaman tek bir hesaptan, tek bir anda yapılmış bir denemeye dayanır. Rakiplere göre payınızı doğru okumak için yapay zekada ses payı yazısına bakabilirsiniz.
Sık sorulan sorular
Telefonumda ChatGPT beni ilk sırada gösteriyor; neden ölçüm daha düşük çıkıyor?
Telefonunuzdaki cevap hesabınızın geçmişini, hafızasını ve konumunuzu içerebilir. İşletmenizi daha önce aradıysanız uygulamanın sizi anması daha olasıdır. Ölçüm ise kişiselleştirilmemiş, tekrarlanabilir bir koşulda yapılır ve genellikle sizi hiç tanımayan bir müşterinin göreceğine daha yakındır.
API cevabı mı daha doğru, uygulama cevabı mı?
İkisi farklı soruların cevabıdır. Uygulama cevabı tek bir kişinin o andaki deneyimini gösterir. API ile yapılan, koşulu sabit ve tekrarlı bir ölçüm ise eğilimi gösterir. Karar vermek için eğilim, bir müşterinin deneyimini anlamak için örnek cevap işe yarar.
Elle kontrol yaparken nelere dikkat etmeliyim?
Geçici ya da hafızası kapalı bir sohbet kullanın, konumu soruya açıkça yazın, işletme adını soruya koymayın, aynı soruyu yeni sohbetlerde en az üç kez sorun ve tarih ile koşulu not edin.
Google AI Bakışı'nı API ile ölçmek mümkün mü?
AI Bakışı ve AI Modu arama sayfasının içinde çalışan özelliklerdir. Gemini API ile alınan bir cevap bu özelliklerle aynı ürün değildir. Bu yüzden Google tarafındaki ölçüm sonuçlarını yöntemiyle birlikte okumak gerekir.
Welda benim hesabımda gördüğüm cevabı mı ölçüyor?
Hayır. Welda kişisel hesaplara, hafızaya ya da cihaz konumuna erişmez. Sorular dört motora üçer kez sorulur ve sonuç, aynı koşulda tekrarlandığında adınızın nasıl göründüğünü gösterir. Panel erken erişimdedir; dört motorlu düzenli ölçüm bu süreçte ekleniyor.
Ücretsiz analizdeki 5 soru testi uygulamadaki sonuçla aynı mı?
Değil. Analiz, 5 soruyu web araması yapabilen bir yapay zeka asistanına bir kez sorar. Bu, sitenizin genel durumunu anlamak için bir başlangıç işaretidir; uygulamada kendi hesabınızla gördüğünüz cevabın kopyası ya da düzenli bir takip değildir.
Sonuç: ekran görüntüsü değil, tekrarlanan ölçüm
API cevabı ile uygulama cevabı farkı bir kusur değil, yapay zeka cevaplarının doğası. Uygulama sizi tanır, API yalnız kendisine söyleneni bilir; ikisi de her seferinde cevabı yeniden kurar. Bu yüzden telefonda görülen tek bir cevapla karar vermek de, konumsuz ve aramasız bir API sorgusuyla "görünmüyorsunuz" demek de yanıltıcıdır. Sabit soru seti, üç tekrar, motor motor okuma ve hata payı bu farkı yönetmenin yoludur.
İlk adım olarak sitenizin yapay zeka gözüyle nasıl okunduğunu görmek isterseniz ücretsiz AI görünürlük analizini başlatın. Sonuçta 100 üzerinden skor, her eksik için ne görüldüğü ve nasıl düzeleceği, hazır metin önerileri ve 5 soruluk yapay zeka testinin sonucu yer alır.