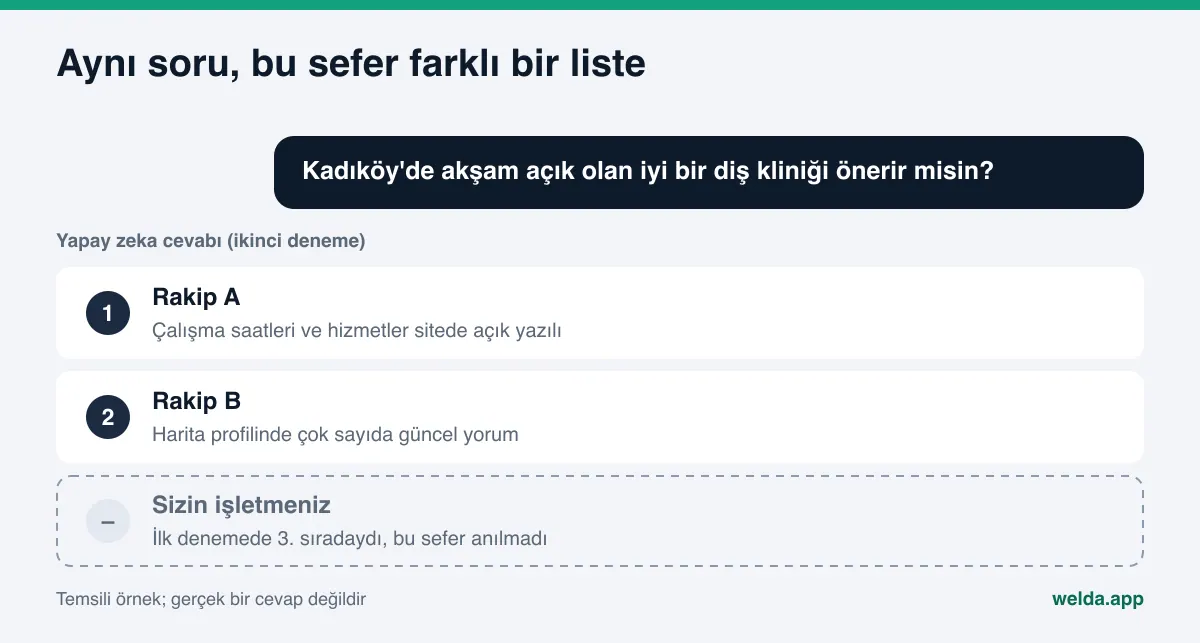
AI görünürlük ölçümünde hata payı nedir? Yapay zeka araçları aynı soruya her seferinde aynı cevabı vermez. Bir gün listede üçüncü sıradasınız, ertesi gün hiç anılmıyorsunuz. AI görünürlük ölçümünde hata payı, bu doğal oynamanın skoru ne kadar yukarı ya da aşağı itebileceğini gösteren aralıktır. Skoru tek sayı olarak değil, "şu kadar, artı eksi şu kadar" diye okursanız gerçek değişimi gürültüden ayırabilirsiniz.
Aynı soru neden her seferinde farklı cevap alıyor?
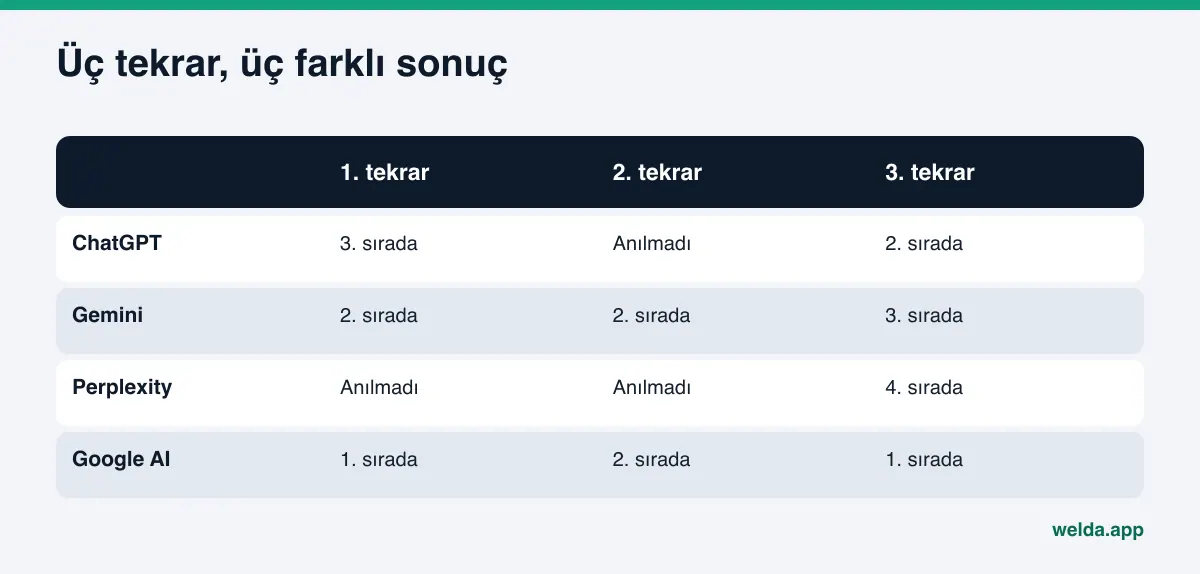
Klasik Google aramasında aynı kelimeyi aynı yerden aradığınızda sonuçlar kısa sürede pek değişmez. Yapay zeka cevaplarında durum farklıdır. ChatGPT, Gemini, Perplexity ya da Google'ın AI Bakışı ve AI Modu bir cevabı her seferinde yeniden üretir. Cevabın iskeleti benzer kalabilir, ama hangi işletmenin anıldığı, kaçıncı sırada anıldığı ve hangi gerekçeyle anıldığı denemeden denemeye değişebilir.
Bunun birkaç nedeni vardır:
- Modelin üretim biçimi: Dil modelleri her kelimeyi bir olasılık dağılımından seçer. Aynı soru, aynı ayarlar bile her zaman aynı metni vermez. Microsoft'un bir dil modeli hizmeti için yazdığı teknik belgede de aynı soruyu birkaç kez sorduğunuzda büyük olasılıkla farklı cevaplar alacağınız ve tekrarlanabilir çıktı ayarının bile tam aynılığı garanti etmediği açıkça yazıyor.
- Web araması: Cevap üretirken web araması yapan motorlar her seferinde biraz farklı sayfalar bulabilir. Kaynak değişince cevaptaki işletme listesi de değişir.
- Soru ifadesi: "Kadıköy'de diş kliniği" ile "Kadıköy'de iyi bir diş kliniği önerir misin" aynı ihtiyacı anlatır, ama farklı cevaplar alabilir.
- Konum, dil ve hesap: Oturum açık bir hesapta, farklı bir şehirden ya da farklı bir dille sorulan soru başka sonuç verebilir.
- Model güncellemeleri: Motorlar zaman zaman güncellenir. Dün geçerli olan davranış bugün değişmiş olabilir.
Bu oynama bir hata değildir, bu sistemlerin doğasıdır. Sorun, oynamayı görmezden gelip tek bir cevabı kesin sonuç gibi okumaktır.
AI görünürlük ölçümünde hata payı bilinmezse ne olur?
Bir işletme sahibinin pratikte yaşadığı durum şöyledir. Pazartesi ChatGPT'ye "semtimde en iyi kahvaltı yeri" diye sorarsınız, adınız ikinci sırada çıkar. Çarşamba aynı soruyu sorarsınız, adınız yoktur. İlk tepki genelde "bir şey bozuldu" olur. Siteyi değiştirmeye, yeni içerik yazmaya, bir ajansla görüşmeye başlarsınız. Oysa değişen bir şey olmayabilir. İki cevap da aynı dağılımın iki ayrı örneğidir.
Tersi de olur. Yeni bir sık sorulan sorular bölümü eklersiniz, ertesi gün adınız çıkar ve "işe yaradı" dersiniz. Belki işe yaramıştır, belki de o gün şanslı bir cevap almışsınızdır. Tek ölçümle bunu bilemezsiniz.
Hata payı bu iki yanılgıyı da önler. Skor 40 ise ve hata payı ±4 ise, ertesi hafta 37 görmek bir düşüş değildir; aralığın içindedir. Ama skor art arda iki ölçümde 48 ve 50 çıkıyorsa, bu artık aralığın dışında kalan ve tekrar eden bir harekettir. (Buradaki sayılar örnektir.) Kararı neye göre verdiğiniz değişir: tek sayıya göre değil, sayı ile aralığın ilişkisine göre.
Bu, ölçümün ne sıklıkla yapılacağıyla da doğrudan ilgilidir. Çok sık ölçüp her oynamaya tepki vermek de, çok seyrek ölçüp gerçek bir düşüşü geç fark etmek de maliyetlidir. Bu dengeyi AI görünürlüğünün ne sıklıkla ölçülmesi gerektiğini anlatan yazıda ayrıca ele aldık.
Kendi sitenizin bugün nerede durduğunu görmek isterseniz ücretsiz site analizi ile başlayabilirsiniz. Analiz sitenizi yapay zeka gözüyle okur, eksikleri sıralar ve müşterilerin sorabileceği beş soruyu web araması yapabilen bir yapay zeka asistanına sorar. Bu tek seferlik bir ölçümdür; bu yazıda anlatılan tekrarlı ölçüm ve hata payı ise paneldeki düzenli takibin parçasıdır.
AI görünürlük ölçümünde hata payı nasıl hesaplanır?
Hata payının mantığı basittir: aynı ölçümü birkaç kez yaparsınız ve sonuçların birbirinden ne kadar uzaklaştığına bakarsınız. Sonuçlar birbirine yakınsa hata payı küçüktür, ölçüm kararlıdır. Birbirinden uzaksa hata payı büyüktür, tek ölçüme güvenmek zordur.
Pratikte bunun için üç şey gerekir:
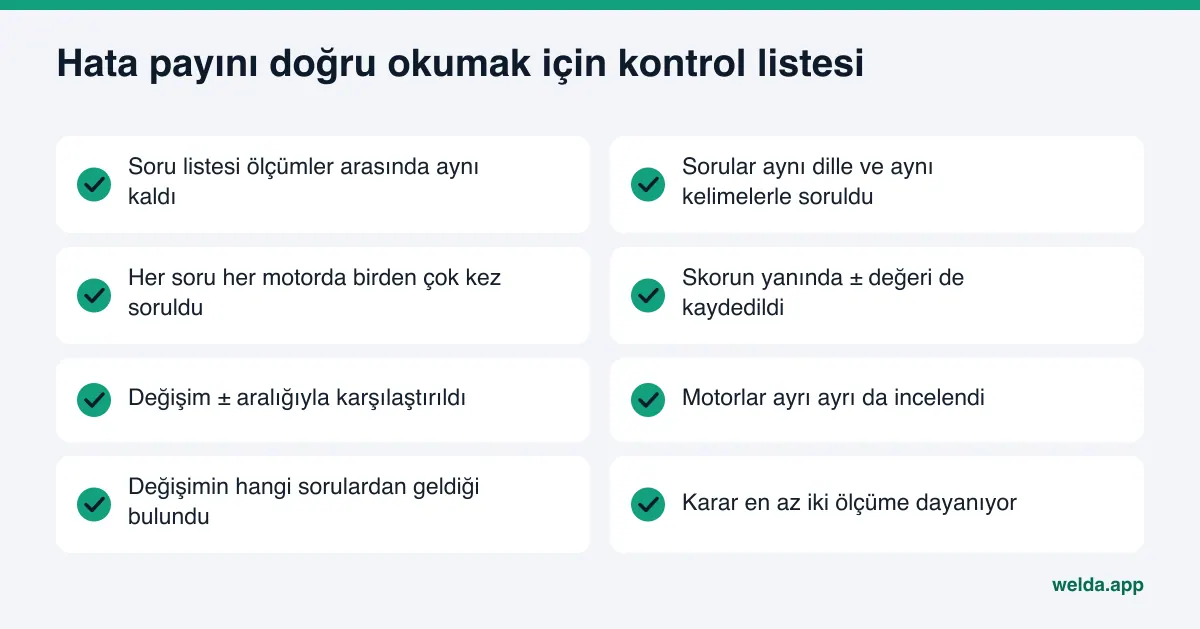
- Sabit bir soru listesi. Ölçümler arasında soruları değiştirirseniz farkın sorudan mı, işletmeden mi geldiğini ayıramazsınız.
- Her soru için birden çok deneme. Bir soruyu bir motorda bir kez sormak tek bir örnektir. Aynı soruyu aynı motorda birkaç kez sormak, o motorun o soruya verdiği cevapların dağılımını gösterir.
- Tekrarların birlikte özetlenmesi. Tekrarların ortalaması ya da ortancası skoru verir; tekrarlar arasındaki sapma da hata payını.
Örnek üzerinden düşünelim. Bir işletme için aynı soru listesi üç kez soruluyor. Birinci turda skor 31, ikincide 27, üçüncüde 29 çıkıyor. (Örnek değerlerdir.) Bu durumda skoru "29" diye tek sayıyla vermek eksik olur. Doğru okuma "yaklaşık 29, birkaç puan aşağı ya da yukarı" şeklindedir. Bir sonraki ölçümde 30 çıkması bir şey söylemez; 38 çıkması ve bunun tekrar etmesi ise bir şey söyler.
Tekrar sayısı arttıkça hata payı daha güvenilir hale gelir, ama her tekrar zaman ve maliyet demektir. Üç tekrar, tek ölçümün yanıltıcılığını büyük ölçüde azaltan ve yine de düzenli yapılabilen bir orta noktadır. Üç tekrarın bir istatistik laboratuvarı kadar kesin olmadığını da bilmek gerekir. Hata payı bir güven aralığı garantisi değil, oynamanın büyüklüğüne dair dürüst bir göstergedir.
Hata payını büyüten ve küçülten etkenler
Her işletmenin hata payı aynı değildir. Bazı işletmeler her denemede benzer sırada anılır, bazıları bir varmış bir yokmuş gibi görünür. Bu farkın nedenleri genelde şunlardır:
| Etken | Hata payını nasıl etkiler? | Ne yapılabilir? |
|---|---|---|
| İşletme hakkında az ve dağınık bilgi | Motor sizi bazen hatırlar, bazen hatırlamaz; sonuçlar oynak olur | Hizmetleri, adresi, çalışma saatlerini sitede açık ve tutarlı yazmak |
| Kaynaklar arasında çelişki | Farklı kaynaklar farklı bilgi verince cevap kararsızlaşır | Google İşletme Profili, site ve rehberlerdeki bilgileri eşitlemek |
| Sınırda bir sıra | Listenin sonundaki işletme bir denemede girer, diğerinde dışarıda kalır | Rakibin hangi konuda önde olduğunu bulup o eksiği kapatmak |
| Geniş, belirsiz soru | Cevaptaki aday sayısı artar, sıralama daha çok oynar | Soru listesine müşterinin gerçek, belirli sorularını koymak |
| Tek motora bakmak | Bir motordaki oynama tüm tabloyu temsil ediyormuş gibi görünür | Motorları ayrı ayrı izleyip birlikte özetlemek |
| Az soru | Tek bir sorudaki oynama skoru büyük oranda etkiler | Soru listesini işletmenin hizmetlerini kapsayacak kadar geniş tutmak |
Buradan çıkan ilginç bir sonuç var: hata payının küçülmesi kendi başına bir iyileşme işaretidir. Bir işletme hakkında yapay zekanın okuyabileceği net, tutarlı ve birden çok kaynakta doğrulanan bilgi arttıkça, motorlar o işletmeyi daha tutarlı biçimde anar. Skor aynı kalsa bile ± değerinin daralması, görünürlüğün daha sağlam bir zemine oturduğunu gösterebilir.
Adım adım: hata payını hesaba katan bir ölçüm düzeni
Elle ya da bir araçla ölçüyor olun, aşağıdaki adımlar hata payını görünür kılar ve yanlış alarmları azaltır.
- Soru listesini yazın ve dondurun. Müşterilerinizin gerçekten sorduğu soruları yazın: hizmet, semt, fiyat aralığı, karşılaştırma ve "hangisi daha iyi" soruları. Listeyi her ölçümde aynı kelimelerle kullanın. Liste değişecekse bunu ayrı bir dönem başlangıcı olarak not edin.
- Ölçüm koşullarını sabitleyin. Aynı dil, mümkünse oturum açılmamış bir ortam, aynı konum bilgisi. Koşul değişirse fark koşuldan da gelebilir.
- Her soruyu her motorda birden çok kez sorun. Her denemede adınızın geçip geçmediğini ve kaçıncı sırada geçtiğini kaydedin. Cevapta atıf yapılan kaynakları da not edin.
- Tekrarları özetleyin. Soru bazında: kaç tekrarda adınız geçti, ortanca sıra neydi. Genel düzeyde: skor ve tekrarlar arasındaki sapma.
- Değişimi aralıkla karşılaştırın. Yeni ölçümdeki fark ± aralığının içinde mi, dışında mı? İçindeyse kayda geçirin ama tepki vermeyin.
- Tekrar eden hareketi arayın. Aralığın dışındaki bir fark bir sonraki ölçümde de sürüyorsa gerçek bir değişim olasılığı yüksektir. O zaman değişimin hangi sorulardan ve hangi motorlardan geldiğine inin.
- Değişimi bir nedene bağlayın. Arada sitede, profilde ya da kaynaklarda ne değişti? Yaptığınız bir düzeltmenin tarihini bilmek, artışın ondan gelip gelmediğini yorumlamayı kolaylaştırır.
Son adım özellikle önemlidir. Bir düzeltmenin etkisini görmek için önce ve sonra ölçümünü aynı soru listesiyle ve aynı tekrar sayısıyla yapmanız gerekir. Bunun ayrıntılarını GEO çalışmasında önce ve sonra ölçümü yazısında anlattık. Yeni içeriğin yapay zeka cevaplarına yansımasının genelde haftalar sürdüğünü de hesaba katın; ertesi günkü ölçüm çoğu zaman bir şey söylemez.
Örnek bir okuma: altı haftalık skor seyri
Bu adımların pratikte nasıl işlediğini görmek için örnek bir butik otelin altı haftalık ölçümünü düşünelim. Otel üçüncü hafta sonunda sitesine oda tipleri, kahvaltı saatleri ve iptal koşullarını anlatan bir sık sorulan sorular bölümü ekliyor. Tablodaki bütün değerler örnektir; gerçek bir işletmeye ait değildir.
| Hafta | Skor | Hata payı | Doğru okuma |
|---|---|---|---|
| 1 | 24 | ±5 | Başlangıç. Aralık geniş, otel bazı sorularda sınırda. |
| 2 | 20 | ±5 | Düşüş gibi görünüyor, ama aralığın içinde. Tepki yok. |
| 3 | 26 | ±4 | Yine aralığın içinde. Sık sorulan sorular bölümü bu hafta eklendi. |
| 4 | 25 | ±4 | Değişiklik yok. Yeni içeriğin yansıması zaman alır. |
| 5 | 33 | ±3 | Aralığın dışında ilk hareket. Not alınır, bir ölçüm daha beklenir. |
| 6 | 35 | ±3 | Hareket sürüyor ve aralık daralıyor. Gerçek değişim olasılığı yüksek. |
Bu örnekte iki yanlış karar kolayca verilebilirdi. İkinci haftada skor 24'ten 20'ye indiğinde panik yapılıp site baştan değiştirilebilirdi; oysa fark hata payının içindeydi. Dördüncü haftada "eklediğimiz bölüm işe yaramadı" denip çalışma bırakılabilirdi; oysa yansıma için henüz erkendi. Doğru okuma, beşinci ve altıncı haftada aralığın dışına çıkan ve tekrar eden hareketi görmek, sonra soru detayına inip artışın gerçekten kahvaltı, iptal ve oda tipiyle ilgili sorulardan gelip gelmediğini kontrol etmektir.
Bir ayrıntıya daha dikkat edin: hata payı da haftalar içinde daralıyor. Bu, motorların oteli denemeler arasında daha tutarlı biçimde anmaya başladığını gösterir. Skor artışı kadar bu daralma da çalışmanın bir çıktısıdır, ve tek sayıya bakan bir ölçüm bunu hiç göstermez.
Welda hata payını nasıl gösterir?
Welda bu işi panelde, düzenli ölçümün içine yerleştirir. Ayrı bir hesap yapmanıza gerek kalmaz; skorun yanında hata payı, soru detayında da tekrarların kendisi görünür. Bu bölümde konuyla doğrudan ilgili üç parçayı anlatıyoruz.
Her soru, her motorda üç kez
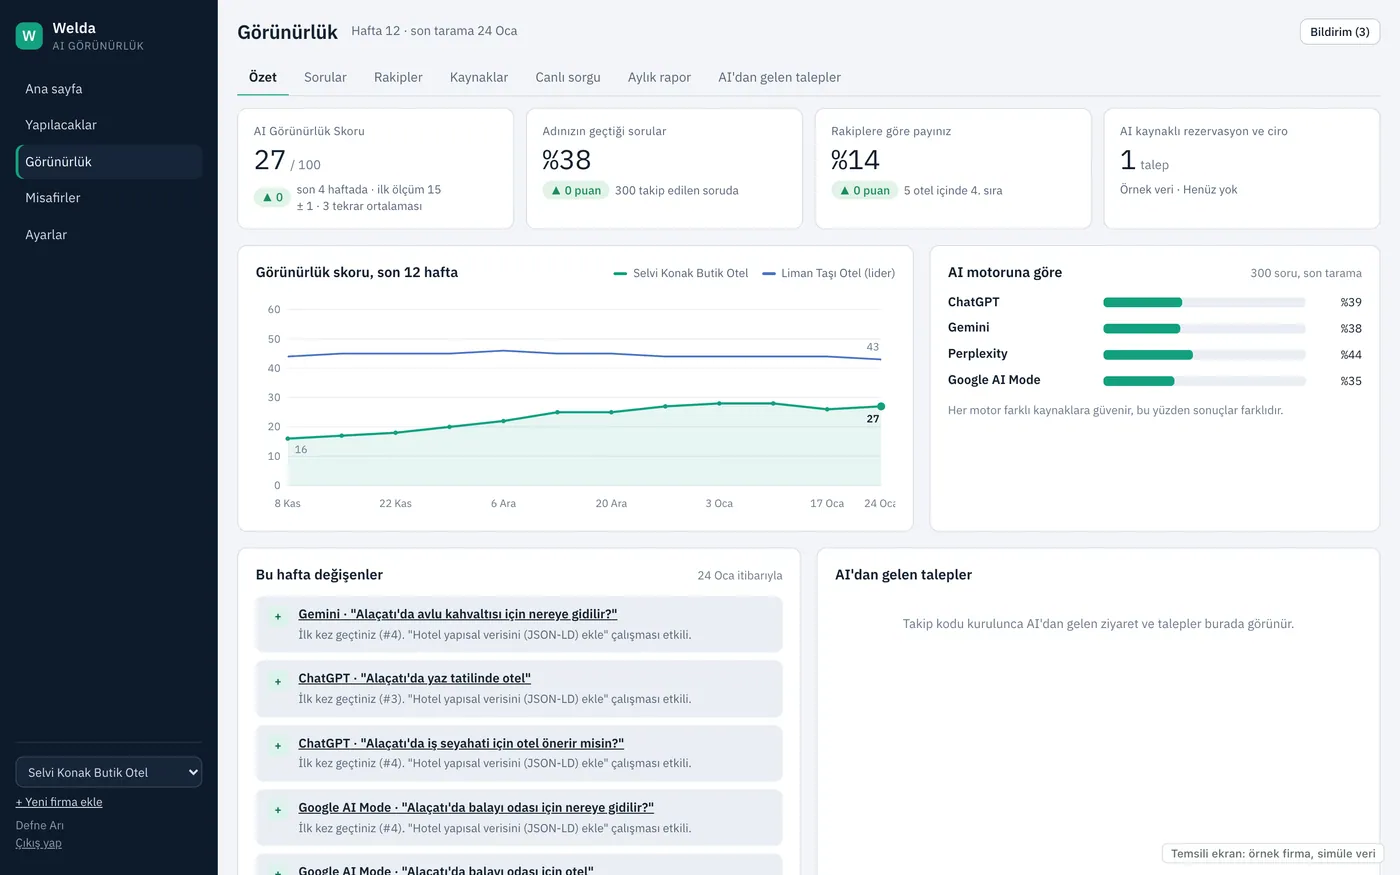
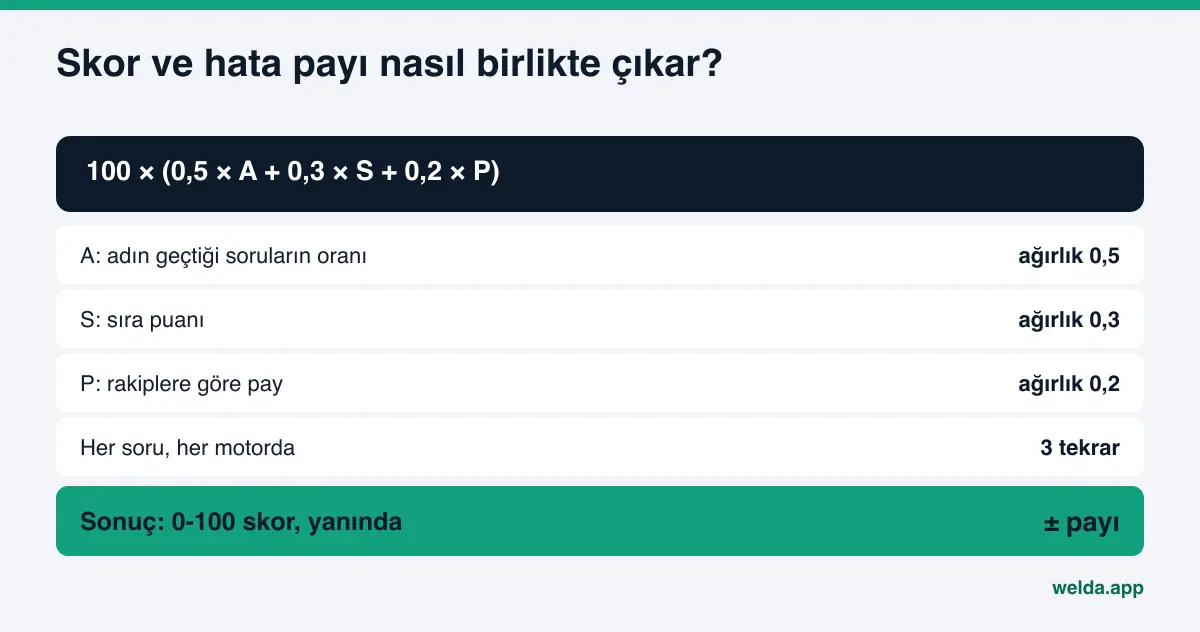
Welda müşterilerinizin soracağı soruları ChatGPT, Gemini, Perplexity ve Google AI'a üçer kez sorar. Yani her soru-motor çifti için tek bir cevap değil, üç cevap toplanır. Skor bu cevaplardan hesaplanır ve formülü açıktır: 100 × (0,5 × adınızın geçtiği soruların oranı + 0,3 × sıra puanı + 0,2 × rakiplere göre pay). Üç tekrar arasındaki sapma da skorun yanında ± olarak yazılır.
Bunun pratik anlamı şudur: Görünürlük ekranındaki skor kartına baktığınızda yalnız "27 / 100" gibi bir sayı görmezsiniz. Yanında ± değerini ve skorun kaç tekrarın ortalaması olduğunu görürsünüz. Haftalık skor çizgisinde bir çentik gördüğünüzde ilk sorunuz "bu ± içinde mi" olur. İçindeyse bir şey yapmanıza gerek yoktur.
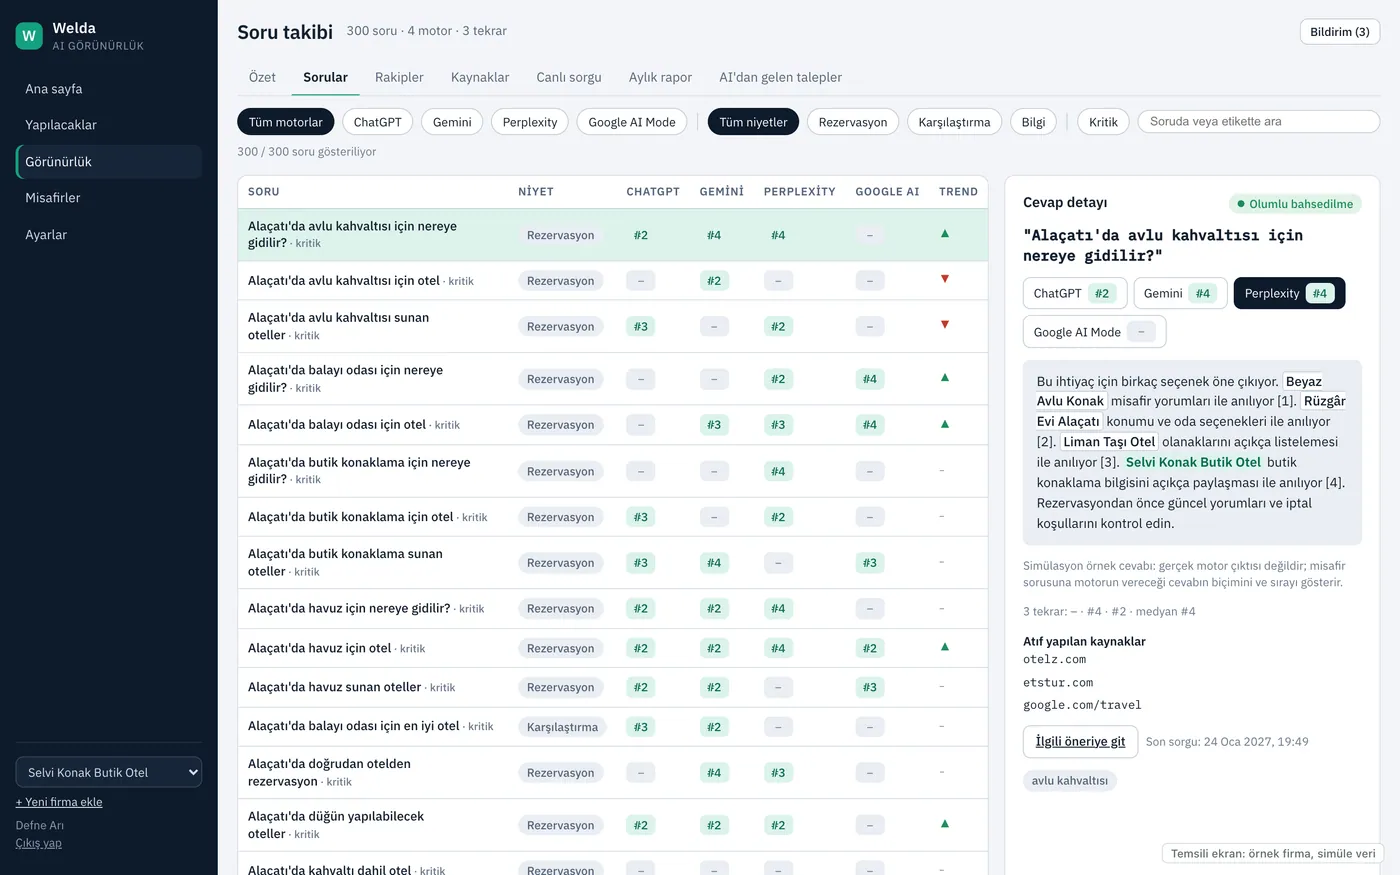
Soru detayında üç tekrar yan yana
Sorular ekranında her soru için dört motordaki durumunuz bir satırda görünür. Bir soruya tıkladığınızda cevap detayı açılır ve üç tekrarın sonucu ayrı ayrı listelenir: örneğin bir tekrarda anılmamış, birinde dördüncü, birinde ikinci sırada. Yanında bu üç sonucun ortancası yazar. Böylece "bu soruda gerçekten zayıf mıyım, yoksa sınırda mıyım" sorusunun cevabını görürsünüz.
Bu ayrım ne iş yapacağınızı değiştirir. Üç tekrarın üçünde de anılmadığınız bir soru net bir eksiktir; o soruyla ilgili bilgiyi sitenize ve profillerinize eklemek gerekir. Üç tekrarın birinde anılmadığınız ama ikisinde üst sıralarda olduğunuz bir soru ise sınırdadır; orada büyük bir değişiklik yerine küçük bir güçlendirme yeterli olabilir. Cevap detayında atıf yapılan kaynaklar da görünür. Bir motorun hangi sitelere dayanarak sizi anıp anmadığını görmek, oynamanın nedenini anlamaya yardım eder.
Değişimin kaynağına inmek
Skor ± aralığının dışına çıktığında panel, değişimin hangi sorulardan ve hangi motordan geldiğini görmenizi sağlar. Haftanın değişenleri listesi, bir soruda ilk kez anılmaya başladığınızı ya da bir soruda düştüğünüzü gösterir. Rakipler ekranı, rakibin hangi konuda ve hangi kaynaktan önde olduğunu gösterir. Bu iki bilgi birleşince "skor neden değişti" sorusu "hangi soruda, hangi motorda, hangi kaynak yüzünden" sorusuna dönüşür. Rakip tarafını daha ayrıntılı merak ederseniz yapay zekada rakip analizi yazısına bakabilirsiniz.
Welda'nın geri kalan ekranları (yapılacaklar listesi, hazır sayfalar, kaynaklar, aylık rapor) bu ölçümün üzerine kuruludur ve aynı soru listesinden beslenir. Panelin genel yapısını AI görünürlük panosu yazısında ve Welda ürün sayfasında bulabilirsiniz.
Bir not: Welda paneli erken erişimdedir ve sırayla açılmaktadır; bugün Türkiye'deki işletmelerle çalışıyor. Dört motorlu düzenli ölçüm erken erişim sürecinde ekleniyor ve paneldeki örnek ekranlar temsili veriyle gösteriliyor. Bugün herkesin kullanabildiği parça ücretsiz site analizidir. Fiyat erken erişim görüşmesinde konuşulur.
Hata payı neyi söylemez? Sınırlar ve Welda'nın yapmadıkları
Hata payı faydalı bir göstergedir, ama her şeyi açıklamaz. Dürüst bir ölçüm, sınırlarını da söylemelidir.
- Üç tekrar küçük bir örnektir. Üç tekrarın sapması oynamanın büyüklüğü hakkında iyi bir fikir verir, ama kesin bir istatistiksel güven aralığı değildir. Çok oynak bir soruda üç tekrar bile tabloyu tam yakalayamayabilir.
- Hata payı ölçüm anını anlatır. Bir motor güncellendiğinde davranışı tümden değişebilir. O zaman önceki haftaların ± değeri yeni durumu temsil etmez.
- Her müşteri aynı cevabı görmez. Ölçüm belirli bir soru listesiyle ve belirli bir dille yapılır. Gerçek müşteriler farklı hesaplardan, farklı konumlardan, farklı kelimelerle sorar. Skor bir eğilim göstergesidir, her müşterinin ekranının birebir kopyası değildir.
- Ücretsiz analizdeki beş soru tek seferliktir. Analizdeki yapay zeka testi, sitenizin ne durumda olduğunu görmek için iyi bir başlangıçtır, ama tekrarlı değildir ve hata payı vermez. Sonucu bir anlık görüntü olarak okuyun.
- Welda sıralama garantisi vermez. Ne bir sıra ne de "ChatGPT'de çıkma" sözü verir. Hata payını göstermek de zaten bu dürüstlüğün parçasıdır: sonuç oynar ve bunu gizlemek yanıltıcı olur.
- Welda bilmediği bilgiyi yazmaz. Ölçümde bir eksik çıktığında, o eksiği kapatacak bilgiyi işletmeye sorar. Hazırladığı içerik onayınız olmadan yayına çıkmaz ve her zaman sizin sitenizde durur.
- Bazı işler işletmede kalır. Olumsuz yorumlarla ilgilenmek, rehber ve dizin hesaplarını yönetmek, basın çalışması Welda'nın yaptığı işler değildir. Bunların görünürlüğe etkisi ölçümde görünür, ama işin kendisi sizde kalır.
Bu sınırlar ölçümü değersiz kılmaz. Aksine, neyin bilinip neyin bilinmediğini açıkça ayırmak, ölçümün üzerine doğru kararlar kurmayı sağlar.
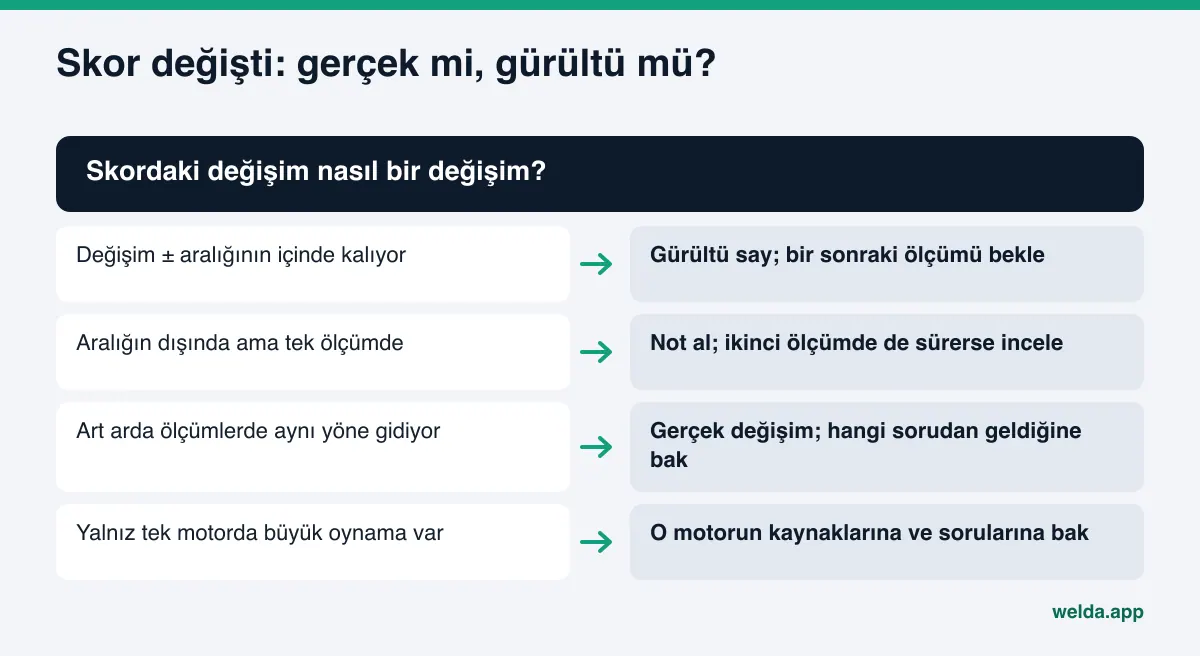
Karar listesi: skordaki bir değişime ne zaman tepki vermelisiniz?
Bir sonraki ölçüm raporunu açtığınızda aşağıdaki soruları sırayla sorun. Hepsine "evet" diyemiyorsanız, büyük bir değişikliğe girişmeden önce bir ölçüm daha beklemek genelde daha doğrudur.
| Soru | Evet ise | Hayır ise |
|---|---|---|
| Soru listesi ve ölçüm koşulları önceki ölçümle aynı mı? | Karşılaştırma anlamlı | Farkı yöntem değişikliğine bağlayın, yeni bir başlangıç sayın |
| Fark ± aralığının dışında mı? | Bir sonraki soruya geçin | Gürültü sayın, not alın |
| Fark art arda en az iki ölçümde sürüyor mu? | Gerçek değişim olasılığı yüksek | Bir ölçüm daha bekleyin |
| Değişimin hangi sorulardan geldiği belli mi? | O sorulara odaklanın | Soru detayına inin, toplam skora değil |
| Değişim tek motorda mı, hepsinde mi? | Tek motorsa o motorun kaynaklarına bakın | Hepsindeyse sitenizdeki ya da profilinizdeki ortak bir değişikliği arayın |
| Arada sizin yaptığınız bir değişiklik var mı? | Tarihi not edin, etkiyi bir sonraki ölçümde doğrulayın | Rakip tarafındaki ya da kaynaklardaki değişikliğe bakın |
Bu liste bir araç seçerken de işe yarar. Bir ölçüm aracı skorun yanında hata payını vermiyorsa, kaç tekrar yaptığını söylemiyorsa ya da formülünü açıklamıyorsa, gördüğünüz haftalık değişimlerin ne kadarının gerçek olduğunu bilemezsiniz. Araç seçerken sorulacak diğer soruları ChatGPT sıralama takip aracı yazısında topladık.
Sık sorulan sorular
Skorum bir haftada 5 puan düştü, endişelenmeli miyim?
Önce hata payına bakın. Düşüş ± aralığının içindeyse büyük olasılıkla ölçüm oynamasıdır. Aralığın dışındaysa ve bir sonraki ölçümde de sürüyorsa, hangi sorulardan ve hangi motordan geldiğine inin.
Neden her soru tek kez değil de üç kez soruluyor?
Çünkü yapay zeka motorları aynı soruya her seferinde aynı cevabı vermez. Tek cevap şanslı ya da şanssız bir örnek olabilir. Üç tekrar hem daha dengeli bir skor hem de oynamanın büyüklüğünü gösteren bir ± değeri verir.
Hata payı küçükse ne anlama gelir?
Motorlar sizi denemeler arasında tutarlı biçimde anıyor ya da tutarlı biçimde anmıyor demektir. Skor yüksekse ve hata payı küçükse görünürlüğünüz sağlam bir zemindedir. Skor düşükse ve hata payı küçükse, eksik nettir ve düzeltme işine oradan başlanabilir.
Kendim elle ölçüm yaparsam hata payını nasıl görürüm?
Aynı soru listesini aynı koşullarda birkaç kez sorun, her denemede adınızın geçip geçmediğini ve sırasını kaydedin. Denemeler arasındaki farkın büyüklüğü size kabaca hata payını verir. Zahmetli bir iştir, ama tek ekran görüntüsüne göre karar vermekten çok daha güvenilirdir.
Ücretsiz analizdeki yapay zeka testi hata payı veriyor mu?
Hayır. Ücretsiz analiz beş soruyu bir kez sorar ve cevaplarda işletme adınızın geçip geçmediğine bakar. Bu tek seferlik bir ölçümdür. Tekrarlı ölçüm ve ± değeri, erken erişimdeki panelin parçasıdır.
Hata payı yüzünden ölçüm sonuçları güvenilmez mi?
Hayır, tersine. Hata payını gösteren bir ölçüm, neyin gerçek değişim neyin oynama olduğunu ayırmanızı sağlar. Güvenilmez olan, oynamayı gizleyip tek bir sayıyı kesin sonuç gibi sunan ölçümdür.
Önce bugünkü durumunuzu görün
Hata payını doğru okumak için önce bir başlangıç noktasına ihtiyacınız var. Ücretsiz site analizi sitenizi Google ve yapay zeka gözüyle okur, eksikleri nedenleri ve çözümleriyle sıralar, hangi düzeltmenin skoru ne kadar artırabileceğini gösterir ve beş soruluk bir yapay zeka testi yapar. Her site için bir kez ücretsizdir; sonuç bağlantısı e-postanıza gelir. Bu tablo, ilerideki tekrarlı ölçümler için sağlam bir ilk referans olur.