Was leistet ein ChatGPT-Ranking-Tracker? Er prüft Frage für Frage, ob ChatGPT und andere KI-Engines Ihr Unternehmen nennen, wenn Kunden die für Sie relevanten Fragen stellen, an welcher Stelle der Antwort Sie auftauchen und wer vor Ihnen genannt wird. Eine einzelne Platzierung wie bei Google gibt es nicht; der Platz in einer KI-Antwort ist eine Reihenfolge von Nennungen, die bei jeder Antwort neu entsteht, und wird erst durch wiederholte Messung belastbar.
Wenn Inhaberinnen und Inhaber fragen "Auf welchem Platz stehe ich bei ChatGPT?", wollen sie meist drei Dinge wissen: Werde ich überhaupt genannt, wie weit vorne, und wer wird an meiner Stelle empfohlen? Klassische SEO-Ranking-Tools beantworten keine dieser Fragen direkt, denn eine KI-Antwort ist ein Text und keine Ergebnisseite. Genau hier setzt GEO (Generative Engine Optimization) an: die Arbeit daran, dass Ihr Unternehmen in den Antworten von ChatGPT, Gemini, Perplexity sowie in Googles KI-Übersichten und im KI-Modus genannt wird. Im englischsprachigen Raum heißt dasselbe oft AEO (Answer Engine Optimization). Dieser Ratgeber erklärt, was "Platzierung" in einer KI-Antwort bedeutet, was ein ChatGPT-Ranking-Tracker messen sollte, wie Sie das Tracking selbst aufbauen und wie Welda diese Arbeit für Ihre KI-Sichtbarkeit erledigt. Wenn Sie zuerst Ihren Ausgangspunkt sehen möchten, zeigt die kostenlose Website-Analyse zur KI-Sichtbarkeit, wie KI-Systeme Ihre Website heute lesen.
Was bedeutet "Platzierung" in einer KI-Antwort?
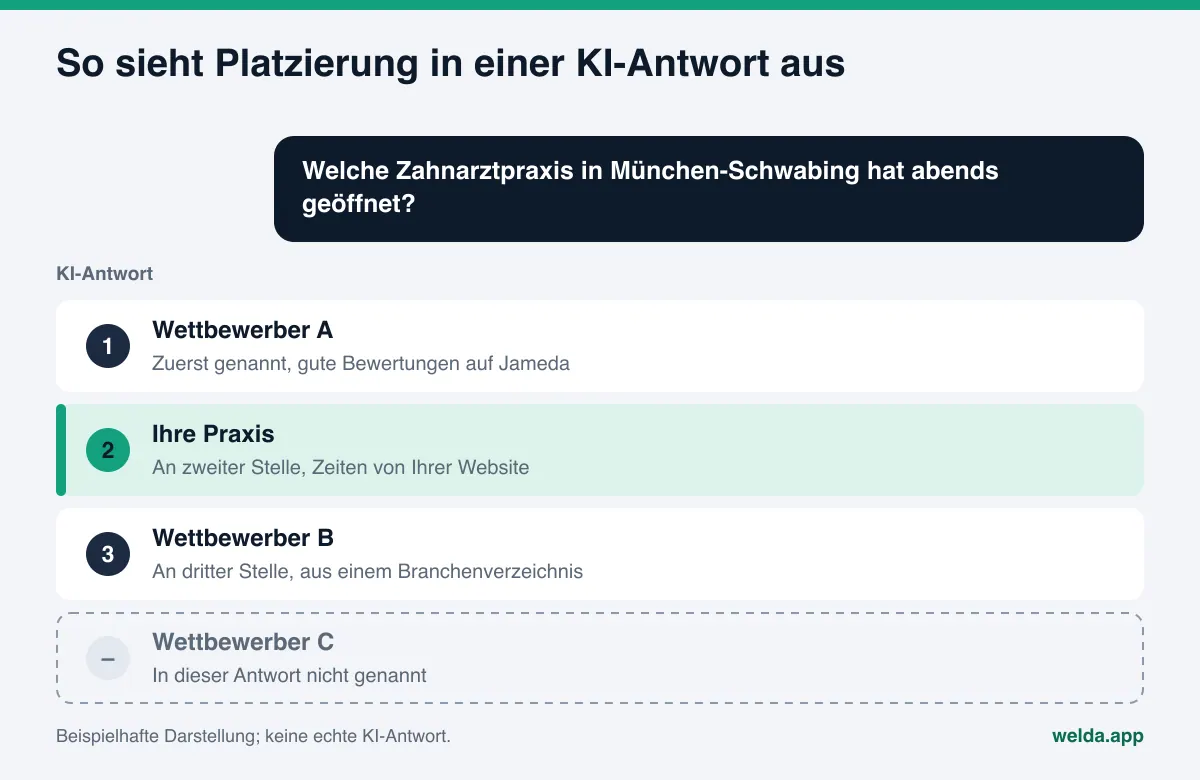
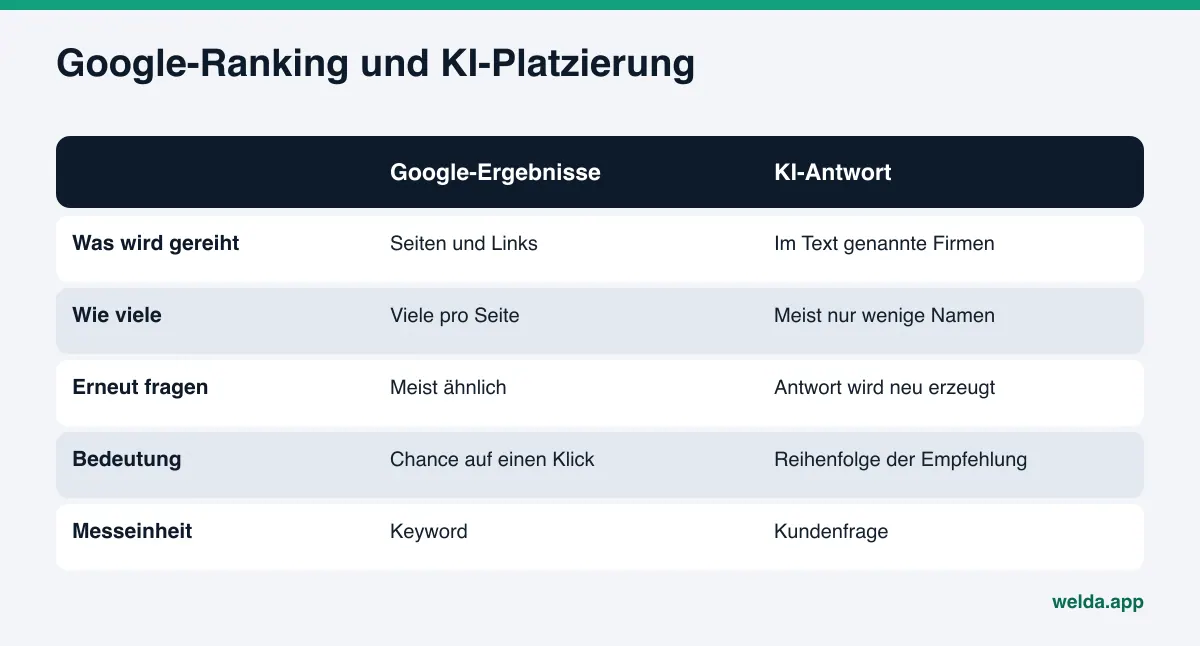
Bei Google ist das Ranking der Platz einer Seite in einer Ergebnisliste. Der erste Link steht oben, der zehnte unten. KI-Antworten funktionieren anders. Eine Patientin fragt "Welche Zahnarztpraxis in München-Schwabing hat abends geöffnet?", und die Engine schreibt einen Absatz oder eine kurze Liste mit einigen Praxen. Die Platzierung ist die Reihenfolge, in der Unternehmen in diesem Text vorkommen.
Diese Reihenfolge ist wichtig, weil das zuerst genannte Unternehmen an der sichtbarsten Stelle der Antwort steht und oft mit einer Begründung beschrieben wird ("Patienten loben die kurzfristigen Termine"). Andere Unternehmen werden nur nebenbei erwähnt. Die Platzierung ist also nicht nur eine Zahl, sondern die Art, wie Sie empfohlen werden.
Um die Platzierung in einer KI-Antwort zu lesen, betrachten Sie vier Ebenen gemeinsam:
- Nennung: Kommen Sie in der Antwort überhaupt vor? Wenn nicht, gibt es keinen Platz zu besprechen.
- Position: Wenn ja, sind Sie das erste genannte Unternehmen, das dritte oder das letzte?
- Kontext: Wie werden Sie beschrieben? Mit einem positiven Grund, nur mit Namen oder mit einer Einschränkung?
- Quelle: Woher kennt die Engine Sie? Von Ihrer Website, Ihrem Google Unternehmensprofil, von Jameda, Gelbe Seiten oder einem Branchenportal?
Ein ChatGPT-Ranking-Tracker, der diese vier Ebenen nicht zusammen zeigt, liefert ein unvollständiges Bild. Ein Bericht, der nur "Sie sind auf Platz 3" meldet, erklärt nicht, warum das so ist und was sich daran ändern ließe.
Warum ändert sich Ihr Platz bei jeder Abfrage?
Stellen Sie ChatGPT zweimal dieselbe Frage, erhalten Sie unter Umständen zwei unterschiedliche Antworten. Das ist kein Fehler, sondern die Arbeitsweise dieser Systeme. Die Antwort wird jedes Mal neu erzeugt, bei einer Websuche können andere Quellen gefunden werden, und schon eine leicht andere Formulierung rückt andere Unternehmen nach vorne. Ein einzelner Screenshot ist deshalb keine gute Grundlage für Aussagen wie "Wir sind bei ChatGPT auf Platz eins" oder "Wir tauchen nie auf".
Die wichtigsten Gründe für schwankende Platzierungen:
- Neu erzeugte Antworten: Dieselbe Frage in derselben Engine kann wenige Minuten später eine andere Reihenfolge liefern.
- Formulierung: Begriffe wie "beste", "günstig", "in der Nähe" oder "abends geöffnet" lenken die Antwort auf andere Quellen.
- Unterschiede zwischen Engines: ChatGPT, Gemini, Perplexity und Google AI stützen sich auf unterschiedliche Quellen. Bei einer Engine können Sie Zweiter sein und bei einer anderen fehlen. Mehr dazu lesen Sie im Beitrag Gemini-Sichtbarkeit messen.
- Zugriffsweg: Eine Frage in der App und eine Frage über eine Programmierschnittstelle liefern nicht immer dieselbe Antwort. Wie Tracking-Tools damit umgehen, erklären wir unter API- und App-Antworten im KI-Tracking.
- Aktualisierte Quellen: Neue Bewertungen auf einem Portal oder eine überarbeitete Website eines Wettbewerbers verschieben die Antworten mit der Zeit.
Die praktische Folge: Eine Platzierung ist nur aussagekräftig, wenn jede Frage mehr als einmal gestellt wird. Sind Sie in zwei von drei Läufen auf Platz zwei und im dritten auf Platz vier, liegt Ihr Median bei Platz zwei, und die Streuung zeigt die Fehlerspanne. Ein Tool, das jede Frage nur einmal stellt, liefert eine Momentaufnahme und keinen Trend.
Was sollte ein ChatGPT-Ranking-Tracker messen?
Viele Produkte bezeichnen sich inzwischen als KI-Ranking-Tracker, und ihre Beschreibungen ähneln sich stark. Beim Vergleich lohnt der Blick auf die Messmethode statt auf den Markennamen. Die folgende Tabelle zeigt, was ein ChatGPT-Ranking-Tracker liefern sollte und warum das für Ihre KI-Sichtbarkeit zählt.
| Messgröße | Was sie zeigt | Warum sie wichtig ist |
|---|---|---|
| Nennung pro Frage | Ob Sie bei jeder einzelnen Frage genannt werden | Ein Gesamtprozentsatz verdeckt, wo Sie fehlen |
| Reihenfolge der Nennung | An welcher Stelle der Antwort Sie stehen | Das zuerst genannte Unternehmen steht am sichtbarsten |
| Wiederholungen und Spanne | Wie oft jede Frage gestellt wird und wie stark die Ergebnisse schwanken | Eine einzelne Antwort kann Zufall sein |
| Aufteilung nach Engine | ChatGPT, Gemini, Perplexity und Google AI getrennt | Jede Engine nutzt andere Quellen |
| Position der Wettbewerber | Wer in derselben Antwort genannt wird und an welcher Stelle | Ein Platz ist immer relativ zu anderen |
| Zitierte Quellen | Die Websites, aus denen die Engine Informationen zieht | Zeigt, wo eine Korrektur ansetzen muss |
| Verlauf über Zeit | Veränderung über Wochen bei derselben Fragenliste | Der einzige Weg, die Wirkung Ihrer Arbeit zu sehen |
Die letzten beiden Zeilen werden am häufigsten übersehen. Ranking-Daten allein sagen, was passiert ist. Warum es passiert ist und was zu tun ist, steht in den Quellen- und Wettbewerbsdaten. Die Logik des Vergleichs mit Wettbewerbern erläutern wir im Beitrag Share of Voice in KI-Antworten.
ChatGPT-Ranking-Tracking Schritt für Schritt aufbauen
Mit oder ohne Tool: Die Logik des Trackings bleibt gleich. Ein kleines Unternehmen kann mit einer einfachen Tabelle beginnen.
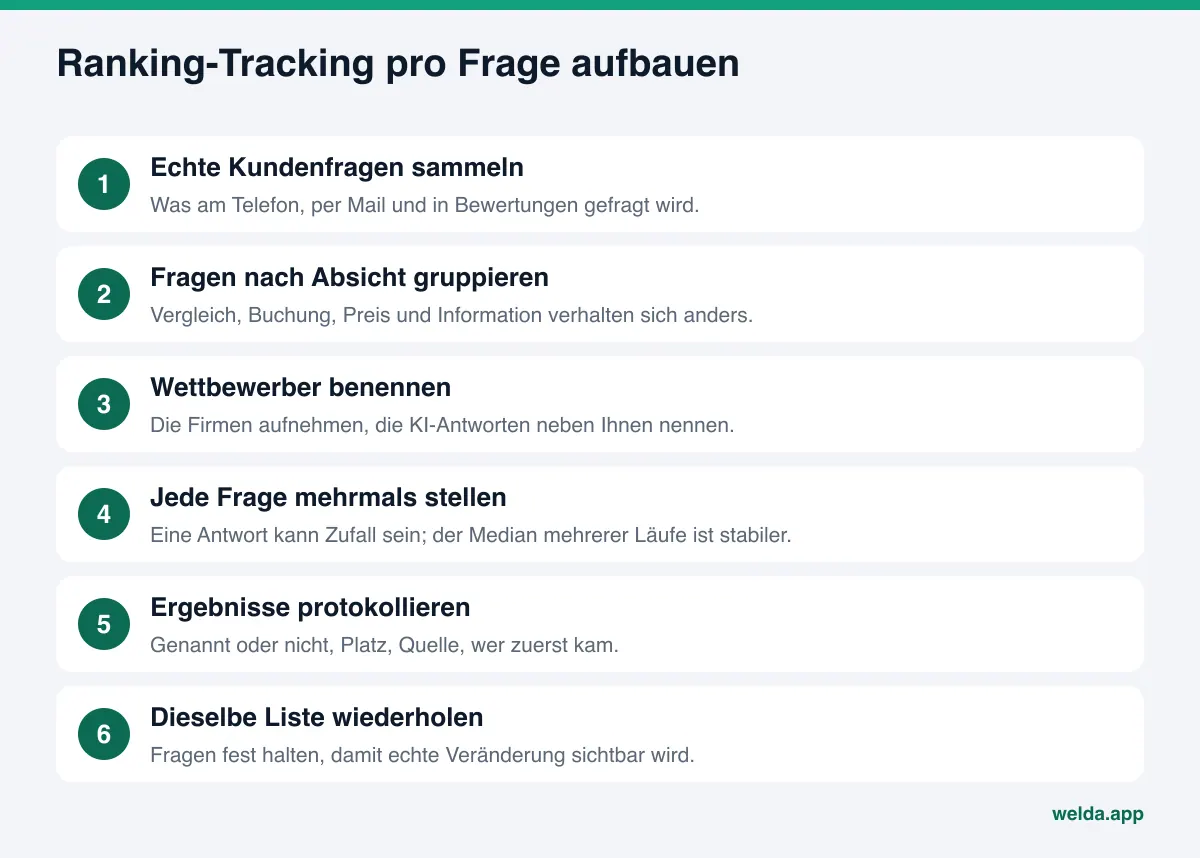
- Echte Kundenfragen sammeln. Notieren Sie, was Kundinnen und Kunden am Telefon, per E-Mail und in Bewertungen fragen. Statt allgemeiner Fragen wie "bester Zahnarzt in Bayern" nehmen Sie konkrete mit Stadtteil und Bedarf, etwa "Zahnarzt in Wien-Neubau mit Samstagsterminen" oder "Elektriker in Zürich-Oerlikon für Altbau". 15 bis 30 Fragen reichen für den Anfang.
- Fragen nach Absicht gruppieren. Vergleichsfragen ("was ist besser"), Buchungs- oder Terminfragen, Preisfragen und Informationsfragen verhalten sich unterschiedlich. Getrennte Gruppen zeigen, wo Sie schwach sind.
- Wettbewerber namentlich festhalten. Die Wettbewerber, an die Sie denken, und die Unternehmen, die KI-Antworten neben Ihnen nennen, sind nicht immer dieselben. Nehmen Sie Namen aus der ersten Runde in die Liste auf.
- Jede Frage in jeder Engine mehrmals stellen. Mindestens drei Läufe ergeben einen deutlich belastbareren Median als einer. Öffnen Sie jedes Mal einen neuen Chat, damit frühere Gespräche die Antwort nicht beeinflussen.
- Ergebnisse in einer festen Tabelle protokollieren. Pro Frage genügen diese Spalten: Engine, Lauf, genannt oder nicht, Platz, zuerst genanntes Unternehmen, zitierte Quelle, Datum.
- Dieselbe Liste regelmäßig wiederholen. Wer die Fragen ständig ändert, sieht keine Entwicklung. Halten Sie die Kernliste fest und fügen Sie neue Fragen als eigene Gruppe hinzu.
- Nach jeder Runde eine Aufgabe festlegen. Tracking ohne Aufgaben produziert nur Berichte. Beginnen Sie mit der Fragengruppe, in der Sie am häufigsten fehlen, und mit der Quelle, aus der der Wettbewerber dort zitiert wird.
Die Schwäche des manuellen Wegs ist der Aufwand. 20 Fragen in vier Engines mit je drei Läufen ergeben 240 Antworten pro Runde. Jede davon zu lesen und Platz, Wettbewerber und Quellen einzutragen, dauert Stunden. Deshalb machen viele die erste Runde und geben vor der zweiten auf. Ein ChatGPT-Ranking-Tracker ist genau dafür da, diesen wiederkehrenden Teil zu übernehmen.
Manuelles Tracking oder ein GEO-Tool?
Manuelles Tracking ist lehrreich. Die ersten Fragen selbst zu stellen ist der schnellste Weg zu verstehen, wie KI-Engines Ihre Branche beschreiben und welchen Quellen sie vertrauen. Für laufendes Tracking zeigen sich die Grenzen aber schnell.
| Kriterium | Manuell | GEO-Tool |
|---|---|---|
| Start | Sofort, mit einer Tabelle | Fragenliste und Wettbewerber nötig |
| Läufe pro Frage | Meist einer, wegen des Aufwands | Feste Anzahl bei jeder Runde |
| Abgedeckte Engines | Meist nur ChatGPT | Mehrere Engines in derselben Runde |
| Persönliche Verzerrung | Ihr Kontoverlauf kann Antworten beeinflussen | Gleiche Bedingungen für jede Abfrage |
| Verlauf | Handgepflegte Tabelle, fehleranfällig | Wochenverlauf und Vorher-nachher-Vergleich |
| Quellen- und Wettbewerbsanalyse | Jede Antwort selbst lesen | Zusammengefasst pro Frage und Wettbewerber |
Die Entscheidung ist meist einfach. Ist GEO für Sie neu, machen Sie die erste Runde von Hand, um das Verhalten der Antworten kennenzulernen, und wechseln Sie für das regelmäßige Tracking zu einem Tool. Welche Funktionen dabei zählen, beschreibt unser Beitrag zu GEO-Tool-Funktionen.
Wie misst Welda Ihre Platzierung in ChatGPT und anderen KI-Engines?
Welda ist eine Software, die misst, wo ein Unternehmen in KI-Antworten auftaucht, und fehlende Angaben im Namen des Unternehmens ergänzt. Das Ranking-Tracking steht im Zentrum der Messung im Welda-Dashboard. Vorab zur Einordnung: Das Dashboard befindet sich im Early Access und öffnet zuerst für Unternehmen in der Türkei. Die regelmäßige Messung über alle vier Engines kommt während des Early Access hinzu, und die unten beschriebenen Ansichten zeigen Beispieldaten. Fragen im Dashboard lassen sich derzeit auf Türkisch oder Englisch stellen. Was Sie heute auf Deutsch nutzen können, ist die kostenlose Website-Analyse. Drei Bausteine sind für das Ranking-Tracking besonders wichtig.
Fragenansicht: jede Frage, jede Engine, jeder Lauf
In Welda ist die Platzierung keine zusammengemischte Zahl, sondern wird Frage für Frage gezeigt. Jede Zeile ist eine Kundenfrage, die Spalten sind ChatGPT, Gemini, Perplexity und Google AI. In jeder Zelle steht Ihr Platz in dieser Engine; eine leere Zelle bedeutet, dass Sie nicht genannt wurden. Sie können nach Absicht (Buchung, Vergleich, Information) und nach Engine filtern.
Öffnen Sie eine Frage, sehen Sie die Details hinter der Zahl: Ihren Platz in jeder Engine, welche Unternehmen die Antwort mit welcher Begründung nennt, das Ergebnis jedes der drei Läufe und deren Median sowie die zitierten Quellen. Fehlten Sie einmal und wurden zweimal an unterschiedlicher Stelle genannt, sehen Sie genau das, statt eines Durchschnittswerts, der es verdeckt. Die Frage "Ist unser Platz hier stabil oder Zufall?" ist damit beantwortet.
Die Entscheidung in dieser Ansicht lautet meist: Bei welchen Fragen fehlen Sie ganz, bei welchen sind Sie dabei, aber weit hinten? Beides verlangt unterschiedliche Arbeit. Fehlen Sie ganz, fehlt meist eine Angabe, etwa eine Leistung, die auf Ihrer Website nicht klar beschrieben ist, oder ein Profil auf einer Quelle, die die Engine nutzt. Stehen Sie weit hinten, lohnt der Blick darauf, woher der Wettbewerber vor Ihnen seine Stärke bezieht.
Die Score-Formel: Wie viel zählt die Platzierung?
Der Welda-Score wird mit einer offengelegten Formel berechnet, und die Platzierung ist ein Teil davon. Die Hälfte des Scores kommt aus dem Anteil der Fragen, bei denen Sie genannt werden, 30 Prozent aus dem Platzierungswert und 20 Prozent aus Ihrem Anteil gegenüber Wettbewerbern. Da jede Frage in jeder Engine dreimal gestellt wird, ergibt sich aus der Streuung eine Fehlerspanne (±).
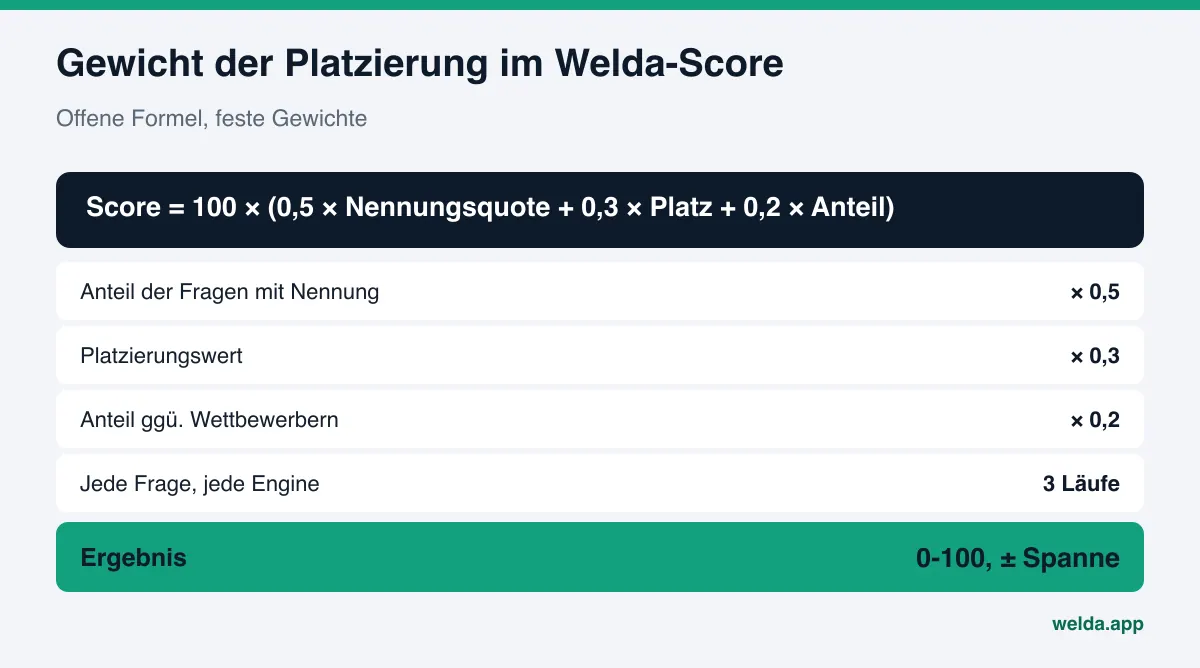
Diese Gewichtung hat eine praktische Bedeutung: erst genannt werden, dann nach vorne rücken. Fehlt ein Unternehmen bei zehn Fragen, bewegt das Schließen dieser Lücken den Score stärker als der Kampf um Platz eins bei Fragen, in denen es schon vorkommt. Welcher Bereich für Sie realistisch ist, lesen Sie unter guter KI-Sichtbarkeits-Score.
Wettbewerberansicht: Wer steht vor Ihnen und warum?
Eine Platzierung ergibt nur im Vergleich Sinn. Die Wettbewerberansicht zeigt, wie oft jeder Wettbewerber bei derselben Fragenliste genannt wird, seinen Anteil an allen Nennungen und die Engine, in der er am stärksten ist. Noch nützlicher: Sie sehen, bei welchem Thema ein Wettbewerber gewinnt und aus welcher Quelle er zitiert wird. Liegt ein Wettbewerber bei einer Fragengruppe vorne und wird dafür aus Jameda, ProvenExpert oder einem Buchungsportal zitiert, sind Ihr Profil und Ihre Angaben dort der erste Ansatzpunkt.
Nach der Messung übernimmt Welda die zweite Hälfte der Arbeit. Welda entwirft Inhalte, Profiltexte und Antworten auf Bewertungen, die die Lücken schließen sollen, und sammelt sie in einer Aufgabenliste. Die Freigabe zur Veröffentlichung bleibt bei Ihnen, und die Inhalte liegen auf Ihrer eigenen Website. Wie sich der Platz bei einer Frage danach entwickelt, zeigen ein Vorher-nachher-Vergleich und ein einseitiger Monatsbericht.
Solange das Dashboard für Sie noch nicht offen ist, können Sie heute die kostenlose Website-Analyse nutzen. Sie liest Ihre Website so, wie KI-Systeme es tun, listet fehlende Punkte und deren Behebung auf und stellt außerdem einem KI-Assistenten mit Websuche 5 Fragen, die Ihre Kunden stellen könnten. Dann prüft sie, ob Ihr Unternehmensname in den Antworten vorkommt. Das ist eine einmalige Prüfung und kein Ranking-Tracking, gibt aber eine erste Antwort auf die Frage "Werden wir überhaupt genannt?".
Ranking-Daten richtig lesen: ein Beispielszenario
Ein Beispiel macht es greifbar. Ein beispielhaftes Boutique-Hotel am Tegernsee verfolgt vor der Sommersaison eine Liste von 20 Fragen. Die erste Runde sieht so aus: Bei etwa der Hälfte der Buchungsfragen wird es genannt, meist auf Platz zwei oder drei. Bei Fragen zu Hochzeitsreisen taucht es gar nicht auf. Bei Fragen zu Wellness und Frühstück wird es in einer Engine an erster Stelle genannt. Diese Werte sind ein Beispiel und gehören zu keinem realen Unternehmen.
Beim Lesen einer solchen Tabelle passieren drei Fehler häufig. Erstens wird Platz eins in einer einzigen Engine für den Gesamterfolg gehalten. Zweitens wird eine Fragengruppe ignoriert, in der man nie vorkommt, während man um Platz eins kämpft, wo man ohnehin gut dasteht. Drittens wird auf einen kleinen Rückgang in einer Runde reagiert und jede Woche die Website umgebaut.
Die bessere Lesart: Das Fehlen bei allen Fragen zu Hochzeitsreisen ist der größte Verlust, weil die Nennungsquote den schwersten Teil des Scores ausmacht. Also wird geprüft, aus welchen Quellen die dort genannten Wettbewerber zitiert werden. Hat die Hotelwebsite keine klare Seite zu diesem Angebot, oder erwähnen weder das Google Unternehmensprofil noch der Eintrag auf Tripadvisor es, ist das die erste Aufgabe. Die Plätze zwei und drei bei Buchungsfragen kommen danach. Wo ein Wettbewerber dauerhaft vorne liegt, lohnt der Blick auf seine Bewertungen und darauf, ob er einen klaren FAQ-Bereich zu denselben Fragen hat.
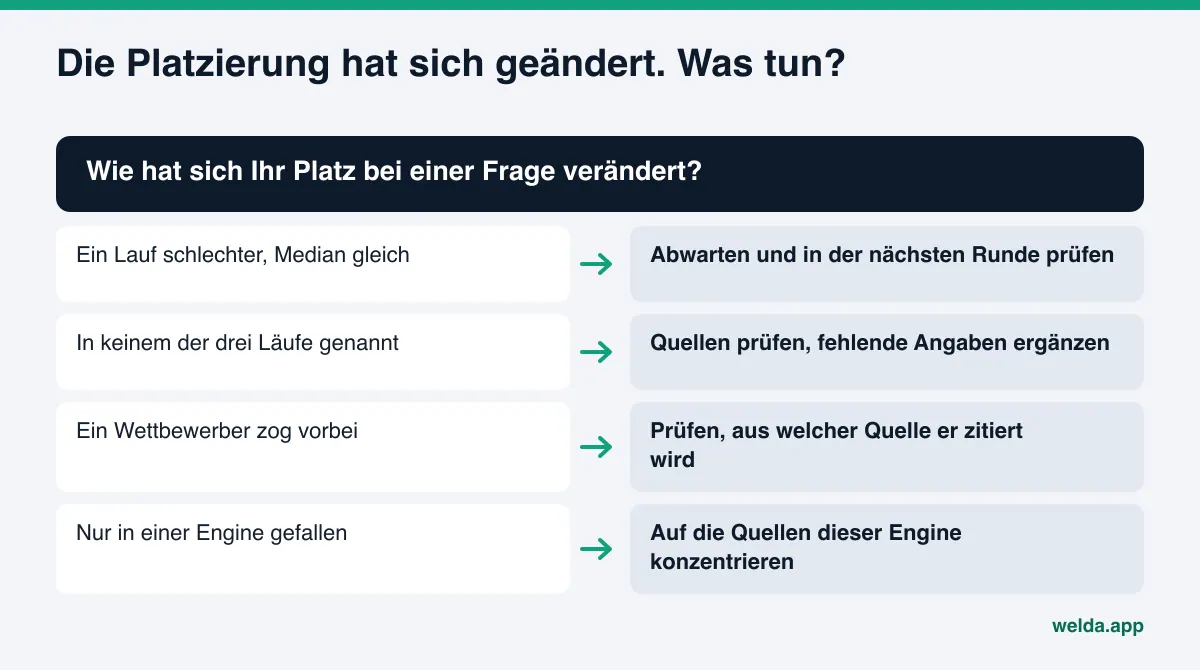
Daraus ergibt sich auch die Reihenfolge der Arbeit. Im ersten Monat werden die fehlenden Angaben zu Hochzeitsreisen ergänzt, die neue Seite und der Profiltext gehen zur Freigabe. In den folgenden Runden werden dieselben 20 Fragen unter denselben Bedingungen erneut gestellt. Wird das Hotel nun bei diesen Fragen genannt, steigt die Nennungsquote, und der Fokus wandert zu den Buchungsfragen. So entsteht ein Plan, der sich pro Monat auf eine Fragengruppe konzentriert und messbar bleibt.
Denken Sie bei jeder Reaktion auf eine Veränderung an die Fehlerspanne. Hat sich der Median aus drei Läufen nicht bewegt, ist ein Rückgang in einem Lauf Rauschen, kein Signal. Bewegt sich der Median über mehrere Runden in dieselbe Richtung, lohnt sich die Suche nach einer Ursache. Wenn Sie zusätzlich verfolgen möchten, wie Ihre Marke beschrieben wird und nicht nur wo sie steht, lesen Sie unseren Beitrag zu Markenmonitoring in KI-Antworten.
Grenzen: Was Ranking-Tracking nicht zeigt und was Welda nicht tut
Ranking-Tracking ist ein starkes Signal, aber es sagt nicht alles. Wer die Grenzen kennt, liest die Daten richtig.
- Nicht jeder Kunde sieht dieselbe Antwort. Standort, Chatverlauf und genaue Formulierung verändern das Ergebnis. Ein Tracker zeigt Antworten auf Fragen unter kontrollierten Bedingungen, nicht den Bildschirm jedes einzelnen Kunden.
- Platz ist nicht gleich Klick oder Kunde. Auf Platz zwei genannt zu werden, sagt nicht, wie viele Anrufe oder Buchungen daraus entstehen. Dafür müssen Anfragequellen separat erfasst werden.
- Gemessen wird nur, was gefragt wird. Passt die Fragenliste nicht zur echten Sprache Ihrer Kunden, spiegeln auch die Ranking-Daten die Realität nicht wider.
- Veränderung braucht Zeit. Neue Inhalte erscheinen in der Regel erst nach Wochen in KI-Antworten. Eine Veränderung innerhalb einer Woche zu erwarten, führt in die Irre.
Ebenso klar ist, was Welda nicht tut. Welda garantiert weder einen Platz noch eine Nennung in ChatGPT; das kann niemand seriös versprechen, denn die Antwort schreibt die Engine. Welda erfindet keine Angaben, die es nicht kennt, sondern fragt beim Unternehmen nach. Es erzeugt keine gefälschten Bewertungen und veröffentlicht keine sensiblen Inhalte ohne Ihre Freigabe. Der Umgang mit negativen Bewertungen, die Pflege von Verzeichniskonten wie Gelbe Seiten oder kununu und die Pressearbeit bleiben beim Unternehmen; Welda hilft dabei nur mit Antwortentwürfen oder führt sie als Aufgabe. Für Werbeaussagen auf Ihrer Website gelten weiterhin das UWG und in Gesundheitsberufen das HWG; die Verantwortung dafür bleibt bei Ihnen, und dieser Hinweis ist keine Rechtsberatung. Auch die kostenlose Website-Analyse misst keine Platzierung, sondern zeigt, wie gut Ihre Website vorbereitet ist, und führt eine einmalige Fragenprüfung durch.
Checkliste: ChatGPT-Ranking-Tracker auswählen
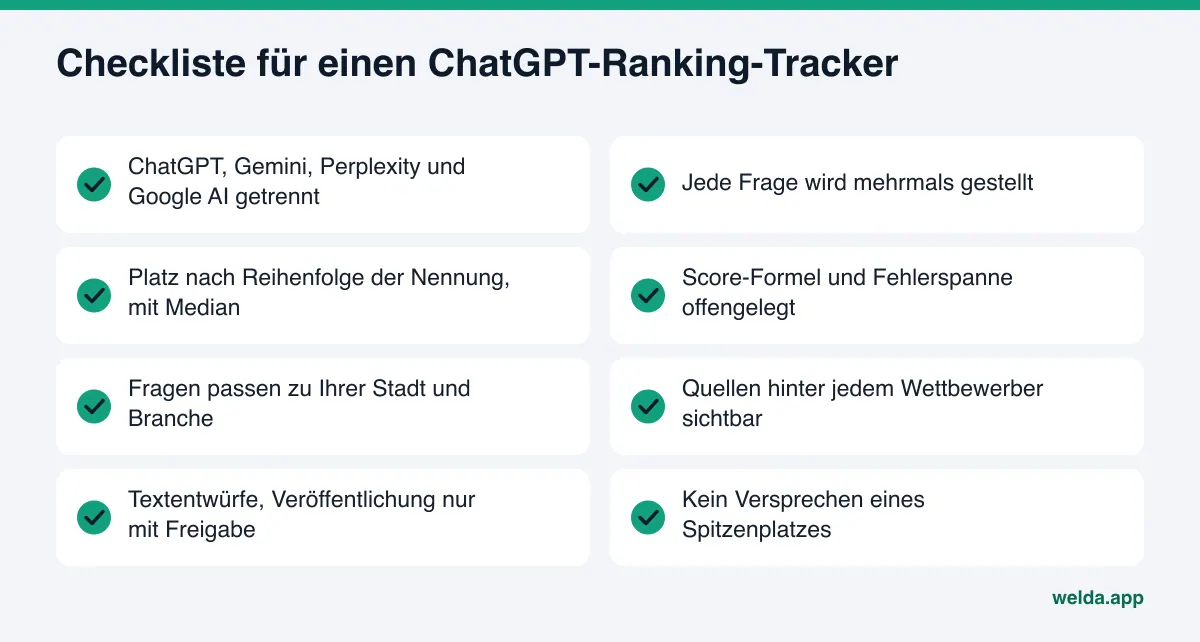
Wenn Sie eine Demo ansehen oder Ihr eigenes Tracking aufbauen, lassen Sie sich die folgenden Fragen schriftlich beantworten. Jeder Punkt, der unklar bleibt, erschwert später die Bewertung der Ranking-Daten.
| Frage | Die Antwort, die Sie suchen |
|---|---|
| Welche Engines werden tatsächlich abgefragt? | Neben ChatGPT auch Gemini, Perplexity und Google AI, jeweils getrennt |
| Wie oft wird jede Frage gestellt? | Mehr als einmal, mit sichtbarer Streuung |
| Wie wird der Platz berechnet? | Reihenfolge der Nennung, Median über die Läufe |
| Ist die Score-Formel offengelegt? | Gewichte und Fehlerspanne schriftlich |
| Passen die Fragen zu Ihrer Stadt und Branche? | Echte Kundensprache statt allgemeiner Fragen |
| Ist sichtbar, aus welcher Quelle ein Wettbewerber gewinnt? | Zitierte Websites pro Frage und Wettbewerber |
| Wer übernimmt die Arbeit nach der Messung? | Textentwürfe, Veröffentlichung nur mit Ihrer Freigabe |
| Wird ein Spitzenplatz garantiert? | Nein; wer das garantiert, legt seine Methode nicht offen |
Häufige Fragen
Gibt es bei ChatGPT ein Ranking wie bei Google?
Nein. ChatGPT schreibt eine Antwort und keine Ergebnisliste. Die Platzierung ist die Reihenfolge, in der Unternehmen in dieser Antwort genannt werden, und sie kann sich bei erneuter Frage ändern.
Kann ich meine ChatGPT-Platzierung kostenlos prüfen?
Ja, von Hand. Öffnen Sie für jede Frage einen neuen Chat, stellen Sie sie mehrmals und tragen Sie die Ergebnisse in eine Tabelle ein. Die kostenlose Website-Analyse von Welda prüft einmalig, ob Sie bei 5 Fragen genannt werden; ein Ranking-Tracking ist das nicht.
Warum erhalte ich bei jeder Frage ein anderes Ergebnis?
Antworten werden jedes Mal neu erzeugt, und bei einer Websuche können sich die gefundenen Quellen ändern. Für eine belastbare Messung wird jede Frage deshalb mehrmals gestellt und der Median betrachtet.
Wie viele Fragen sollte ich verfolgen?
Für ein kleines Unternehmen sind 15 bis 30 echte Kundenfragen ein guter Start. Wichtiger als die Anzahl ist, dass die Fragen die Sprache Ihrer Kunden treffen und Details wie Stadtteil, Leistung und Preis enthalten.
Muss ich auf Platz eins stehen?
Nein. In der Welda-Formel stammt der größte Teil des Scores aus dem Anteil der Fragen, bei denen Sie überhaupt genannt werden. Lücken zu schließen bringt meist mehr, als bei Fragen, in denen Sie schon vorkommen, einen Platz aufzurücken.
Kann ich das Welda-Dashboard in Deutschland, Österreich oder der Schweiz nutzen?
Das Dashboard ist im Early Access und öffnet zuerst für Unternehmen in der Türkei. Über den Preis sprechen wir im Early-Access-Gespräch. Heute überall nutzbar ist die kostenlose Website-Analyse, die auf Deutsch funktioniert.
Wie lange dauert es, bis sich meine Platzierung ändert?
Eine feste Dauer gibt es nicht. Neue oder korrigierte Inhalte erscheinen in der Regel erst nach Wochen in KI-Antworten. Messen Sie deshalb dieselbe Fragenliste regelmäßig und reagieren Sie nicht auf die Bewegung einer einzelnen Runde.
Wo Sie mit dem KI-Ranking-Tracking anfangen
ChatGPT-Ranking-Tracking beginnt damit, die Frage "Auf welchem Platz stehe ich?" in bessere Fragen zu zerlegen: Bei welchen Fragen werde ich genannt, wie weit vorne, wer steht vor mir, und woher bezieht dieser Wettbewerber seine Stärke? Diese vier Antworten führen zu deutlich nützlicherer Arbeit als eine einzelne Platzierung. Als ersten Schritt starten Sie die kostenlose Analyse Ihrer KI-Sichtbarkeit und sehen, wie KI-Systeme Ihre Website lesen und was fehlt. Sie erhalten einen Score, eine Lösung für jede Lücke und das Ergebnis der Prüfung mit 5 Fragen; von dort aus können Sie auch den Early Access für das Welda-Dashboard anfragen.