Yapay zeka botları siteme giriyor mu, bunu nasıl anlarım? En hızlı yol sitenizin robots.txt dosyasını açıp ChatGPT, Perplexity ve Google botlarının adlarına yazılmış kuralları okumaktır. Bot kapıda takılıyorsa yapay zeka sitenizdeki bilgiyi okuyamaz, cevabını başka kaynaklardan kurar. Bu yazıda botların neler olduğunu, girip girmediklerini adım adım nasıl kontrol edeceğinizi ve hangilerine kapıyı açmanın mantıklı olduğunu anlatıyoruz.
Bu soru teknik görünür ama sonucu ticaridir. Bir müşteri ChatGPT'ye "Kadıköy'de akşam açık bir diş kliniği" ya da "Bodrum'da çocuklu aileye uygun butik otel" diye sorduğunda, cevap motorun okuyabildiği sayfalardan kurulur. Sizin sitenize giremeyen bir bot, hizmetlerinizi, çalışma saatlerinizi ve fiyat politikanızı sizden değil, bir rehber sitesinden ya da rakibinizin sayfasından öğrenir. GEO, yani yapay zeka görünürlüğü üzerine yapılacak her işin ilk şartı bu kapının açık olmasıdır. Kendi sitenizde durumu hemen görmek isterseniz ücretsiz site analizi robots.txt dosyanızı da okur ve yapay zeka botlarının girip giremediğini raporun teknik bölümünde gösterir.
Yapay zeka botları siteme giriyor mu sorusu neden önemli?
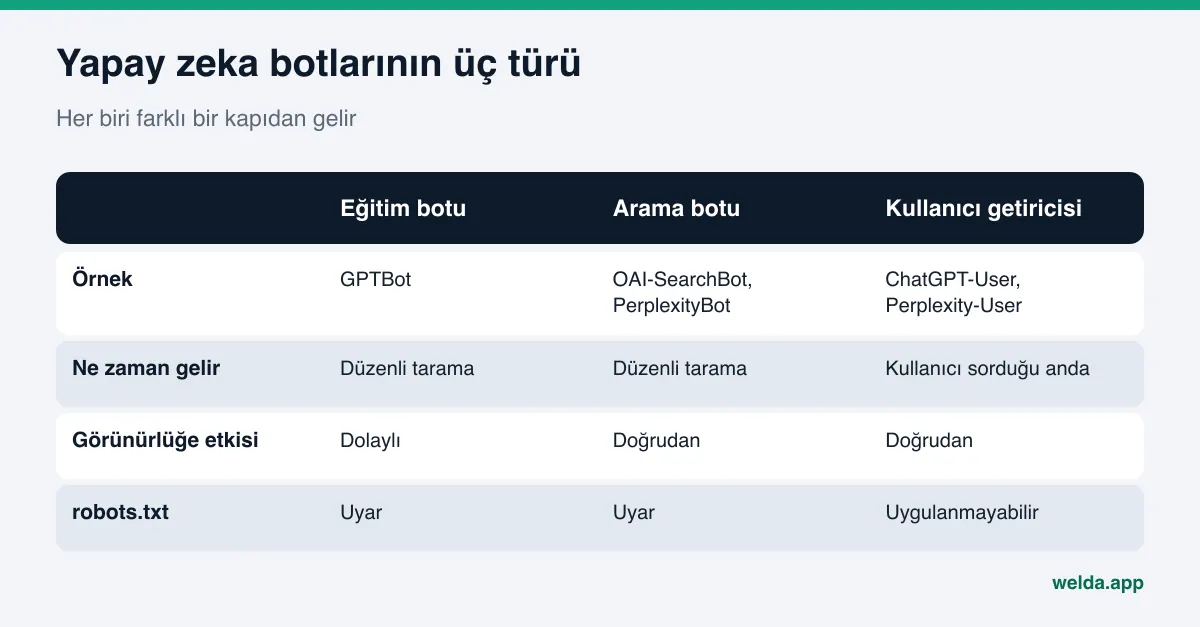
Klasik aramada Google'ın sitenizi taraması uzun zamandır bilinen bir konu. Yapay zeka cevaplarında ise iş biraz daha dağınık: her şirketin kendi botları var ve bu botların her biri farklı bir iş için siteye gelir. Biri modeli eğitmek için metin toplar, biri arama cevaplarında gösterilecek sayfaları dizine ekler, bir diğeri de kullanıcı soru sorduğu anda sayfayı açıp okur. Bu ayrım önemlidir, çünkü sitenizin hangi kapısını kapattığınızı bilmeden "yapay zekayı engelledim" ya da "açık bıraktım" demek eksik bir cevaptır.
İşletme açısından üç durum vardır:
- Kapı açık, içerik okunuyor. Bot gelir, sayfayı okur, işletme bilginiz cevapta kullanılabilir. Görünüp görünmemeniz artık içeriğinize ve dış kaynaklara bağlıdır.
- Kapı bilmeden kapalı. Eski bir robots.txt şablonu, bir güvenlik eklentisi ya da altyapı tarafındaki bir tercih botları geri çevirir. İşletme sahibinin çoğu zaman haberi olmaz.
- Kapı bilerek kapalı. İçeriğinizin model eğitiminde kullanılmasını istemediğiniz için bazı botları engellemişsinizdir. Bu meşru bir karardır, ama arama botunu da yanlışlıkla kapattıysanız bedelini cevaplarda görünmeyerek ödersiniz.
İkinci durum en sık rastlanan ve en kolay düzelen durumdur. Bir işletme aylarca yeni sayfalar ve sık sorulan sorular yazabilir, ama robots.txt'de tek bir satır yüzünden bu emeğin bir kısmı yapay zeka arama cevaplarına ulaşmaz. Bu yüzden yapay zeka görünürlüğü çalışmasına içerikle değil, erişim kontrolüyle başlamak gerekir.
Hangi yapay zeka botları var, her biri ne iş yapar?
Aşağıdaki tablo, Türkiye'deki işletmelerin en çok merak ettiği üç motorun kendi belgelerinde tanımladığı botları özetliyor. Bot adları ve görevleri sağlayıcıların resmî sayfalarından alındı: OpenAI bot belgesi, Perplexity bot belgesi ve Google tarayıcı belgesi. Bu listeler zamanla değişir; kendi robots.txt dosyanızı düzenlemeden önce kaynağa bir kez daha bakmanızı öneririz.
| Bot ya da kural adı | Sahibi | Ne için gelir | Engellerseniz ne olur |
|---|---|---|---|
OAI-SearchBot | OpenAI | ChatGPT arama özelliklerinde gösterilecek siteleri bulur | OpenAI'a göre siteniz ChatGPT arama cevaplarında gösterilmez |
GPTBot | OpenAI | Model eğitiminde kullanılabilecek içeriği toplar | İçeriğinizin eğitimde kullanılmaması istenmiş olur |
ChatGPT-User | OpenAI | Kullanıcı sorduğunda sayfayı o anda açar | Kullanıcı başlattığı için robots.txt kuralları uygulanmayabilir |
PerplexityBot | Perplexity | Perplexity arama sonuçlarında siteleri gösterir ve bağlantı verir | Perplexity cevaplarında kaynak olma şansınız düşer |
Perplexity-User | Perplexity | Kullanıcının sorusu için sayfayı o anda getirir | Perplexity'ye göre bu getirici genelde robots.txt'yi dikkate almaz |
Googlebot | Google Arama'yı ve AI Bakışı, AI Modu gibi özellikleri besler | Sayfa içeriği Google aramasında ve AI özelliklerinde kullanılamaz | |
Google-Extended | Ayrı bir bot değil; Gemini eğitimi ve bazı Gemini kullanımları için izin işareti | Google'a göre Google Arama'ya dahil olmayı etkilemez |
Tablodan çıkan en önemli ders şu: eğitim ile arama ayrı kapılardır. OpenAI tarafında GPTBot'u kapatıp OAI-SearchBot'u açık bırakabilirsiniz. Google tarafında ise AI Bakışı ve AI Modu için ayrı bir bot yoktur. Google'ın AI özellikleri belgesi, bu özelliklerde gösterilmek için sayfanın Google aramasında dizine eklenmiş ve snippet ile gösterilebilir olmasının yettiğini, ek bir teknik şart olmadığını söyler. Yani Googlebot'u engellemek hem klasik aramadan hem AI Bakışı'ndan çıkmak demektir.
Botların sitenize girip girmediğini adım adım kontrol etmek
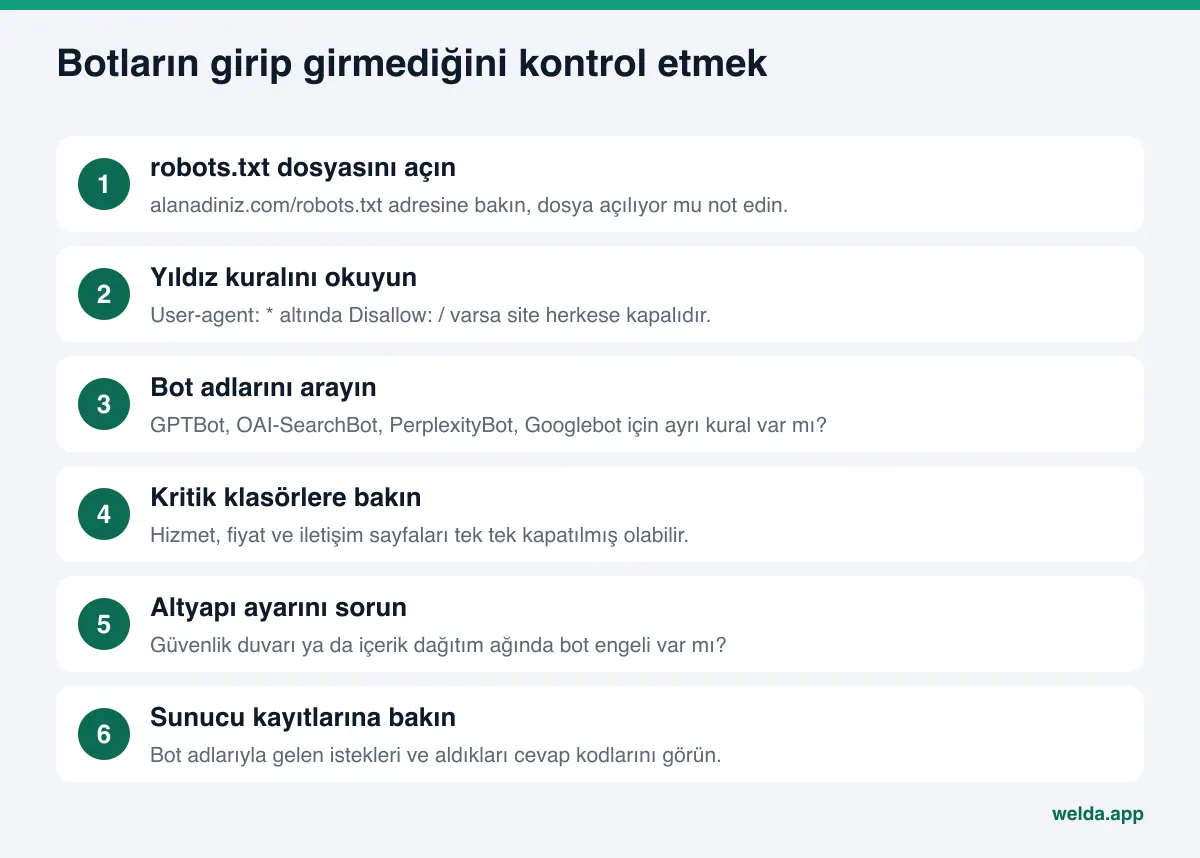
Bu kontrol için yazılımcı olmanız gerekmez. Bir tarayıcı ve yarım saat yeter. Sırayla şunları yapın:
- robots.txt dosyasını açın. Tarayıcıya
alanadiniz.com/robots.txtyazın. Dosya açılmıyorsa ya da hata veriyorsa bunu not edin; dosyanın hiç olmaması genelde "her şeye izin var" anlamına gelir, ama sunucu hata kodu döndürüyorsa botlar temkinli davranabilir. - Yıldız kuralına bakın.
User-agent: *satırının altındakiDisallowsatırları, adı ayrıca yazılmamış bütün botlar için geçerlidir. BuradaDisallow: /görüyorsanız sitenin tamamı herkese kapalıdır. Bu durum çoğu zaman test sitesinden canlıya geçerken unutulmuş bir ayardır. - Bot adlarını tek tek arayın. Dosyada
GPTBot,OAI-SearchBot,PerplexityBot,GooglebotveGoogle-Extendedadlarını arayın. Bir botun adına yazılmış kural varsa o bot yıldız kuralını değil kendi kuralını izler. - Kritik sayfaları ayrıca düşünün. Sitenin tamamı açık olsa bile
/hizmetler,/fiyatlarya da/iletisimgibi klasörler tek tek kapatılmış olabilir. Müşterinin soracağı bilgiler tam da bu sayfalardadır. - Sayfa içindeki etiketlere bakın. Sayfa kaynağında
noindexya danosnippetgeçiyorsa robots.txt açık olsa da Google o sayfayı AI özelliklerinde gösteremeyebilir. - Altyapı ayarlarını sorun. Siteniz bir içerik dağıtım ağı ya da güvenlik duvarı arkasındaysa, orada yapay zeka botlarına yönelik ayrı bir engel olabilir. Bunu robots.txt'de göremezsiniz; sitenizi yöneten kişiye ya da barındırma firmanıza sormanız gerekir.
- Sunucu kayıtlarına bakın. Erişim kayıtlarına ulaşabiliyorsanız, son haftalarda bu bot adlarıyla gelen istekleri ve hangi cevap kodunu aldıklarını görün. Bot hiç gelmiyorsa ya da sürekli engellendiğini gösteren kodlar alıyorsa sorun buradadır.
Son adım en kesin kanıttır, çünkü robots.txt yalnız bir istektir; botun gerçekten gelip gelmediğini kayıtlar söyler. Ama çoğu küçük işletme için ilk altı adım sorunu bulmaya yeter. Kayıtlarda bir bot adı görmeniz, o isteğin gerçekten o şirketten geldiğini de tek başına kanıtlamaz; sağlayıcılar bu yüzden kendi belgelerinde botlarını doğrulamanın yollarını da paylaşır.
Botlar en çok hangi nedenlerle kapıda kalıyor?
Engelin çoğu bilinçli bir karar değil, birikmiş ayarlardır. Sık karşılaşılan nedenler şunlar:
- Test sitesinden kalan kural. Site yapılırken arama motorlarından gizlemek için eklenen
Disallow: /satırı canlıya geçişte silinmemiştir. - Hazır engelleme listeleri. İnternette dolaşan "kötü botları engelle" listeleri bazen yapay zeka arama botlarını da içerir. Liste kopyalanır, içinde ne olduğu okunmaz.
- Güvenlik eklentileri. Bazı eklentiler tanımadığı tarayıcıları hız sınırına ya da doğrulama ekranına takar. Bot sayfa yerine bir uyarı ekranı görür.
- Altyapı tercihi. Cloudflare, Temmuz 2025'te yeni alan adı ekleyen müşterilerine yapay zeka tarayıcılarına izin verip vermeyeceklerini kayıt sırasında sorduğunu duyurdu. O ekranda hangi seçeneğin işaretlendiğini çoğu zaman siteyi kuran kişi bilir, işletme sahibi bilmez.
- Bilgisi yalnız görselde olan sayfalar. Bu bir engel değil ama sonucu benzer: menü, fiyat ya da çalışma saati bir görselin içindeyse bot kapıdan girse de metni okuyamaz.
- Giriş isteyen sayfalar. Fiyat listesini ya da hizmet detayını yalnız üyelere açtıysanız, bot o bilgiyi hiçbir zaman göremez.
Hazır site kurucularında robots.txt'ye erişim sınırlı olabilir. Wix gibi platformlarda bu ayarın nerede durduğunu Wix sitesi için GEO yazısında ayrıca ele alıyoruz.
Örnek: robots.txt satırlarını okumak
Robots.txt ilk bakışta karışık görünür, ama birkaç kalıbı tanıyınca okumak kolaylaşır. Aşağıdaki tablo, işletme sitelerinde sık görülen satırları ve yapay zeka botları açısından ne anlama geldiklerini gösteriyor. Satırlar örnektir; kendi dosyanızda birebir aynısı olmayabilir.
| Dosyada gördüğünüz | Anlamı | Yapay zeka görünürlüğü için |
|---|---|---|
User-agent: * ve altında Disallow: (boş) | Adı ayrıca yazılmamış bütün botlara her yer açık | Sorun yok |
User-agent: * ve altında Disallow: / | Adı ayrıca yazılmamış bütün botlara site kapalı | Acil düzeltilmeli |
User-agent: GPTBot ve Disallow: / | OpenAI'ın eğitim botu kapalı | Bilinçli bir karar ise sorun değil |
User-agent: OAI-SearchBot ve Disallow: / | ChatGPT arama botu kapalı | ChatGPT arama cevaplarında gösterilmezsiniz |
Disallow: /fiyatlar/ | Yalnız fiyat klasörü kapalı | Fiyat sorularında bilgi başka kaynaktan gelir |
Disallow: /wp-admin/ | Yönetim paneli kapalı | Normal ve doğru |
Şimdi örnek bir senaryo düşünelim. Örnek bir butik otelin sitesi iki yıl önce bir ajans tarafından yeniden yapılmış. Robots.txt dosyasında yıldız kuralı açık, ama dosyanın sonunda internetten kopyalanmış uzun bir "istenmeyen botlar" listesi var ve bu listede OAI-SearchBot ile PerplexityBot da yer alıyor. Otel sahibi bunu bilmiyor; Google aramasında sorun yaşamadığı için siteyi sağlıklı sanıyor. Oysa ChatGPT ve Perplexity'nin arama botları siteyi okuyamıyor, otelin oda tipleri ve kahvaltı bilgisi bu motorların cevaplarına yalnız rezervasyon sitelerinden ve rehberlerden ulaşıyor. Burada çözüm yeni içerik yazmak değil, kopyalanmış listeden iki satırı çıkarmaktır. Bu tür bir durumu fark etmek için robots.txt dosyasını baştan sona okumak, yalnız ilk satırlara bakmamak gerekir.
Aynı senaryonun tersi de olur: dosya tamamen açıktır, ama otelin güvenlik eklentisi tanımadığı tarayıcıları doğrulama ekranına yönlendirir. Robots.txt temiz göründüğü için sorun ancak sunucu kayıtlarında ya da sitenizi yöneten kişiye sorduğunuzda ortaya çıkar.
Hangi yapay zeka botlarına izin vermelisiniz?
Bu kararı verirken iki soruyu ayırın: "İçeriğim yapay zeka cevaplarında kaynak olarak kullanılsın mı?" ve "İçeriğim model eğitiminde kullanılsın mı?" Müşteri kazanmak isteyen bir yerel işletme için ilk sorunun cevabı neredeyse her zaman evettir. İkinci soru ise işletmenin kendi tercihidir; içeriği özel bir rehber, ücretli bir eğitim ya da yayıncılık ürünü olan bir işletme eğitimi kapatmak isteyebilir.
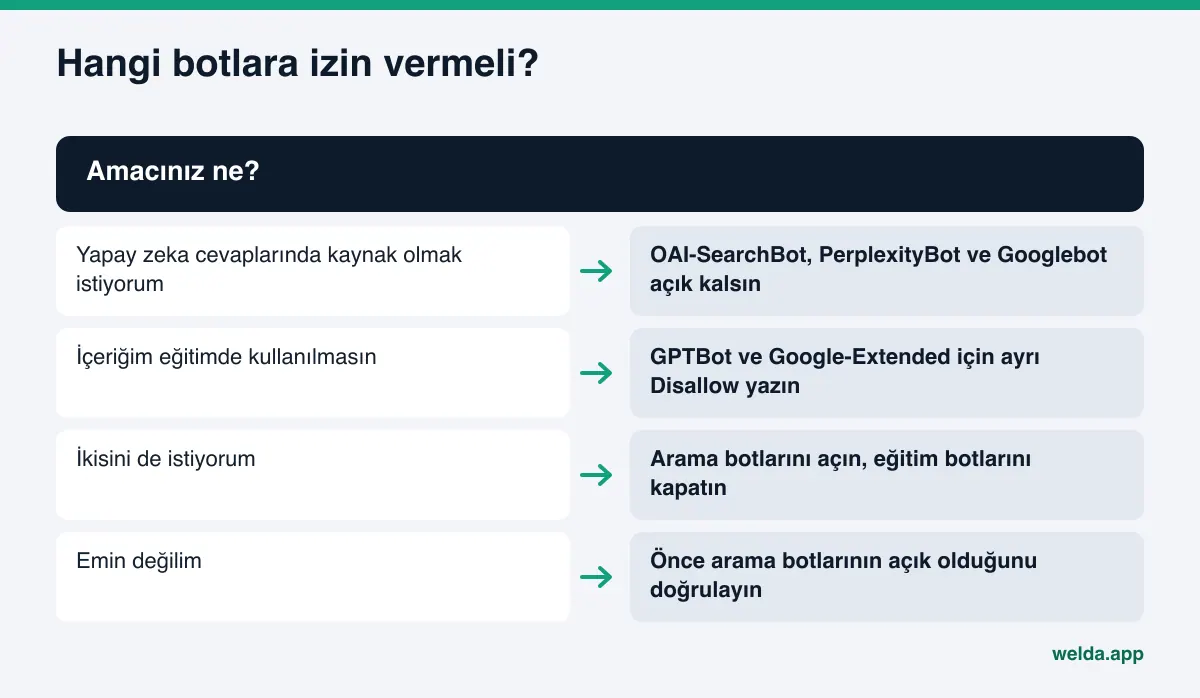
Arama botlarını açık, eğitim botunu kapalı tutmak isteyen bir işletmenin robots.txt dosyası aşağıdaki gibi görünebilir. Bu yalnız bir örnektir; kendi dosyanızdaki diğer kuralları silmeden, sitenizi yöneten kişiyle birlikte uyarlayın.
User-agent: OAI-SearchBotAllow: /User-agent: PerplexityBotAllow: /User-agent: GPTBotDisallow: /User-agent: *Disallow: /yonetim/
Bu örnekte Googlebot'a ayrı bir kural yazılmadığı için yıldız kuralına uyar: yönetim paneli dışındaki her yer açıktır. Google-Extended için kural yazmak isterseniz, bunun AI Bakışı'nda görünmenizi değil, Gemini tarafındaki eğitim ve bazı kullanımları etkilediğini unutmayın.
Bir uyarı daha: kullanıcının o anda başlattığı getiriciler (ChatGPT-User, Perplexity-User) için sağlayıcılar robots.txt kurallarının uygulanmayabileceğini kendi belgelerinde yazıyor. Yani robots.txt bu botlar için güvenilir bir kilit değildir. Asıl görünürlük kararını arama botları üzerinden verirsiniz.
Kapı açıldıktan sonra botlar ne görmeli?
Erişimi düzeltmek işin ilk yarısıdır. Bot artık içeri girebiliyor, ama sitede okuyacağı net bir bilgi bulamazsa cevapta yine sizden söz etmeyebilir. Kapıyı açtıktan sonra şu sayfaların okunabilir olduğundan emin olun:
| Sayfa ya da bilgi | Bot ne arar | Sık görülen eksik |
|---|---|---|
| Ana sayfa | Ne iş yaptığınız, nerede olduğunuz, kime hizmet verdiğiniz | Genel bir slogan var, iş ve konum yazılmamış |
| Hizmetler | Her hizmetin adı ve kısa açıklaması | Hizmetler yalnız görsel kartlarda duruyor |
| İletişim | Adres, telefon, çalışma saatleri | Bilgi yalnız harita görselinde ya da formda |
| İşletme bilgisi kodu | Ad, adres, telefon ve tür için yapılandırılmış veri | Hiç yok ya da başka bir adresi gösteriyor |
| Sık sorulan sorular | Müşterinin gerçek sorularına kısa cevaplar | Bölüm yok ya da açılır menüde gizli |
İşletme bilgisinin koda dökülmesini yapay zeka için schema işaretlemesi yazısında ayrıntılı anlattık. Bazı siteler bot erişimine ek olarak bir llms.txt dosyası da koyuyor; bunun ne işe yarayıp yaramadığını llms.txt değerlendirmemizde dürüstçe tartıştık. Kısaca: llms.txt, robots.txt'deki bir engeli aşmaz; önce kapının açık olması gerekir.
Welda bu işi nasıl yapar?
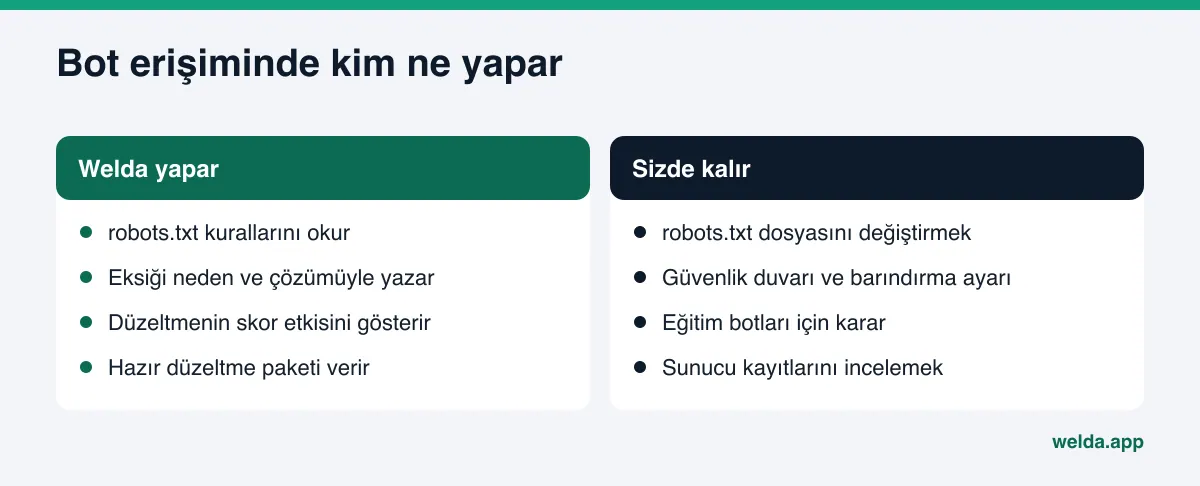
Welda'nın bu konudaki işi iki parçadan oluşur: önce erişim sorununu açık bir dille göstermek, sonra düzeltmeyi işletmenin uygulayabileceği hale getirmek.
Ücretsiz site analizinde erişim kontrolü. Analiz, ana sayfanızı ve hizmetler, fiyatlar, hakkımızda, iletişim gibi birkaç iç sayfanızı okurken robots.txt dosyanıza da bakar. Yapay zeka botlarının siteye girmesini engelleyen bir kural varsa bunu teknik skorun içinde bir eksik olarak gösterir. Raporda üç şey yazar: ne görüldüğü (ör. hangi bot için hangi kural), bunun neden önemli olduğu ve nasıl düzeleceği. Aynı raporda hangi düzeltmenin skoru ne kadar artıracağını gösteren simülasyon da vardır; robots.txt düzeltmesinin size kaç puan kazandıracağını diğer eksiklerle yan yana görür, önce neyi yapacağınıza buna göre karar verirsiniz. Rapor sonunda siteye eklenecek hazır düzeltme paketi gelir; bu pakette işletme bilgisi kodu da bulunur. Rapor PDF olarak indirilebilir, böylece sitenizi yöneten kişiye doğrudan iletebilirsiniz.
Analiz ayrıca müşterilerin sorabileceği 5 soruyu web araması yapabilen bir yapay zeka asistanına sorar ve cevaplarda işletme adınızın geçip geçmediğine bakar. Robots.txt'de bir engel bulunduysa ve adınız bu sorularda hiç geçmiyorsa, iki bulgu birlikte okunduğunda nereden başlamanız gerektiği netleşir. Bu tek seferlik bir ölçümdür; düzenli takip değildir.
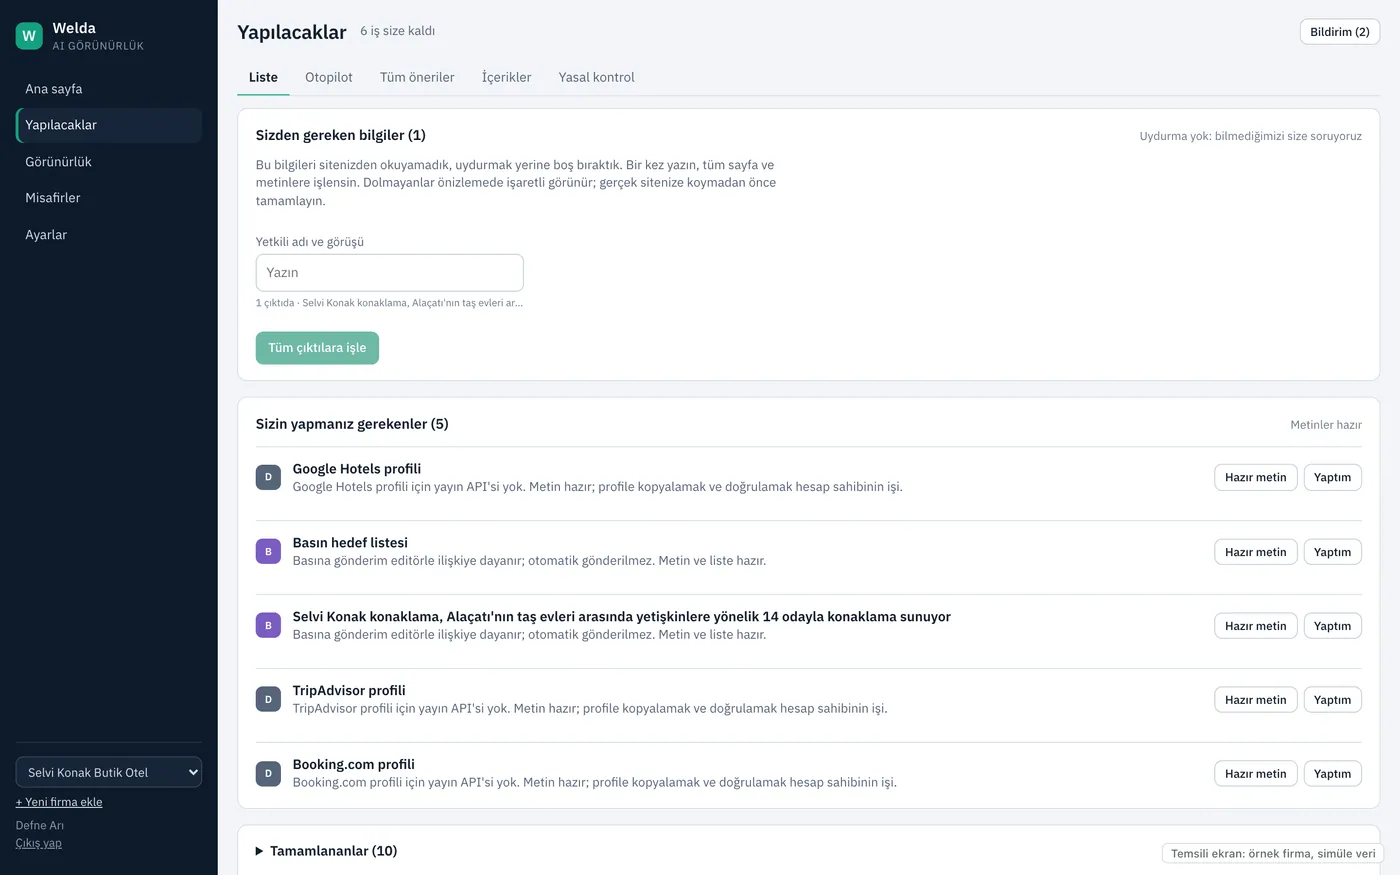
Panelde yapılacaklar listesi. Erken erişimdeki Welda panelinde bu tür bir eksik, yapılacaklar listesine düşer. Robots.txt ya da güvenlik duvarı ayarı sitenin sunucu ve barındırma tarafında durduğu için Welda bunu sizin yerinize değiştirmez; iş "elle yapılacak" olarak listelenir ve yanında uygulanacak hazır metin durur. Siz ya da sitenizi yöneten kişi değişikliği yapar, "Yaptım" ile işaretlersiniz. WordPress sitelerde Welda, ayrı bir Editör kullanıcısıyla bağlanarak içerikleri taslak olarak açabilir; ama erişim ayarı gibi altyapı kararları işletmede kalır.
Kapı açıldıktan sonraki iş, botların gördüğü içeriği güçlendirmektir. Panel, müşterilerin soracağı soruları ChatGPT, Gemini, Perplexity ve Google AI'a üçer kez sorarak adınızın hangi soruda geçtiğini izler. Erişim düzeldikten sonra yeni içeriğin cevaplara yansıması genelde haftalar sürdüğü için, bu ölçüm değişikliğin işe yarayıp yaramadığını görmenin yoludur. Welda'nın genel yaklaşımını AI görünürlük sayfasında bulabilirsiniz.
Bir not: Welda paneli erken erişimdedir ve sırayla, bugün Türkiye'deki işletmelerle açılıyor. Dört motorlu düzenli ölçüm erken erişim sürecinde ekleniyor; paneldeki örnek ekranlar temsili veriyle gösterilir. Bugün herkesin kullanabildiği parça ücretsiz site analizidir. Fiyat erken erişim görüşmesinde konuşulur.
Sınırlar: robots.txt'yi açmak neyi çözmez?
Erişim, görünürlüğün şartıdır ama kendisi değildir. Bu konuda dürüst olmak gerekiyor:
- Açık kapı, cevapta yer garantisi değildir. Bot sitenizi okuyabilir ve yine de rakibinizi önerebilir. Cevap, içeriğin netliğine, dış kaynaklara ve yorumlara da bağlıdır. Welda da sıralama ya da "ChatGPT'de çıkma" garantisi vermez; bu konuda neden kimsenin garanti veremeyeceğini ChatGPT'de birinci sıra garantisi yazısında açıkladık.
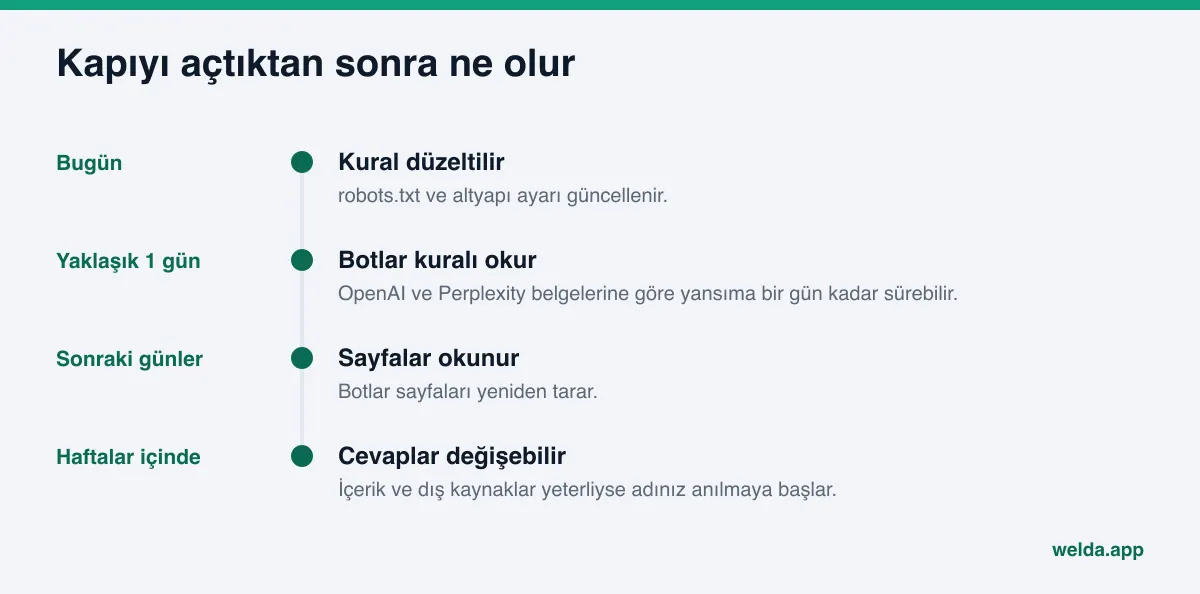
- Etki hemen görünmez. OpenAI, robots.txt değişikliğinin arama sistemlerine yansımasının yaklaşık 24 saat sürebileceğini, Perplexity de değişikliklerin 24 saate kadar sürebileceğini belgelerinde yazıyor. Ama botun sayfayı yeniden okuması ile cevapların değişmesi ayrı şeylerdir; ikincisi genelde haftalar alır.
- Analiz sunucu kayıtlarınızı görmez. Ücretsiz analiz robots.txt kurallarını ve sayfaların okunabilirliğini değerlendirir; botların sitenize gerçekte kaç kez geldiğini ölçmez. Bunun için kendi erişim kayıtlarınıza bakmanız gerekir.
- Altyapı ayarları işletmede kalır. İçerik dağıtım ağı, güvenlik duvarı ve barındırma ayarlarına Welda erişmez. Bunları siz ya da sitenizi yöneten kişi değiştirir.
- Eğitim kararı sizindir. Hangi botun içeriğinizi eğitimde kullanabileceği bir işletme tercihi ve gerektiğinde hukuki bir değerlendirmedir. Bu yazı hukuki danışmanlık değildir.
Welda bilmediği bilgiyi yazmaz, işletmeye sorar; onaysız hassas içerik yayınlamaz ve sahte yorum üretmez. Olumsuz yorumlar, dizin hesapları ve basın çalışması da işletmede kalır.
Yapay zeka botları erişim kontrol listesi
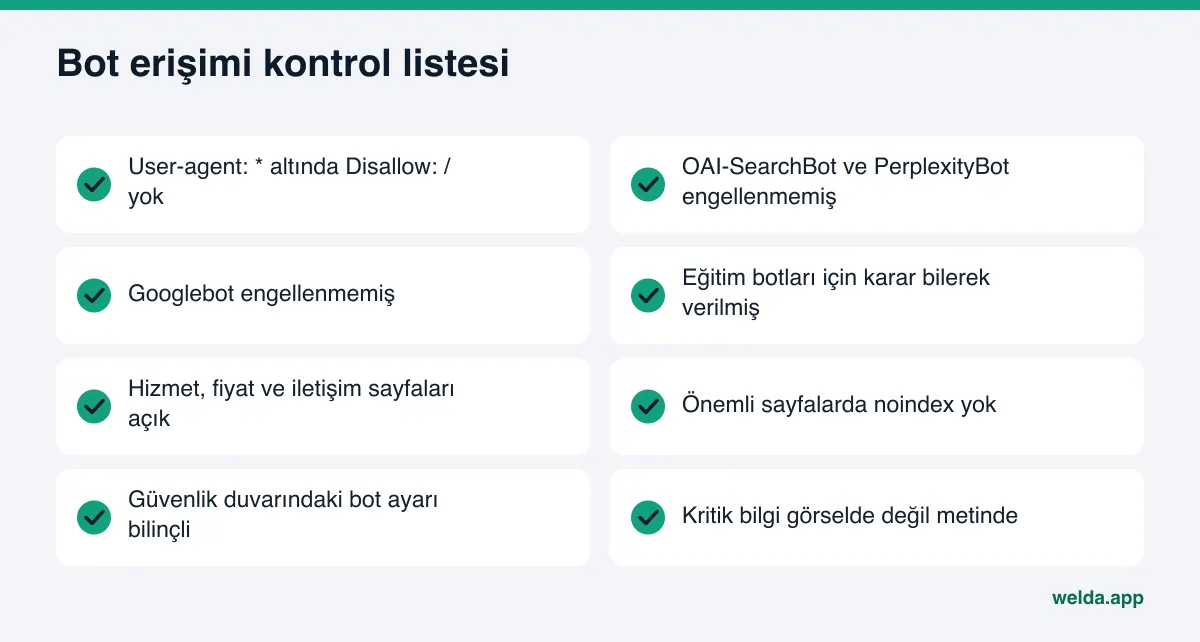
Aşağıdaki listeyi yılda iki kez, bir de site yeniden yapıldığında ya da barındırma değiştiğinde gözden geçirin. Site değişikliklerinde robots.txt'nin sıfırlanması sık görülür.
| Kontrol | Nereye bakılır | Kim yapar |
|---|---|---|
User-agent: * altında Disallow: / yok | robots.txt | Siz |
| OAI-SearchBot ve PerplexityBot engellenmemiş | robots.txt | Siz |
| Googlebot engellenmemiş | robots.txt | Siz |
| Eğitim botları için karar bilerek verilmiş | robots.txt | İşletme sahibi |
| Hizmet, fiyat ve iletişim sayfaları açık | robots.txt ve sayfa etiketleri | Siz ya da site yöneticisi |
Önemli sayfalarda noindex yok | Sayfa kaynağı | Site yöneticisi |
| Güvenlik duvarında yapay zeka botu engeli bilinçli | Altyapı paneli | Barındırma ya da site yöneticisi |
| Kritik bilgi görselde değil metinde | Sayfanın kendisi | Siz |
Liste temizse sıradaki iş, botların okuduğu içeriği güncel tutmaktır. Eski sayfaların yapay zeka için nasıl gözden geçirileceğini eski içerikleri yapay zeka için güncellemek yazısında anlattık. Google aramasından gelen trafiğiniz AI Bakışı yüzünden düştüyse, Googlebot erişimini kapatmak çözüm değildir; bunun yerine ne yapılacağını AI Bakışı yüzünden trafik kaybı yazısında ele aldık.
Sık sorulan sorular
Robots.txt dosyam yoksa yapay zeka botları siteme girebilir mi?
Genel olarak evet. Dosyanın olmaması, botlar için özel bir kısıt olmadığı anlamına gelir. Yine de güvenlik duvarı ya da eklenti düzeyinde ayrı bir engel olabilir; bunu robots.txt'den göremezsiniz.
GPTBot'u engellersem ChatGPT'de görünmez olur muyum?
OpenAI'ın belgesine göre GPTBot eğitim içindir, ChatGPT arama cevaplarında gösterilmeyi ise OAI-SearchBot belirler. GPTBot'u kapatıp OAI-SearchBot'u açık bırakmak mümkündür.
Google-Extended'ı engellemek AI Bakışı'ndan çıkmam demek mi?
Google'ın belgesine göre Google-Extended, Google Arama'ya dahil olmayı etkilemez. AI Bakışı ve AI Modu, normal Google Arama kontrollerini, yani Googlebot ve sayfa etiketlerini izler.
Robots.txt'yi değiştirdim, ne zaman sonuç görürüm?
Botların yeni kuralı okuması sağlayıcıların belgelerine göre bir gün kadar sürebilir. Cevaplarda adınızın geçmeye başlaması ise içeriğe ve dış kaynaklara bağlıdır ve genelde haftalar alır.
Welda robots.txt dosyamı kendisi değiştirir mi?
Hayır. Welda sorunu gösterir ve uygulanacak düzeltmeyi hazır verir. Robots.txt, güvenlik duvarı ve barındırma ayarları sizde ya da sitenizi yöneten kişide kalır.
Ücretsiz analiz botların gerçekten geldiğini kanıtlar mı?
Hayır. Analiz robots.txt kurallarını ve sayfaların okunabilirliğini değerlendirir. Botların sitenize kaç kez geldiğini görmek için sunucu erişim kayıtlarınıza bakmanız gerekir.
Sonuç: önce kapıyı kontrol edin
Yapay zeka görünürlüğü için yazılan her içerik, botların siteye girebildiği varsayımına dayanır. Bu varsayımı kontrol etmek yarım saatlik bir iştir ve çoğu zaman tek bir satırı düzeltmekle biter. Kendi sitenizde robots.txt, sayfa başlıkları, işletme bilgisi ve diğer eksikleri tek raporda görmek için ücretsiz site analizini başlatın. Rapor, ne görüldüğünü, neden önemli olduğunu ve nasıl düzeleceğini her eksik için ayrı ayrı yazar.