Greifen KI-Bots auf meine Website zu, und wie prüfe ich das? Der schnellste Weg führt über Ihre robots.txt: Dort steht, ob die Crawler hinter ChatGPT, Perplexity und Google Ihre Seiten lesen dürfen. Werden sie abgewiesen, kennt die KI Ihr Angebot nur aus fremden Quellen oder gar nicht. Dieser Beitrag erklärt, welche Bots es gibt, wie Sie den Zugriff Schritt für Schritt prüfen und welche Bots ein Unternehmen, das Kunden gewinnen will, hereinlassen sollte.
Die Frage klingt technisch, die Folgen sind geschäftlich. Fragt jemand ChatGPT nach „einer Zahnarztpraxis in Graz mit Terminen am Samstag“ oder nach „einem Elektriker in Zürich, der kurzfristig kommt“, entsteht die Antwort aus den Seiten, die die Suchmaschine lesen kann. Ein Crawler, der nicht auf Ihre Website kommt, erfährt Leistungen, Öffnungszeiten und Einzugsgebiet aus Gelbe Seiten, einem Branchenverzeichnis oder von der Seite eines Wettbewerbers. Im deutschsprachigen Raum heißt diese Arbeit meist GEO (Generative Engine Optimization) oder schlicht KI-Sichtbarkeit; in den USA ist dafür AEO (Answer Engine Optimization) üblich, gemeint ist dasselbe. Jede Maßnahme für KI-Sichtbarkeit setzt voraus, dass die Tür offen ist. Wenn Sie den Stand Ihrer eigenen Website sofort sehen möchten: Die kostenlose Website-Analyse liest auch Ihre robots.txt und zeigt im technischen Teil, ob KI-Crawler ausgesperrt sind.
Warum die Frage „Greifen KI-Bots auf meine Website zu?“ am Anfang steht
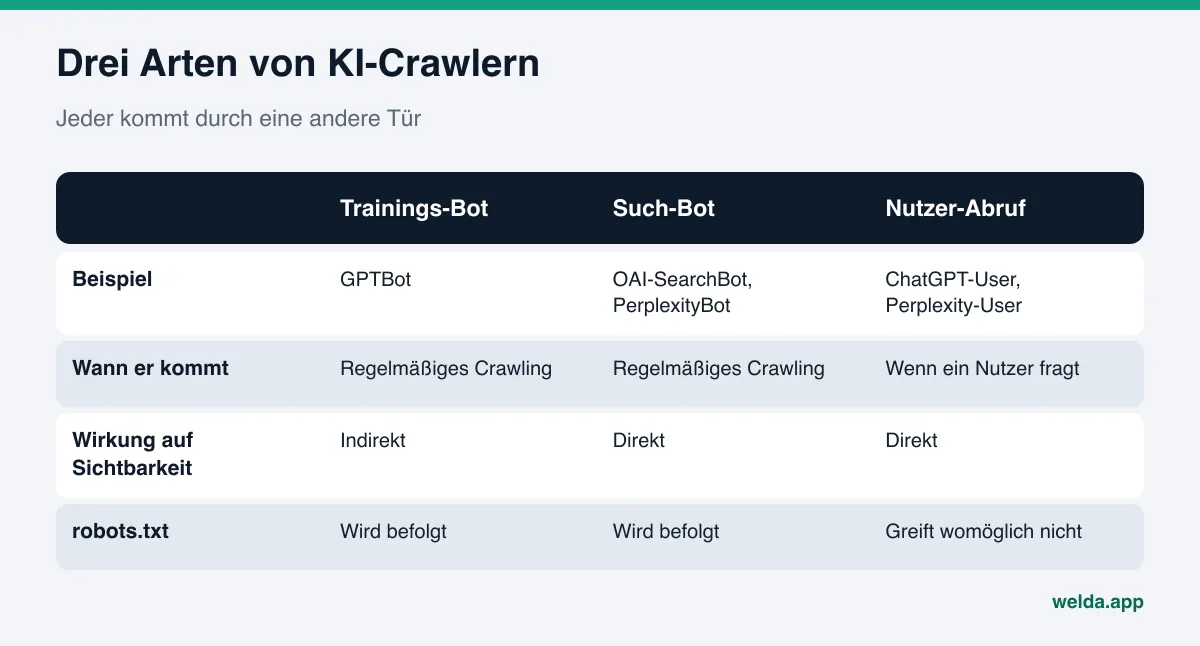
Dass Google eine Website crawlen muss, bevor sie in der Suche erscheint, wissen die meisten Unternehmer. Bei der KI-Suche ist es unübersichtlicher. Jeder Anbieter betreibt mehrere Bots, und jeder kommt aus einem anderen Grund. Einer sammelt Texte, die zum Training von Modellen genutzt werden können. Einer baut den Index auf, aus dem Suchantworten entstehen. Ein dritter ruft eine Seite in dem Moment ab, in dem ein Nutzer eine Frage stellt. Wer nicht weiß, welche dieser Türen er geschlossen hat, kann auf die Frage „Sperren wir KI aus?“ nur halb antworten.
Für ein Unternehmen gibt es drei Ausgangslagen:
- Die Tür ist offen, die Inhalte werden gelesen. Die Bots kommen, lesen Ihre Seiten, Ihre Unternehmensdaten können in Antworten einfließen. Ob Sie genannt werden, hängt jetzt von Ihren Inhalten und von externen Quellen ab.
- Die Tür ist zu, und niemand weiß es. Eine alte robots.txt-Vorlage, ein Sicherheits-Plugin oder eine Einstellung beim Hoster oder CDN weist die Bots ab. Die Inhaberin oder der Inhaber erfährt davon meist nichts.
- Die Tür ist bewusst zu. Sie haben bestimmte Bots gesperrt, weil Ihre Inhalte nicht ins Training fließen sollen. Das ist eine legitime Entscheidung. Wurde dabei aber auch der Such-Crawler erfasst, zahlen Sie dafür mit fehlender Sichtbarkeit in KI-Antworten.
Die zweite Lage ist die häufigste und am leichtesten zu beheben. Ein Betrieb kann monatelang Leistungsseiten und FAQ ausbauen, während eine einzige Zeile in der robots.txt einen Teil dieser Arbeit von der KI-Suche fernhält. Deshalb beginnt GEO mit dem Zugriff, nicht mit dem Inhalt.
Welche KI-Crawler gibt es, und was tut jeder davon?
Die Tabelle fasst die Bots zusammen, die OpenAI, Perplexity und Google in ihrer eigenen Dokumentation beschreiben. Namen und Zwecke stammen aus den offiziellen Seiten: Crawler-Dokumentation von OpenAI, Crawler-Dokumentation von Perplexity und Übersicht der Google-Crawler. Diese Listen ändern sich; prüfen Sie die Quelle noch einmal, bevor Sie Ihre Datei anpassen.
| Bot oder Token | Anbieter | Wozu er kommt | Folge einer Sperre |
|---|---|---|---|
OAI-SearchBot | OpenAI | Findet Websites für die Suchfunktionen von ChatGPT | Laut OpenAI wird Ihre Seite in ChatGPT-Suchantworten nicht angezeigt |
GPTBot | OpenAI | Sammelt Inhalte, die zum Modelltraining genutzt werden können | Signalisiert, dass Ihre Inhalte nicht ins Training sollen |
ChatGPT-User | OpenAI | Ruft eine Seite ab, wenn ein Nutzer fragt | Da der Nutzer den Abruf auslöst, greift die robots.txt möglicherweise nicht |
PerplexityBot | Perplexity | Zeigt und verlinkt Websites in Perplexity-Suchergebnissen | Geringere Chance, in Perplexity-Antworten zitiert zu werden |
Perplexity-User | Perplexity | Holt eine Seite für die Frage eines Nutzers | Laut Perplexity ignoriert er die robots.txt in der Regel |
Googlebot | Speist die Google-Suche, einschließlich KI-Übersichten und KI-Modus | Ihre Inhalte können weder in der Suche noch in KI-Funktionen genutzt werden | |
Google-Extended | Kein eigener Crawler, sondern ein Steuer-Token für Gemini-Training und einige Gemini-Nutzungen | Laut Google ohne Einfluss auf die Aufnahme in die Google-Suche |
Die wichtigste Erkenntnis: Training und Suche sind getrennte Türen. Bei OpenAI können Sie GPTBot sperren und OAI-SearchBot offen lassen. Bei Google gibt es für KI-Übersichten und den KI-Modus keinen eigenen Bot. Googles Hinweise zu KI-Funktionen sagen, dass eine Seite indexiert und mit Snippet in der Suche darstellbar sein muss, ohne zusätzliche technische Voraussetzungen. Wer den Googlebot sperrt, verschwindet also aus der klassischen Suche und aus den KI-Übersichten zugleich.
So prüfen Sie Schritt für Schritt, ob KI-Bots auf Ihre Website zugreifen
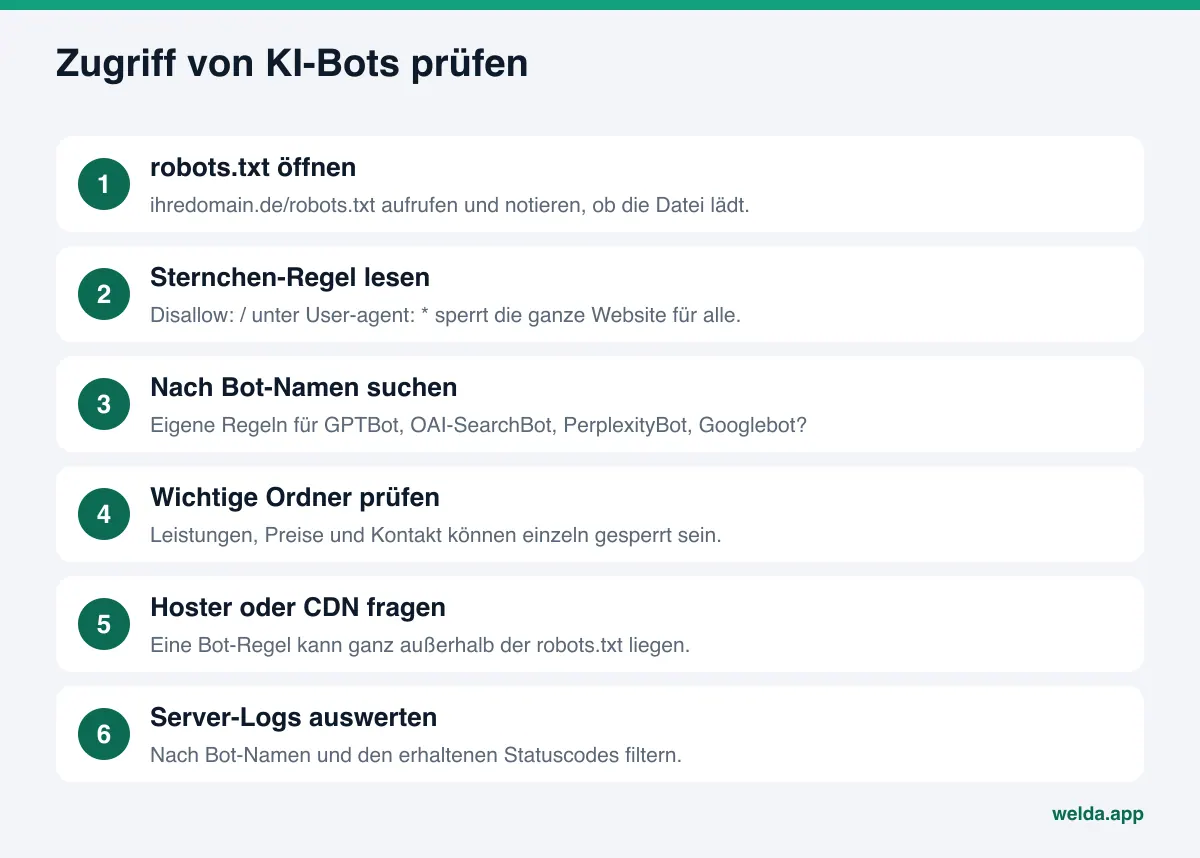
Für die meisten Schritte brauchen Sie keine Entwicklerin und keinen Entwickler. Ein Browser und eine halbe Stunde genügen. Gehen Sie in dieser Reihenfolge vor:
- robots.txt öffnen. Geben Sie
ihredomain.de/robots.txtim Browser ein. Lädt die Datei nicht oder kommt eine Fehlermeldung, notieren Sie das. Eine fehlende Datei bedeutet meist, dass nichts eingeschränkt ist; ein Serverfehler ist dagegen ein anderes Signal und eine Rückfrage wert. - Die Sternchen-Regel lesen. Regeln unter
User-agent: *gelten für alle Bots, die nicht eigens genannt sind. Steht dortDisallow: /, ist die gesamte Website für alle gesperrt. Oft ist das ein Überbleibsel aus der Testumgebung, das beim Livegang vergessen wurde. - Nach Bot-Namen suchen. Suchen Sie nach
GPTBot,OAI-SearchBot,PerplexityBot,GooglebotundGoogle-Extended. Ein Bot mit eigener Regelgruppe folgt dieser Gruppe, nicht der Sternchen-Regel. - Wichtige Verzeichnisse prüfen. Auch wenn die Website offen ist, können Ordner wie
/leistungen,/preiseoder/kontakteinzeln gesperrt sein. Gerade dort stehen die Informationen, nach denen Kunden fragen. - Tags auf Seitenebene ansehen. Enthält der Quelltext einer Seite
noindexodernosnippet, kann Google sie in KI-Funktionen womöglich nicht nutzen, selbst wenn die robots.txt offen ist. - Beim Hoster oder CDN nachfragen. Liegt Ihre Website hinter einem CDN oder einer Web Application Firewall, kann es dort eine eigene Regel für KI-Bots geben. In der robots.txt sehen Sie diese nicht; fragen Sie die Person, die Ihre Website betreut, oder Ihren Hoster.
- Server-Logs auswerten. Haben Sie Zugriff auf die Zugriffsprotokolle, filtern Sie die letzten Wochen nach diesen Bot-Namen und den Statuscodes, die sie erhalten haben. Taucht ein Bot nie auf oder wird er ständig abgewiesen, liegt hier das Problem.
Der letzte Schritt liefert den stärksten Beleg, denn die robots.txt ist nur eine Bitte; die Logs zeigen, was tatsächlich passiert ist. Für die meisten kleinen Betriebe reichen die ersten sechs Schritte. Beachten Sie aber: Ein Bot-Name im Log beweist allein noch nicht, dass die Anfrage wirklich vom jeweiligen Anbieter stammt. Wie man die Crawler verifiziert, beschreiben die Anbieter in der oben verlinkten Dokumentation.
Warum KI-Crawler oft unbeabsichtigt ausgesperrt werden
Die meisten Sperren sind keine Entscheidungen, sondern angesammelte Einstellungen. Typische Ursachen:
- Regel aus der Testphase.
Disallow: /wurde gesetzt, um die Seite während der Entwicklung zu verbergen, und beim Livegang nicht entfernt. - Kopierte Sperrlisten. Im Netz kursierende Listen gegen „böse Bots“ enthalten manchmal auch KI-Such-Crawler. Die Liste wird eingefügt, ohne dass jemand sie liest.
- Sicherheits-Plugins. Manche Plugins drosseln unbekannte Crawler oder schicken sie auf eine Prüfseite. Der Bot sieht dann diese Seite statt Ihrer Inhalte.
- Voreinstellungen der Infrastruktur. Cloudflare hat im Juli 2025 angekündigt, dass neue Domains bei der Anmeldung gefragt werden, ob KI-Crawler zugelassen werden sollen. Welche Option gewählt wurde, weiß meist die Person, die die Website eingerichtet hat, nicht der Betrieb selbst.
- Informationen nur im Bild. Keine Sperre, aber mit ähnlicher Wirkung: Stehen Öffnungszeiten, Speisekarte oder Preise nur in einer Grafik, kommt der Bot zwar herein, kann den Text aber nicht lesen.
- Seiten hinter einem Login. Sind Leistungsdetails oder Preise nur für Mitglieder sichtbar, wird kein Crawler sie je sehen.
Bei Baukastensystemen ist der Zugriff auf die robots.txt teils eingeschränkt. Wo diese Einstellung bei Wix liegt, behandeln wir im Beitrag zu Wix und GEO.
Welchen KI-Bots sollten Sie den Zugriff erlauben?
Trennen Sie zwei Fragen: „Sollen meine Inhalte in KI-Antworten als Quelle dienen?“ und „Sollen meine Inhalte zum Training von Modellen genutzt werden?“ Für einen lokalen Betrieb, der Kunden gewinnen will, lautet die erste Antwort fast immer ja. Die zweite ist eine unternehmerische Abwägung. Wer Inhalte selbst verkauft, etwa Kurse, Fachpublikationen oder Ratgeber, möchte das Training eher ausschließen. Ob und wie ein solcher Vorbehalt rechtlich wirkt, ist eine Frage des Urheberrechts im jeweiligen Land; dieser Beitrag ist keine Rechtsberatung.
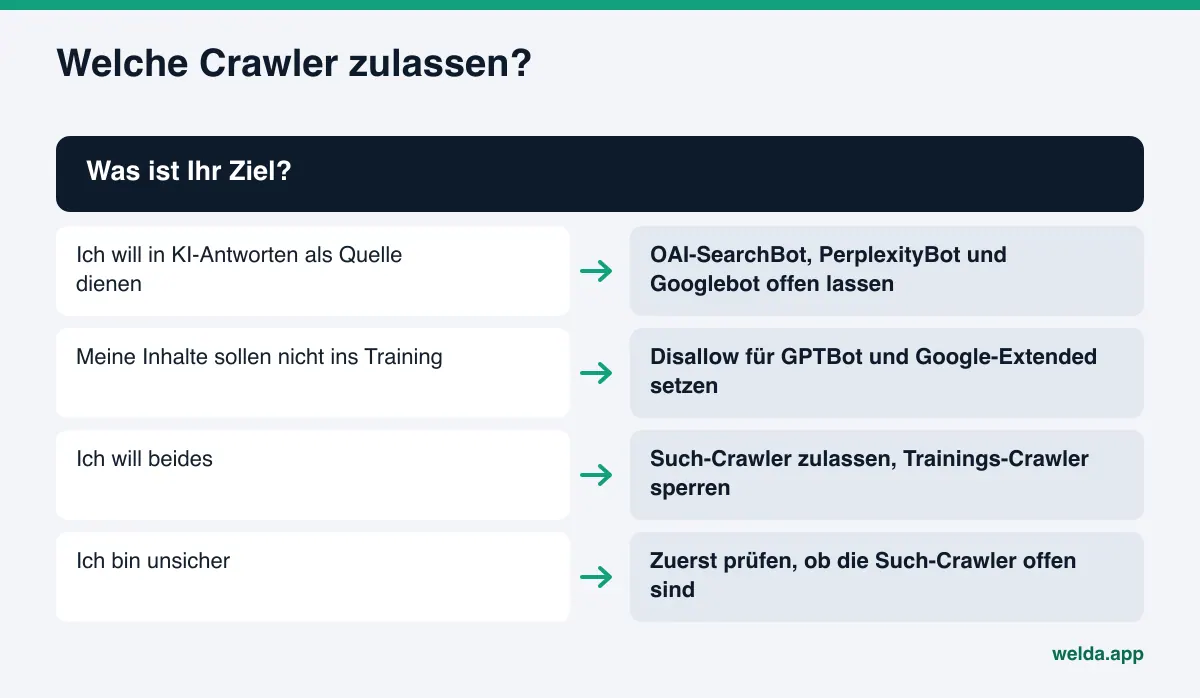
Ein Betrieb, der Such-Crawler zulassen und den Trainings-Crawler ausschließen möchte, könnte eine robots.txt wie die folgende verwenden. Das ist nur ein Beispiel. Passen Sie es mit der Person an, die Ihre Website betreut, und löschen Sie keine bestehenden Regeln.
User-agent: OAI-SearchBotAllow: /User-agent: PerplexityBotAllow: /User-agent: GPTBotDisallow: /User-agent: *Disallow: /admin/
Der Googlebot hat in diesem Beispiel keine eigene Gruppe und folgt daher der Sternchen-Regel: Alles außer dem Admin-Bereich ist offen. Wenn Sie eine Regel für Google-Extended ergänzen, bedenken Sie, dass sie Gemini-Training und einige Gemini-Nutzungen betrifft, nicht Ihr Erscheinen in den KI-Übersichten.
Noch ein Vorbehalt: Für Abrufe, die ein Nutzer in Echtzeit auslöst (ChatGPT-User, Perplexity-User), schreiben die Anbieter selbst, dass die robots.txt möglicherweise nicht greift. Für diese Bots ist sie also kein verlässliches Schloss. Die eigentliche Entscheidung über Ihre KI-Sichtbarkeit treffen Sie über die Such-Crawler.
Was sollten KI-Crawler finden, wenn die Tür offen ist?
Den Zugriff zu reparieren ist die halbe Arbeit. Ein Crawler, der hereinkommt, aber keine klaren Informationen findet, nennt Sie trotzdem womöglich nicht. Prüfen Sie nach der Freigabe, ob diese Seiten lesbar sind:
| Seite oder Angabe | Was der Crawler sucht | Häufige Lücke |
|---|---|---|
| Startseite | Was Sie tun, wo und für wen | Ein Slogan, aber keine Leistung und kein Ort im Text |
| Leistungen | Jede Leistung mit Namen und kurzer Beschreibung | Leistungen nur als Bildkacheln |
| Kontakt | Adresse, Telefon, Öffnungszeiten | Angaben nur in der eingebetteten Karte oder im Formular |
| Strukturierte Daten | Name, Adresse, Telefon und Branche im Code | Fehlen oder verweisen auf eine alte Adresse |
| Impressum und Über uns | Wer hinter dem Betrieb steht | Angaben weichen vom Google Unternehmensprofil ab |
| FAQ | Kurze Antworten auf echte Kundenfragen | Keine FAQ oder Antworten in eingeklappten Elementen |
Wie Sie Unternehmensdaten in Code übersetzen, zeigt unser Beitrag zu Schema-Markup für KI-Suche. Sind die Seiten lesbar, aber veraltet, hilft der Leitfaden, alte Inhalte für KI-Suche zu aktualisieren.
Wie Welda den Zugriff von KI-Bots prüft und die Behebung vorbereitet
Weldas Arbeit an diesem Thema hat zwei Teile: das Zugriffsproblem verständlich zeigen und die Lösung so aufbereiten, dass Ihr Betrieb oder Ihre Agentur sie umsetzen kann.
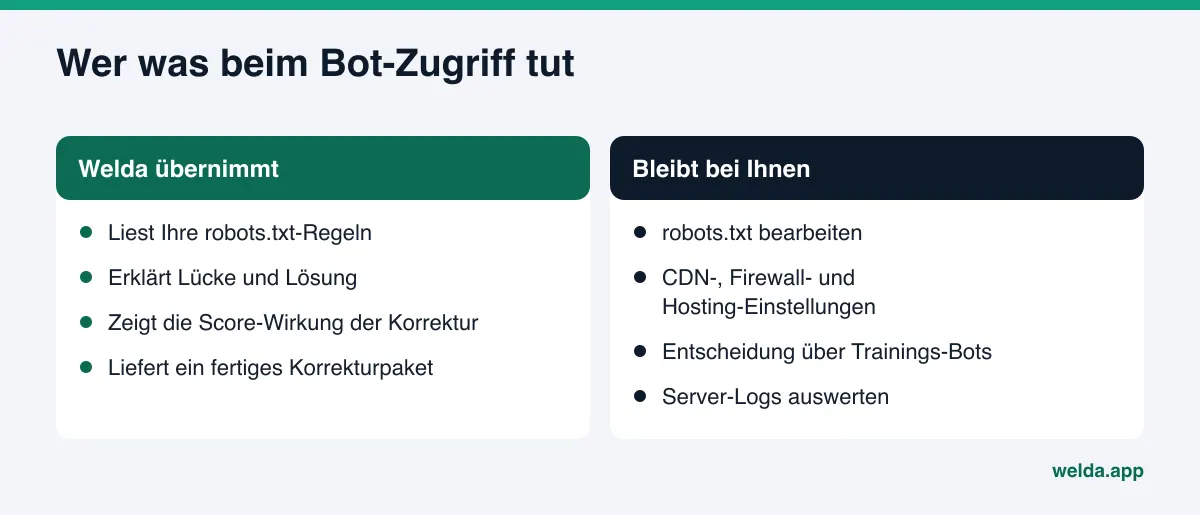
Zugriffsprüfung in der kostenlosen Analyse. Die Analyse liest Ihre Startseite und einige Unterseiten (Leistungen, Preise, Über uns, Kontakt) und dabei auch Ihre robots.txt. Hält eine Regel KI-Crawler fern, erscheint das als Lücke im technischen Score. Zu jeder Lücke steht im Bericht, was gefunden wurde, etwa welche Regel welchen Bot betrifft, warum das wichtig ist und wie es sich beheben lässt. Eine Simulation zeigt, um wie viele Punkte jede Korrektur den Score anheben würde. So sehen Sie die robots.txt-Korrektur neben den anderen Lücken und entscheiden, was zuerst drankommt. Am Ende steht ein fertiges Korrekturpaket inklusive strukturierter Unternehmensdaten, und der Bericht lässt sich als PDF an Ihre Webagentur oder Ihren Hoster weitergeben. Die kostenlose Analyse funktioniert auf Deutsch.
Zusätzlich stellt die Analyse 5 Fragen, die Kunden stellen könnten, an einen KI-Assistenten mit Websuche und prüft, ob Ihr Unternehmensname in den Antworten vorkommt. Blockiert die robots.txt KI-Crawler und taucht Ihr Name in keiner Antwort auf, ergibt sich aus beiden Befunden zusammen ein klarer Ausgangspunkt. Das ist eine einmalige Messung, kein laufendes Tracking.
Die Aufgabenliste im Welda-Dashboard. Im Welda-Dashboard landet eine solche Lücke auf einer einzigen Aufgabenliste. robots.txt und Firewall-Einstellungen liegen auf Server- und Hosting-Seite, deshalb ändert Welda sie nicht für Sie. Die Aufgabe wird als manuelle Arbeit geführt, mit dem genauen Text zur Umsetzung daneben. Sie oder Ihre Agentur nehmen die Änderung vor und haken sie ab. Bei WordPress-Websites kann sich Welda über einen eigenen Redakteur-Zugang verbinden und Inhalte als Entwurf anlegen; Infrastruktur-Entscheidungen wie der Crawler-Zugriff bleiben aber bei Ihnen.
Ist die Tür offen, geht es darum, das zu stärken, was die Crawler lesen. Das Dashboard stellt die Fragen Ihrer Kunden an ChatGPT, Gemini, Perplexity und Google AI, jeweils dreimal, und zeigt, bei welchen Fragen Ihr Name fällt. Da neue Inhalte meist Wochen brauchen, bis sie sich in KI-Antworten zeigen, sehen Sie so, ob eine Korrektur gewirkt hat.
Zum Stand des Produkts: Das Welda-Dashboard ist im Early Access und öffnet zuerst für Unternehmen in der Türkei. Die regelmäßige Messung über vier KI-Suchmaschinen wird im Lauf des Early Access ergänzt; Beispielansichten des Dashboards zeigen repräsentative Daten. Für alle nutzbar ist heute die kostenlose Website-Analyse, die auf Deutsch und Englisch funktioniert. Über Preise sprechen wir im Early-Access-Gespräch.
Grenzen: Was eine offene robots.txt nicht löst
Zugriff ist Voraussetzung für KI-Sichtbarkeit, aber nicht die Sichtbarkeit selbst. Das sollte man offen sagen:
- Offene Tür heißt nicht garantierte Nennung. Ein Crawler kann Ihre Website lesen und trotzdem einen Wettbewerber empfehlen. Die Antwort hängt auch von der Klarheit Ihrer Inhalte, von externen Quellen wie Google Unternehmensprofil, Jameda, ProvenExpert oder Trustpilot und von Ihren Bewertungen ab. Welda garantiert weder Platzierungen noch einen Platz in ChatGPT; warum das niemand seriös kann, erklären wir im Beitrag zur ChatGPT-Platzierung mit Garantie.
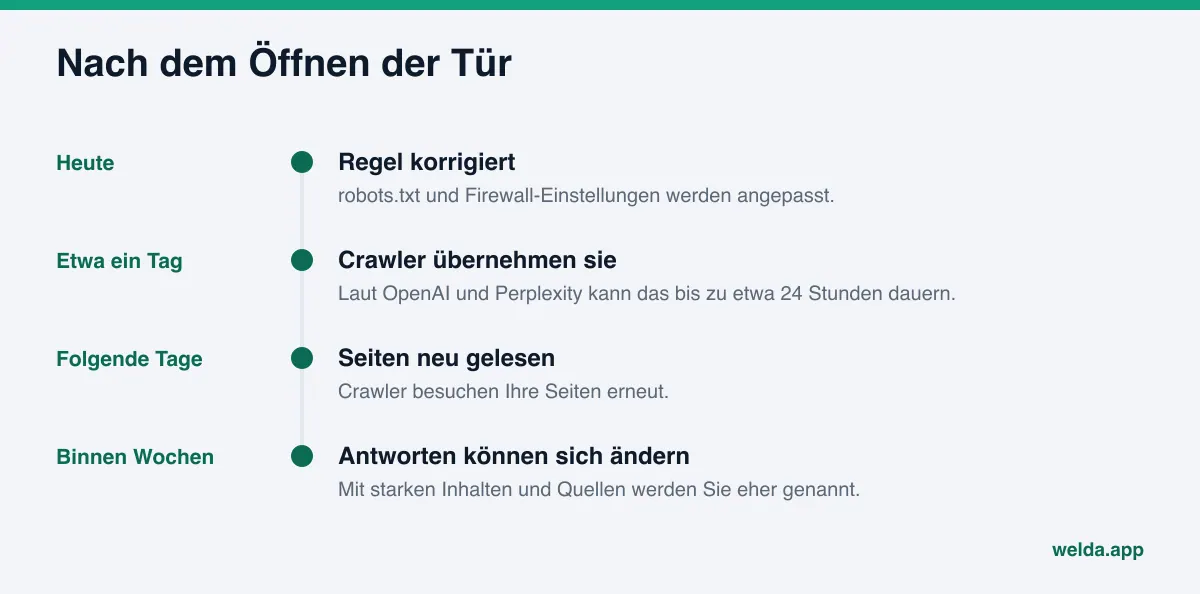
- Die Wirkung kommt nicht sofort. OpenAI schreibt, dass seine Suchsysteme nach einer robots.txt-Änderung etwa 24 Stunden brauchen können; Perplexity nennt bis zu 24 Stunden. Dass ein Crawler die Seite neu liest und dass sich Antworten ändern, sind aber zwei verschiedene Dinge; Letzteres dauert meist Wochen.
- Die Analyse sieht Ihre Server-Logs nicht. Sie bewertet robots.txt-Regeln und die Lesbarkeit Ihrer Seiten. Wie oft Bots tatsächlich kommen, misst sie nicht; dafür brauchen Sie Ihre eigenen Zugriffsprotokolle.
- Infrastruktur bleibt bei Ihnen. Welda hat keinen Zugriff auf CDN-, Firewall- oder Hosting-Einstellungen. Diese ändern Sie oder Ihre Agentur.
- Die Trainingsentscheidung liegt bei Ihnen. Welche Bots Ihre Inhalte für Training nutzen dürfen, ist eine unternehmerische und gegebenenfalls rechtliche Frage. Keine Rechtsberatung.
Welda schreibt nichts, was es nicht weiß, sondern fragt nach. Es veröffentlicht keine sensiblen Inhalte ohne Freigabe und erzeugt keine gefälschten Bewertungen. Negative Bewertungen, Verzeichniskonten und Pressearbeit bleiben bei Ihrem Betrieb.
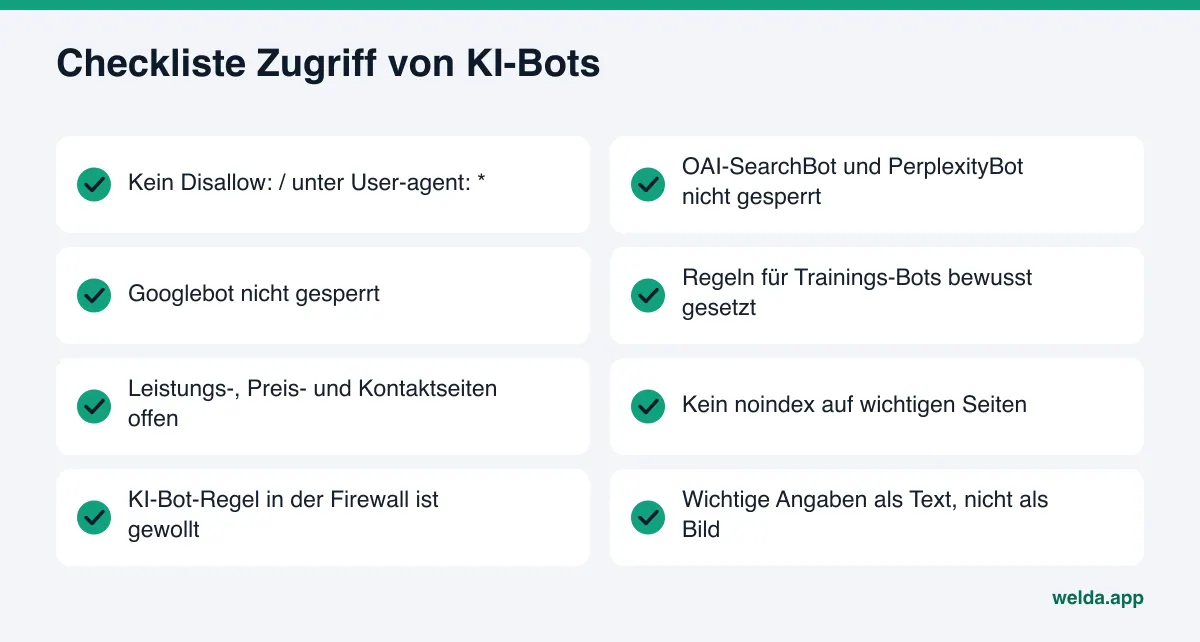
Checkliste: Zugriff von KI-Bots auf Ihre Website
Gehen Sie diese Liste zweimal im Jahr durch, außerdem nach jedem Relaunch und jedem Hoster-Wechsel. Dass die robots.txt bei einem Relaunch zurückgesetzt wird, kommt häufig vor.
| Prüfpunkt | Wo nachsehen | Wer erledigt es |
|---|---|---|
Kein Disallow: / unter User-agent: * | robots.txt | Sie |
| OAI-SearchBot und PerplexityBot nicht gesperrt | robots.txt | Sie |
| Googlebot nicht gesperrt | robots.txt | Sie |
| Regeln für Trainings-Bots bewusst gesetzt | robots.txt | Geschäftsführung |
| Leistungs-, Preis- und Kontaktseiten offen | robots.txt und Seiten-Tags | Sie oder Ihre Agentur |
Kein noindex auf wichtigen Seiten | Quelltext | Agentur |
| KI-Bot-Regel in der Firewall ist gewollt | CDN- oder Hosting-Oberfläche | Hoster oder Agentur |
| Wichtige Angaben als Text, nicht als Bild | Die Seite selbst | Sie |
Ist Ihr organischer Traffic seit den KI-Übersichten gesunken, ist eine Sperre des Googlebots keine Lösung. Was stattdessen hilft, steht im Beitrag zum Traffic-Verlust durch KI-Übersichten.
Häufige Fragen
Können KI-Bots auf meine Website zugreifen, wenn ich keine robots.txt habe?
In der Regel ja. Ohne Datei gibt es keine besonderen Einschränkungen für Crawler. Trotzdem kann es eine Sperre auf Firewall- oder Plugin-Ebene geben, die Sie in der robots.txt nicht sehen.
Verschwinde ich aus ChatGPT, wenn ich GPTBot sperre?
Laut OpenAI dient GPTBot dem Training, während OAI-SearchBot darüber entscheidet, ob Sie in ChatGPT-Suchantworten erscheinen. Sie können GPTBot sperren und OAI-SearchBot offen lassen.
Falle ich aus den KI-Übersichten, wenn ich Google-Extended sperre?
Laut Google beeinflusst Google-Extended die Aufnahme in die Google-Suche nicht. KI-Übersichten und KI-Modus folgen den normalen Steuerungen der Suche, also dem Googlebot-Zugriff und den Tags auf Seitenebene.
Ich habe die robots.txt geändert. Wann sehe ich Ergebnisse?
Laut der Dokumentation der Anbieter übernehmen Crawler eine neue Regel innerhalb von etwa einem Tag. Ob Sie in Antworten genannt werden, hängt von Inhalten und externen Quellen ab und dauert meist Wochen.
Ändert Welda meine robots.txt selbst?
Nein. Welda zeigt das Problem und liefert die genaue Korrektur. robots.txt, Firewall und Hosting bleiben bei Ihnen oder Ihrer Agentur.
Beweist die kostenlose Analyse, dass KI-Bots tatsächlich kommen?
Nein. Sie bewertet Ihre robots.txt-Regeln und die Lesbarkeit Ihrer Seiten. Tatsächliche Besuche sehen Sie nur in Ihren Server-Zugriffsprotokollen.
Zuerst die Tür prüfen
Jeder Inhalt, den Sie für KI-Sichtbarkeit schreiben, setzt voraus, dass Crawler ihn erreichen. Diese Annahme zu prüfen dauert eine halbe Stunde und endet oft mit einer einzigen korrigierten Zeile. Um robots.txt, Seitentitel, strukturierte Daten und weitere Lücken in einem Bericht zu sehen, starten Sie die kostenlose Website-Analyse. Zu jeder Lücke erfahren Sie, was gefunden wurde, warum es zählt und wie Sie es beheben.