Warum variieren KI-Antworten? Weil ChatGPT, Gemini, Perplexity und die KI-Funktionen von Google jede Antwort neu erzeugen. Sie wählen Wörter nach Wahrscheinlichkeit, führen oft in diesem Moment eine Websuche durch und lesen dabei nicht immer dieselben Quellen. Deshalb kann dieselbe Frage in zwei Durchläufen unterschiedliche Betriebe nennen. Ein einzelner Screenshot sagt wenig über Ihre KI-Sichtbarkeit; Sie müssen dieselbe Frage mehrmals stellen und das Ergebnis mit einer Fehlermarge lesen.
Viele Inhaber kennen die Situation. Am Montag fragen Sie ChatGPT nach "einem guten Zahnarzt in Schwabing" und Ihre Praxis steht an zweiter Stelle. Am Dienstag fragen Sie erneut, und Sie fehlen. Am Mittwoch fragt Ihre Praxismanagerin auf ihrem Handy und sieht Sie an vierter Stelle. Welche Antwort stimmt? Dieser Beitrag erklärt verständlich, warum KI-Antworten variieren, und zeigt dann, wie Sie Ihre Sichtbarkeit in der KI-Suche trotzdem verlässlich messen. Genau diese Messung ist die Grundlage von GEO (Generative Engine Optimization). Wenn Sie zuerst sehen möchten, wie KI Ihre Website heute liest, starten Sie die kostenlose KI-Sichtbarkeitsanalyse. Sie listet auf, was fehlt und wie Sie jeden Punkt beheben.
Warum KI-Antworten variieren: fünf Ursachen
In der klassischen Google-Suche sehen zwei Personen, die vom selben Ort denselben Begriff suchen, meist eine ähnliche Liste von Links. Bei KI-Antworten ist das anders. Es gibt keine gespeicherte Liste, die einfach angezeigt wird; die Antwort entsteht in dem Moment, in dem die Frage gestellt wird. Fünf voneinander unabhängige Faktoren sorgen für die Schwankung.
1. Antworten werden erzeugt, nicht nachgeschlagen. Ein Sprachmodell wählt jedes nächste Wort aus einer Reihe wahrscheinlicher Optionen, nicht aus einer einzigen festen. Stellen Sie dieselbe Frage zweimal, kann der erste Satz gleich sein, doch je länger die Antwort wird, desto weiter laufen die Fassungen auseinander. Das ist Bauprinzip, kein Fehler. Die Dokumentation zu Azure OpenAI von Microsoft sagt klar, dass dieselbe Frage mehrfach gestellt wahrscheinlich unterschiedliche Antworten liefert und dass selbst mit der Einstellung für reproduzierbare Ausgaben kein Determinismus garantiert ist. In den Chat-Apps, die Ihre Kunden nutzen, sind solche Einstellungen gar nicht zugänglich.
2. Antworten stützen sich auf eine Live-Websuche. Bei Fragen nach einer Empfehlung durchsuchen KI-Assistenten häufig in diesem Moment das Web. Google schreibt in seiner eigenen Dokumentation, dass KI-Übersichten und der KI-Modus ein Verfahren namens "query fan-out" nutzen können, also mehrere verwandte Suchen zu Unterthemen, und dass die angezeigten Antworten und Links variieren, weil beide Funktionen unterschiedliche Modelle und Techniken verwenden können. Welche Teilsuchen laufen und welche Seiten gelesen werden, kann sich von Durchlauf zu Durchlauf unterscheiden.
3. Engines und Modelle werden aktualisiert. ChatGPT, Gemini, Perplexity und die KI-Funktionen von Google verändern sich im Hintergrund. Das Modell wechselt, die Suchschicht wechselt, die Art der Quellenauswahl wechselt. Die Antwort vom letzten Monat kann sich in diesem Monat verschieben, obwohl Sie nichts verändert haben.
4. Die fragende Person ist eine andere. Wortwahl ("bester" oder "günstig" oder "in der Nähe"), Standort, Sprache, ob jemand angemeldet ist und, wenn aktiviert, frühere Chats oder gespeicherte Vorlieben können die Antwort beeinflussen. Was Sie auf Ihrem Handy sehen, muss nicht das sein, was eine Patientin auf ihrem sieht.
5. Die Quellen selbst ändern sich. Ein Wettbewerber ergänzt Fotos in seinem Google Unternehmensprofil, auf Jameda oder ProvenExpert erscheint eine neue Bewertung, ein Eintrag bei Gelbe Seiten wird aktualisiert, ein Lokalportal veröffentlicht eine Übersicht. Bei der nächsten Suche sieht die KI die neue Information. Das ist kein Rauschen, sondern echte Veränderung, und sie verdient Beobachtung.
| Ursache | Was sich verschiebt | Ihr Einfluss |
|---|---|---|
| Erzeugung nach Wahrscheinlichkeit | Wer genannt wird und in welcher Reihenfolge | Keiner; wird durch Wiederholung ausgeglichen |
| Live-Websuche | Gelesene Seiten und genannte Quellen | Indirekt; wächst mit starken, stimmigen Quellen |
| Engine-Updates | Grundverhalten und Quellenauswahl | Keiner; nur beobachten |
| Person und Kontext | Antwort je nach Person und Ort | Keiner; bei der Messung konstant halten |
| Aktualisierte Quellen | Was über Sie und Wettbewerber bekannt ist | Direkt; über Website, Profile und Bewertungen |
Die letzte Zeile ist die wichtigste. Die ersten vier Ursachen betreffen die Messung: Sie können sie nicht steuern, aber berücksichtigen. Die fünfte ist Ihr eigentliches Arbeitsfeld. Je stärker und einheitlicher die Angaben auf Ihrer Website, in Ihren Profilen und in Ihren Bewertungen sind, desto höher ist die Chance, genannt zu werden. Die Schwankung verschwindet nicht, aber ihr Mittelpunkt verschiebt sich zu Ihren Gunsten.
Warum das für lokale Betriebe wichtig ist
Wer die Schwankung nicht kennt, trifft leicht falsche Entscheidungen, und zwar in beide Richtungen.
- Fehlalarm. Ein Durchlauf ohne Nennung, und schon wird die Website umgeschrieben, die Agentur gewechselt oder Inhalt gelöscht. Dabei werden Sie vielleicht in zwei von drei Durchläufen genannt.
- Falsche Sicherheit. Ein Durchlauf mit Platz 1, und das Thema gilt als erledigt. Dabei sehen Sie womöglich nur wenige der Kunden, die genau diese Frage stellen.
- Arbeit an der falschen Stelle. Ein Screenshot legt nahe, ein Wettbewerber sei vorbeigezogen, und Sie beginnen, ihn zu kopieren. Im nächsten Durchlauf taucht er vielleicht gar nicht auf.
- Berichte ohne Prüfbarkeit. Ein Bericht mit einem einzelnen Screenshot "Sie erscheinen in ChatGPT", der nicht sagt, wann, wie oft und unter welchen Bedingungen gefragt wurde, lässt sich nicht nachprüfen.
Aus Kundensicht ist es einfacher. Der Kunde fragt einmal und sieht eine Antwort. Für Sie zählt nicht, was eine einzelne Antwort sagt, sondern wie viele der Menschen, die diese Frage stellen, Ihren Namen sehen. Das lässt sich nur mit wiederholter Messung schätzen. In der KI-Suche ist Sichtbarkeit keine Platzierung, sondern eine Wahrscheinlichkeit.
Warum ein einmaliger Test täuscht: ein Beispiel
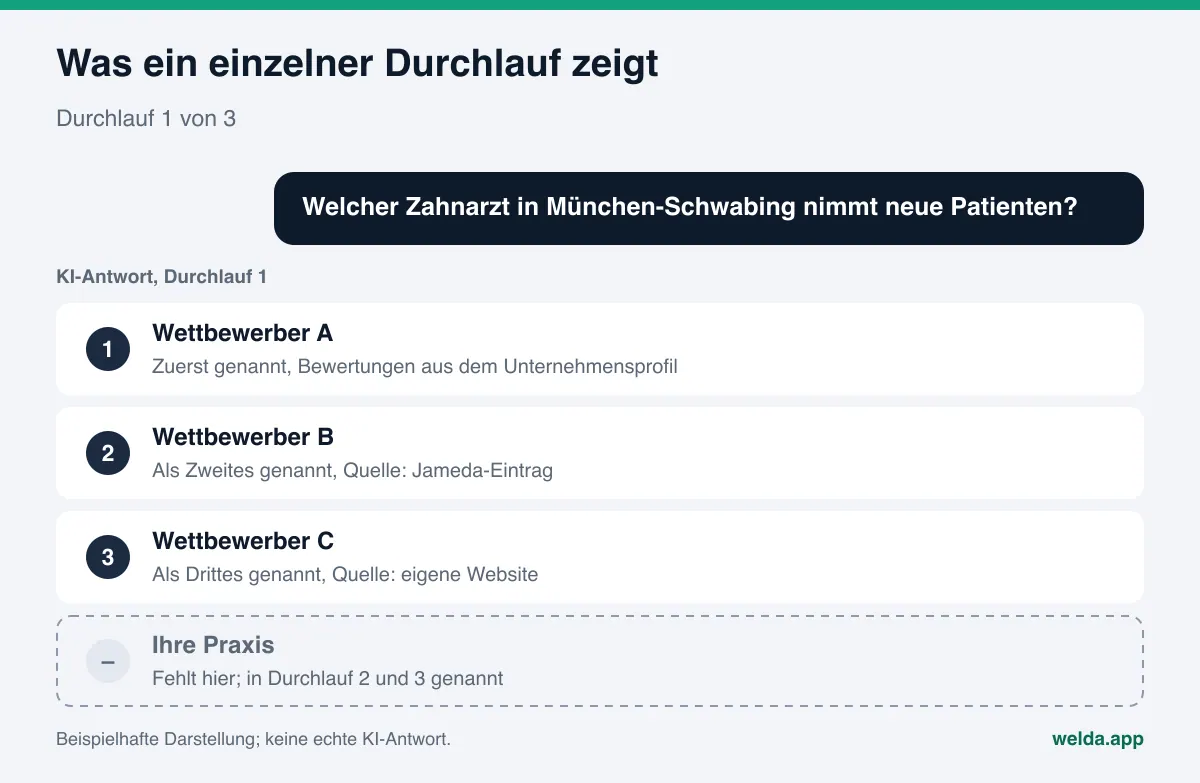
Nehmen wir als Beispiel eine Zahnarztpraxis in einer mittelgroßen Stadt in Bayern. Die Inhaberin fragt am Montagmorgen ChatGPT nach einem "Zahnarzt in der Nähe, der neue Patienten aufnimmt" und sieht ihre Praxis unter den ersten drei. Sie schickt den Screenshot ans Team. Am Mittwoch stellt die Rezeption dieselbe Frage bei Gemini, und die Praxis wird nicht erwähnt. Am Freitag sagt ein neuer Patient: "Über die KI habe ich Sie nicht gefunden."
Das widerspricht sich nicht. Das Montagsergebnis war ein Zug aus einer Bandbreite möglicher Antworten. Das Mittwochsergebnis kam von einer anderen Engine mit anderen Quellen. Der Patient am Freitag hat die Frage vermutlich anders formuliert und aus einem anderen Stadtteil gestellt. Solche Einzelbeobachtungen messen keine Sichtbarkeit. Die nützliche Frage lautet: Wenn wir dieselbe Frage unter gleichen Bedingungen mehrmals in jeder der vier Engines stellen, wie oft wird die Praxis genannt und an welcher Stelle?
Verwechseln Sie das nicht mit falschen Angaben. Nennt die Antwort Sie, aber mit alter Telefonnummer oder geschlossener Adresse, ist das keine Schwankung, sondern ein Datenproblem. Wie Sie das beheben, steht in falsche Adresse in KI-Antworten.
Drei Durchläufe und eine Fehlermarge: wie man schwankende Antworten misst
Die Schwankung lässt sich nicht abschalten, aber messen. Der Ansatz ist einfach: jede Frage in jeder Engine mehr als einmal stellen und die Ergebnisse gemeinsam lesen.
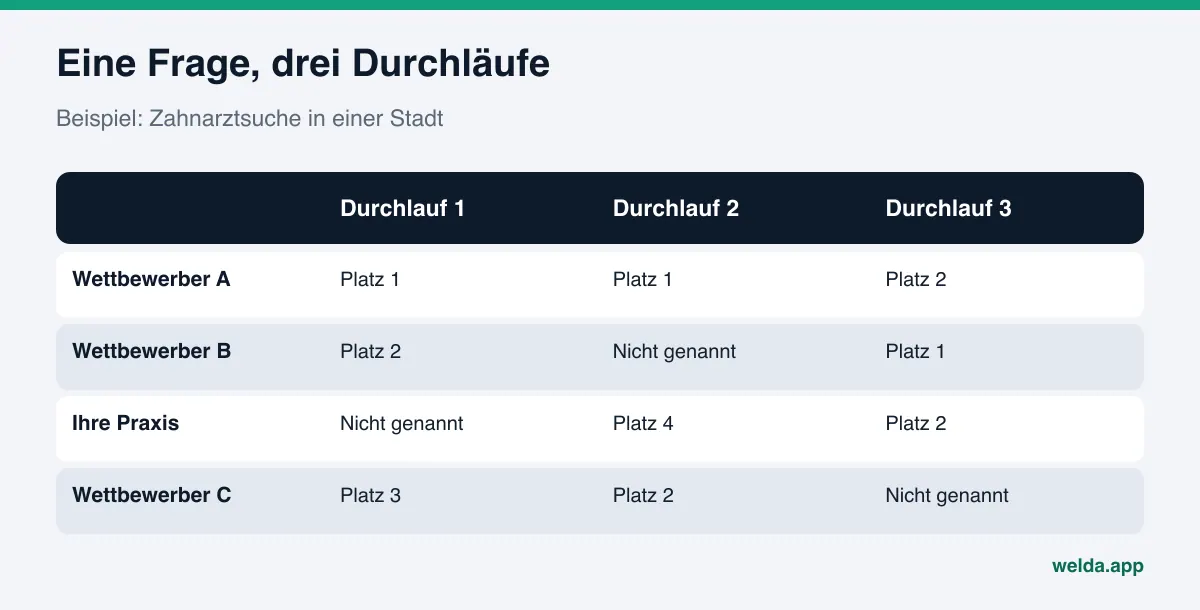
Warum wiederholen? Ein einzelner Durchlauf ist ein Münzwurf. Drei Durchläufe genügen, um zu sehen, wie stark sich das Ergebnis bewegt. In allen drei genannt: starke Position. In einem genannt: Grenzfall. In keinem genannt: Für diese Frage fehlt etwas.
Warum der Median? Liefern drei Durchläufe Platz 2, Platz 4 und "nicht genannt", ist ein Durchschnitt schwierig. Der Median, also der mittlere Wert, ist robuster: hier Platz 4. Ein einzelner Ausreißer verschiebt ihn kaum.
Warum eine Fehlermarge? Wie weit die drei Durchläufe auseinanderliegen, zeigt, wie sehr Sie der Zahl trauen können. Liegen sie nah beieinander, ist die Marge klein. Liegen sie weit auseinander, ist sie groß, und eine Veränderung innerhalb einer Woche verdient wenig Gewicht. Ein "± X" neben dem Score liefert genau diesen Kontext.
Warum vier Engines getrennt? ChatGPT, Gemini, Perplexity und die KI-Funktionen von Google greifen auf unterschiedliche Quellen zurück. Ein Betrieb kann in einer Engine stark sein und in einer anderen fehlen. Fasst man alles in einer Zahl zusammen, geht das verloren; nebeneinander sieht man, wo die Lücke liegt. Eine Engine im Detail behandeln wir in Perplexity-Sichtbarkeit tracken.
Welche Fragen schwanken am stärksten?
Nicht jede Frage schwankt gleich stark. Je allgemeiner eine Frage ist und je mehr plausible Antworten es gibt, desto stärker unterscheiden sich die Durchläufe tendenziell. Je enger sie ist und je mehr sie von einer klaren Tatsache abhängt, desto stabiler bleibt die Antwort. Daran sehen Sie, wo Sie Ergebnisse vorsichtiger lesen sollten.
| Fragetyp | Beispiel | Erwartete Schwankung | So lesen Sie es |
|---|---|---|---|
| Breite Empfehlung | "Bestes Restaurant in Wien" | Hoch; viele Kandidaten | Nie einem Einzeldurchlauf trauen |
| Stadtteil plus Leistung | "Kinderzahnarzt in Zürich-Oerlikon" | Mittel | Median aus drei Durchläufen ansehen |
| Konkreter Bedarf | "Tierarzt sonntags offen mit Parkplatz" | Niedrig bis mittel | Nie genannt: Vielleicht fehlt eine Angabe |
| Frage mit Markenname | "Wann schließt X heute" | Niedrig | Fehler sind Datenprobleme, kein Rauschen |
Die Tabelle beschreibt eine allgemeine Tendenz, keine gemessene Quote. Praktisch heißt das: Bei breiten Fragen ist "manchmal genannt" normal, und das Ziel ist, häufiger genannt zu werden. Bei engen Fragen mit Markennamen sollte die Antwort jedes Mal stimmen; wenn nicht, korrigieren Sie zuerst die Angaben.
So testen Sie selbst: Schritt für Schritt
Sie können das von Hand messen. Es kostet Zeit, ist aber der beste Weg, die Methode zu verstehen.
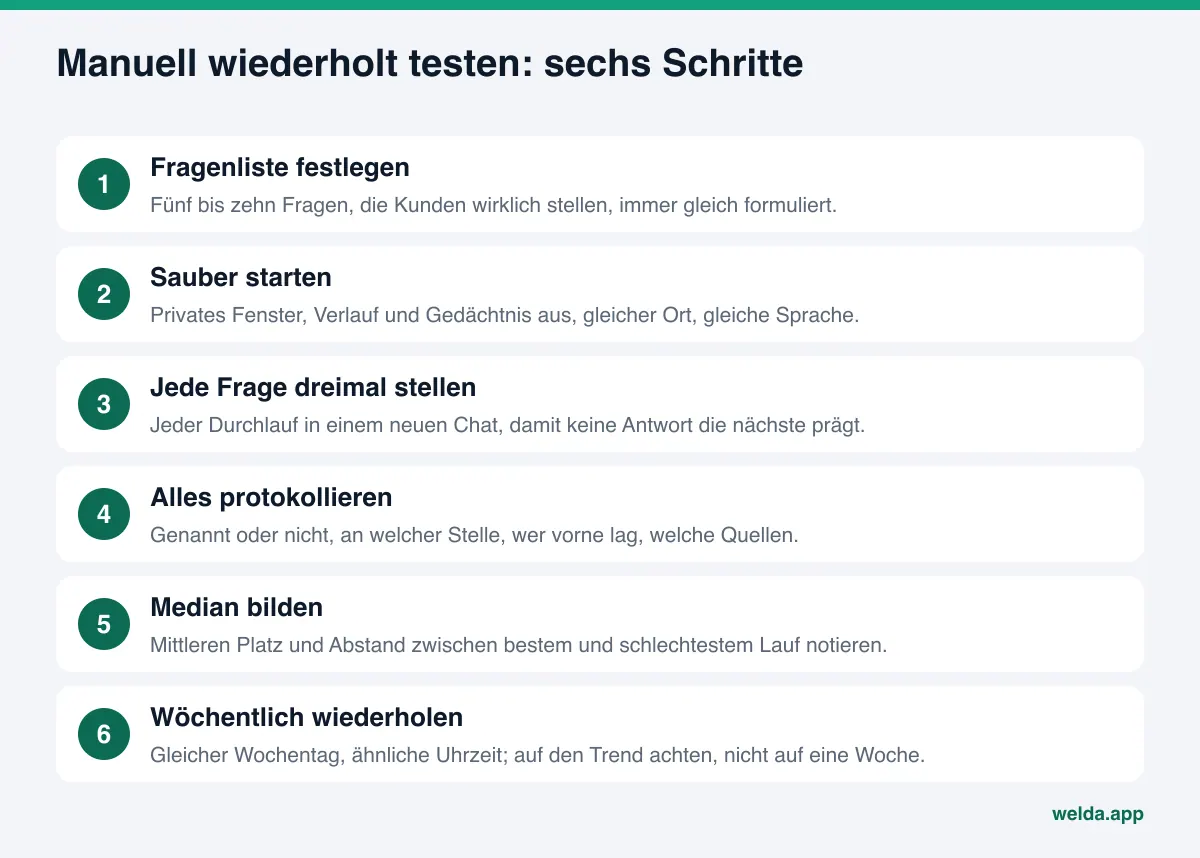
- Fragenliste schreiben. Wählen Sie fünf bis zehn Fragen, die Kunden wirklich stellen: "Leistung im Stadtteil", "beste Leistung in der Stadt", "günstige Leistung", "wer hilft bei einem bestimmten Anliegen". Wie Sie diese Fragen finden, zeigt Kundenfragen an KI finden.
- Wortlaut festlegen. Halten Sie die Fragen in einem Dokument fest und fügen Sie sie jedes Mal per Kopieren ein. Schon "gut" statt "bester" kann die Antwort ändern.
- Saubere Sitzung nutzen. Öffnen Sie ein privates Fenster oder schalten Sie Verlauf und Gedächtnisfunktion aus. Halten Sie Standort und Sprache konstant. Starten Sie für jeden Durchlauf einen neuen Chat; im selben Verlauf dient die vorige Antwort als Kontext.
- Jede Frage dreimal je Engine stellen. Bei vier Engines und zehn Fragen sind das 120 Durchläufe. Für den Einstieg reichen fünf Fragen und zwei Engines.
- Jeden Durchlauf protokollieren. Genannt oder nicht, an welcher Stelle, wer vorne lag, welche Quellen genannt wurden.
- Zusammenfassen. Notieren Sie je Frage den Median und den Abstand zwischen bestem und schlechtestem Durchlauf. Berechnen Sie über alle Fragen den Anteil der Fragen, in denen Sie genannt werden.
- Wöchentlich wiederholen. Gleicher Wochentag, ähnliche Uhrzeit, gleiche Liste. Beurteilen Sie den Trend über drei bis vier Wochen, nicht eine einzelne Woche.
Eine einfache Protokollvorlage:
| Frage | Engine | Lauf 1 | Lauf 2 | Lauf 3 | Median | Genannte Quellen |
|---|---|---|---|---|---|---|
| Zahnarzt Schwabing, neue Patienten | ChatGPT | Nicht genannt | 4 | 2 | 4 | Jameda, Unternehmensprofil |
| Zahnarzt Schwabing, neue Patienten | Gemini | 3 | 3 | 2 | 3 | Google Unternehmensprofil |
| Zahnarzt Notdienst samstags | Perplexity | Nicht genannt | Nicht genannt | Nicht genannt | Keiner | Website Wettbewerber, Verzeichnis |
Die Werte sind ein Beispiel. Die ersten beiden Zeilen zeigen "sichtbar, aber schwankend". Die dritte zeigt eine echte Lücke: In allen drei Durchläufen zu fehlen, lässt sich nicht mit Schwankung erklären. In den Quellen fehlt für diese Frage etwas, etwa Samstagszeiten, die nirgends online stehen.
Die manuelle Messung hat Grenzen. Sie ist langsam, fehleranfällig und über Wochen schwer durchzuhalten. Wenn Ihr Team Rank-Tracking gewohnt ist, vergleichen wir beide Ansätze in Rank-Tracker vs. KI-Sichtbarkeit-Tracker.
Wie Welda das löst: drei Durchläufe, Median und Fehlermarge
Welda führt die oben beschriebene Methode regelmäßig in einer Software durch. Dieser Abschnitt behandelt die drei Teile, die direkt mit der Schwankung zu tun haben: die drei Durchläufe in der Fragenansicht, die offene Score-Formel und die Fehlermarge neben dem Score. Vorab der Stand der Dinge: Das Welda-Dashboard befindet sich im Early Access und öffnet zuerst für Betriebe in der Türkei. Die regelmäßige Messung über vier Engines wird während des Early Access ergänzt; die gezeigten Ansichten arbeiten mit repräsentativen Daten. Was heute alle nutzen können, ist die kostenlose Analyse, und die funktioniert auch auf Deutsch.
Fragenansicht: jede Frage, jede Engine, drei Durchläufe. Im Dashboard werden die Fragen, die Ihre Kunden stellen würden, jeweils dreimal an ChatGPT, Gemini, Perplexity und Google AI gestellt. Jede Zeile ist eine Frage, jede Engine hat eine eigene Spalte. Öffnen Sie eine Frage, zeigt die Antwortdetailansicht die drei Durchläufe nebeneinander (zum Beispiel "nicht genannt, 4, 2") und darunter den Median. Die Entscheidung, die Sie hier treffen: Ist diese Frage für mich stabil, ein Grenzfall oder eine Lücke? Grenzfälle sind oft die schnellsten Erfolge, denn die KI kennt Sie bereits, wählt Sie aber nicht jedes Mal.
Die Detailansicht listet außerdem die Quellen, auf die sich jede Antwort stützt. Wer einen Durchlauf mit Nennung neben einen ohne Nennung legt, findet am schnellsten heraus, woher die Schwankung kommt. Stützt sich der eine Durchlauf auf ein Verzeichnis, in dem Sie gut vertreten sind, und der andere auf eines, in dem Sie fehlen, haben Sie Ihre Lücke gefunden.
Eine offene Score-Formel. Der Sichtbarkeits-Score ist keine Blackbox. Er ist das Hundertfache aus drei Teilen: dem Anteil der Fragen, in denen Sie genannt werden (Gewicht 0,5), einem Positionswert dafür, an welcher Stelle Sie genannt werden (0,3), und Ihrem Anteil gegenüber Wettbewerbern (0,2). Bewegt sich der Score, sehen Sie, welcher Teil sich bewegt hat. Bleibt die Zahl der Fragen mit Nennung gleich, sinkt aber Ihre Position, ist das Problem nicht Unsichtbarkeit, sondern ein Wettbewerber, der vor Ihnen genannt wird.
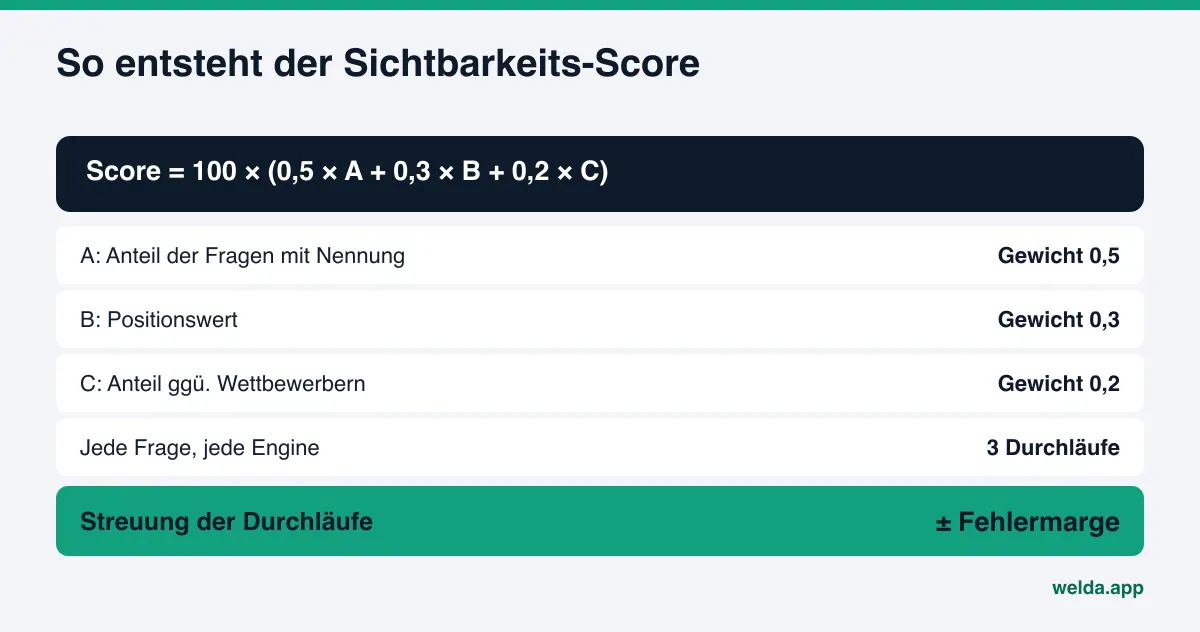
Die Marge neben dem Score. Je weiter die drei Durchläufe auseinanderliegen, desto größer der ±-Wert neben dem Score. Der Score selbst ist der Durchschnitt der drei Durchläufe, die Marge steht direkt daneben. Bleibt eine wöchentliche Veränderung innerhalb der Marge, ist es zu früh, sie als echt zu werten. Überschreitet sie die Marge und hält sie einige Wochen an, ist es ein Trend. Eine Übersicht "was sich diese Woche geändert hat" zeigt, bei welchen Fragen Sie erstmals genannt wurden und welche Arbeit davor lag. So können Sie eine Veränderung einer Maßnahme zuordnen.
Der Rest des Dashboards baut auf dieser Messung auf. Die Aufgabenliste zeigt für Grenzfälle fehlende Angaben und fertige Textvorschläge; Welda bereitet Inhalte und Profiltexte vor, die Freigabe bleibt bei Ihnen. Die Ansichten zu Wettbewerbern und Quellen zeigen, aus welchen Quellen sich die Schwankung speist.
Der Test in der kostenlosen Analyse. Die kostenlose Analyse stellt außerdem fünf typische Kundenfragen an einen KI-Assistenten mit Websuche und prüft, ob Ihr Betriebsname in den Antworten vorkommt. Das ist eine einmalige Messung. Aus allen in diesem Beitrag genannten Gründen sollten Sie sie als Ausgangsbild lesen: Werden Sie nie genannt, beginnen Sie mit den Lücken auf Ihrer Website; werden Sie genannt, heißt das nicht, dass Sie in jedem Durchlauf genannt werden.
Einen schwankenden Score richtig lesen
Sobald regelmäßig gemessen wird, stellt sich eine neue Frage: Soll ich auf die Veränderung dieser Woche reagieren? Dafür ist das folgende Schema gedacht.
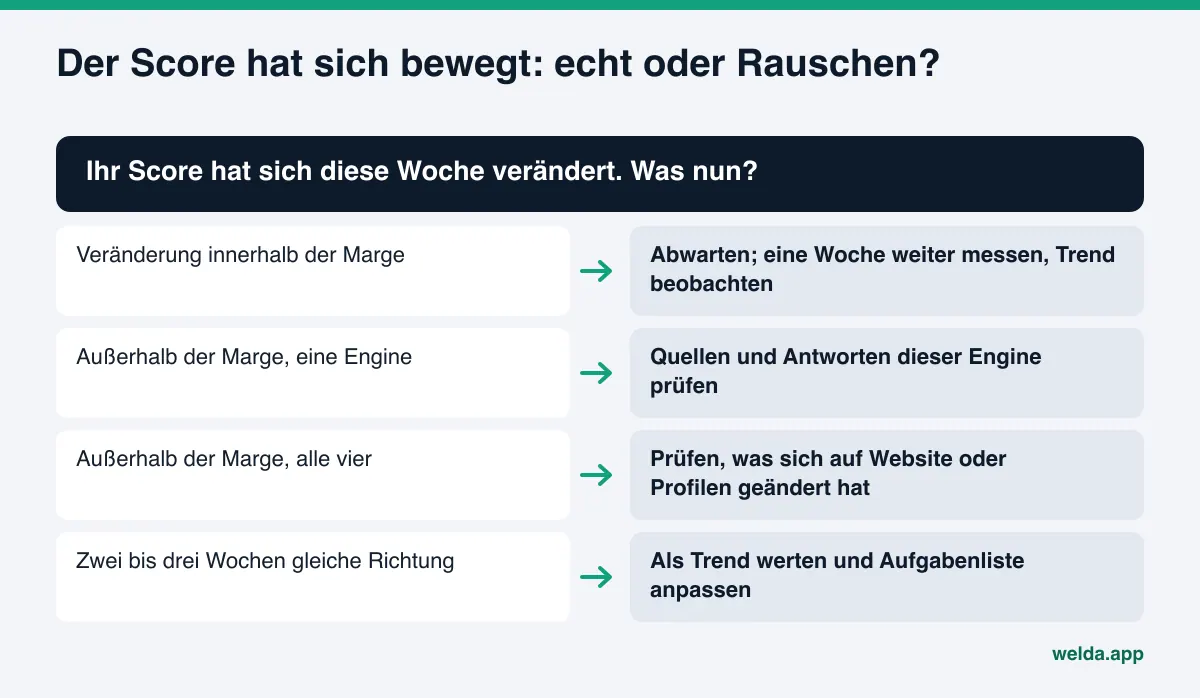
- Kleine Veränderungen innerhalb der Marge notieren, aber nicht handeln. In der nächsten Woche erneut prüfen.
- Eine große Veränderung in nur einer Engine bei deren Quellen suchen. Deren Quellenauswahl kann sich geändert haben; hat sich anderswo nichts bewegt, liegt es nicht an Ihrer Website.
- Eine Veränderung in allen vier Engines bei sich selbst suchen. Wurde eine Seite entfernt? Hat sich Ihr Profil geändert? Sperrt Ihre robots.txt plötzlich KI-Crawler?
Neue Inhalte brauchen meist Wochen, bis sie in KI-Antworten ankommen. Ein unveränderter Score in der ersten Woche nach einer Korrektur ist daher normal. Realistische Zeiträume beschreiben wir in wie lange dauert GEO.
Grenzen und was Welda nicht tut
Wiederholte Messung macht Schwankung beherrschbar, beseitigt sie aber nicht. Deshalb gehört dazu, offen zu sagen, was nicht geht.
- Niemand kann eine feste Platzierung zusagen. Welda garantiert weder Rankings noch ein "Erscheinen in ChatGPT". Da Antworten jedes Mal neu entstehen, wäre ein solches Versprechen auch sachlich unsinnig.
- Die Messung zeigt nicht, was ein einzelner Kunde sieht. Wiederholte Durchläufe schätzen, was unter sauberen, festen Bedingungen passiert. Ein Kunde mit persönlichen Einstellungen kann etwas anderes sehen.
- Die kostenlose Analyse ist einmalig. Ihr Test mit fünf Fragen ist eine Momentaufnahme, kein Trend, und misst keine Rankings.
- Welda erfindet keine Angaben. Sind Sie bei einer Frage ein Grenzfall, weil eine Information fehlt, etwa Öffnungszeiten oder Einzugsgebiet, fragt Welda bei Ihnen nach, statt zu raten.
- Keine gefälschten Bewertungen. Eine Abkürzung durch die Schwankung gibt es nicht. Antworten auf negative Bewertungen, Verzeichniskonten und Pressearbeit bleiben beim Betrieb.
- Nichts Heikles ohne Freigabe. Inhalte liegen immer auf Ihrer eigenen Website, und Sie entscheiden, was veröffentlicht wird.
Checkliste: bevor Sie einem Ergebnis trauen
Wenn ein Screenshot auf Ihrem Tisch landet, ob selbst gemacht oder von einem Dienstleister geschickt, prüfen Sie ihn mit diesen Fragen.
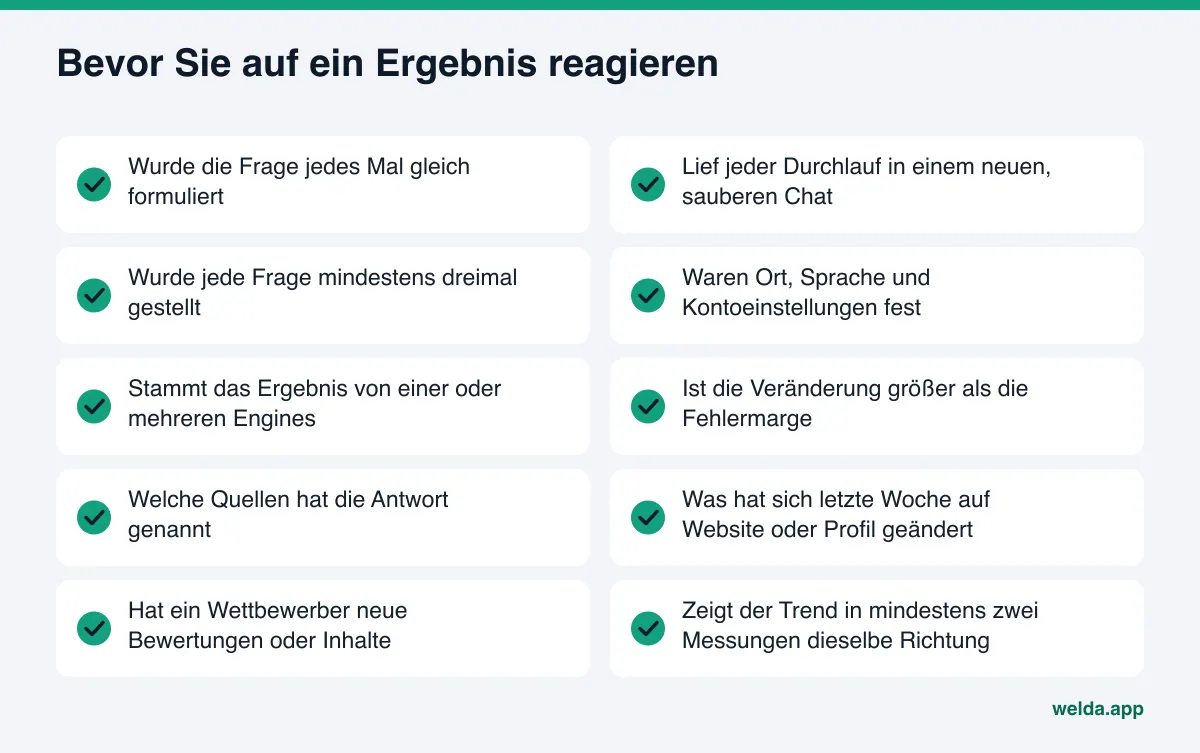
Denselben Maßstab können Sie an jedes Werkzeug und jede Dienstleistung für KI-Sichtbarkeit anlegen. Manche nennen das Feld auch AEO (Answer Engine Optimization); gemeint ist dasselbe Ziel. Fragen Sie drei Dinge: Wie oft wird jede Frage gestellt? Werden Ergebnisse je Engine getrennt gezeigt? Steht neben dem Score eine Fehlermarge oder ein Vertrauensbereich? Fehlen diese Antworten, wissen Sie nicht, wie stark die Zahlen schwanken können.
Häufige Fragen
Ich habe dieselbe Frage zweimal gestellt und zwei Antworten bekommen. Stimmt etwas nicht?
Nein. KI-Antworten werden jedes Mal neu erzeugt und stützen sich oft auf eine Live-Websuche. Unterschiedliche Antworten sind zu erwarten. Entscheidend ist, wie oft Sie über mehrere Durchläufe genannt werden.
Wie viele Durchläufe reichen?
Drei Durchläufe reichen, um zu sehen, wie stark ein Ergebnis schwankt, und um einen Median zu bilden. Mehr Durchläufe verkleinern die Fehlermarge, kosten aber mehr Zeit. Im Welda-Dashboard wird jede Frage dreimal je Engine gestellt.
Was bedeutet die Fehlermarge?
Sie ist ein Bereich, der sich daraus ergibt, wie weit die drei Durchläufe auseinanderliegen. Liegt der Score etwa bei 30 mit kleiner Marge, liegt Ihre tatsächliche Sichtbarkeit nahe 30. Bei großer Marge sollten Sie kleine Wochenveränderungen nicht überbewerten.
Reicht ein privates Browserfenster?
Es verringert die Personalisierung, doch die Antwort entsteht trotzdem jedes Mal neu. Nutzen Sie saubere Sitzung und wiederholte Durchläufe zusammen.
Warum ist der Test mit fünf Fragen in der kostenlosen Analyse einmalig?
Die kostenlose Analyse soll die Lücken auf Ihrer Website zeigen und sagen, wo Sie anfangen. Der Test mit fünf Fragen ergänzt ein Ausgangsbild. Regelmäßige, wiederholte Messung über vier Engines findet im Welda-Dashboard statt, das sich im Early Access befindet.
In einer Engine bin ich sichtbar, in der anderen nicht. Welche hat recht?
Beide. Jede Engine liest andere Quellen. Sichtbar in der einen und unsichtbar in der anderen heißt: In den Quellen der zweiten Engine fehlt etwas. Die Liste der genannten Quellen ist der schnellste Weg dorthin.
Fazit: warum KI-Antworten variieren und was daraus folgt
Kurz gesagt variieren KI-Antworten, weil jede Antwort neu geschrieben wird. Diese Schwankung bleibt, und gegen sie anzukämpfen bringt nichts. Die Aufgabe ist, die Messung danach auszurichten: dieselbe Frage unter gleichen Bedingungen mehrmals stellen, Engines getrennt lesen, Ergebnisse an einer Fehlermarge messen und Entscheidungen auf Wochentrends statt auf einen Screenshot stützen. Die eigentliche GEO-Arbeit besteht darin, Website, Profile und Bewertungen so zu stärken, dass sich der Mittelpunkt der Streuung zu Ihren Gunsten verschiebt. Ihren Ausgangspunkt sehen Sie mit der kostenlosen KI-Sichtbarkeitsanalyse: ein Bericht, der zeigt, wie KI Ihre Website liest, welche Korrektur Ihren Score am stärksten anhebt, und ein fertiges Korrekturpaket zum Einbauen.