Yapay zeka cevapları neden değişiyor? Çünkü ChatGPT, Gemini, Perplexity ve Google'ın AI özellikleri cevabı her seferinde yeniden üretir: kelimeleri olasılıkla seçer, çoğu zaman o anda web araması yapar ve farklı kaynaklara bakar. Bu yüzden aynı soruya iki ayrı denemede farklı işletmeler anılabilir. Tek bir ekran görüntüsü görünürlüğünüzü göstermez; aynı soruyu birkaç kez sorup sonucu hata payıyla okumak gerekir.
Bir sabah ChatGPT'ye "semtimizde iyi bir diş kliniği" diye sordunuz ve adınız ikinci sırada çıktı. Öğleden sonra aynı soruyu sordunuz, bu kez hiç anılmadınız. Ertesi gün çalışanınız aynı soruyu kendi telefonundan sordu ve sizi dördüncü sırada gördü. Hangisi doğru? Bu yazıda yapay zeka cevapları neden değişiyor sorusunu teknik ayrıntıya boğmadan anlatıyoruz, sonra bu değişkenliğe rağmen görünürlüğü nasıl güvenilir ölçebileceğinizi adım adım gösteriyoruz. Önce sitenizin yapay zeka gözüyle nasıl okunduğunu görmek isterseniz ücretsiz site analizini çalıştırabilirsiniz; eksikleri ve nasıl düzeleceklerini tek raporda verir.
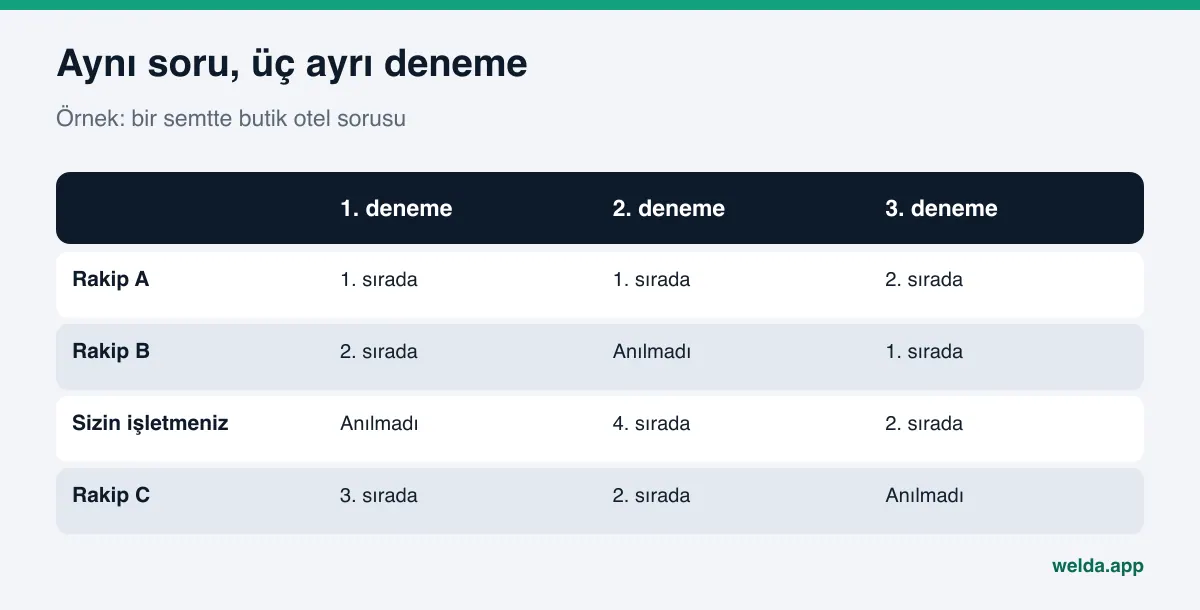
Yapay zeka cevapları neden değişiyor? Beş temel neden
Klasik Google aramasında aynı kelimeyi aynı yerden arayan iki kişi çoğu zaman benzer bir sonuç listesi görür. Yapay zeka cevaplarında durum farklıdır. Ortada hazır bir liste yoktur; cevap, soru sorulduğu anda yazılır. Değişkenliğin arkasında birbirinden bağımsız beş neden vardır.
1. Cevap olasılıkla üretilir. Dil modelleri bir sonraki kelimeyi tek bir doğru seçenekten değil, olası seçenekler arasından seçer. Aynı soru iki kez sorulduğunda ilk birkaç kelime benzer olsa bile cevap ilerledikçe farklı yöne gidebilir. Bu, modellerin tasarımından gelen bir özelliktir. Microsoft'un Azure OpenAI belgelerinde, aynı soruyu birkaç kez sorduğunuzda büyük olasılıkla farklı cevap alacağınız ve tekrarlanabilirlik ayarı kullanılsa bile aynı cevabın garanti edilmediği açıkça yazılır. Müşterinin kullandığı sohbet ekranında bu ayarlar zaten kullanıcının elinde değildir.
2. Cevap canlı web aramasına dayanır. İşletme önerisi isteyen sorularda yapay zeka asistanları çoğu zaman o anda web araması yapar. Google, AI Bakışı ve AI Modu'nun bir cevabı hazırlarken alt konular için birden çok ilgili arama yapabildiğini ("query fan-out") ve bu iki özelliğin farklı modeller ve teknikler kullanabildiği için gösterilen cevap ve bağlantıların değişeceğini kendi belgelerinde söyler. Hangi alt aramanın yapıldığı, hangi sayfanın okunduğu denemeden denemeye değişebilir.
3. Motorlar ve modeller güncellenir. ChatGPT, Gemini, Perplexity ve Google'ın AI özellikleri arka planda sık sık güncellenir. Model değişir, arama altyapısı değişir, kaynak seçme biçimi değişir. Siz hiçbir şeye dokunmadan geçen ayki cevap bu ay farklı olabilir.
4. Soran kişi ve bağlam farklıdır. Sorunun ifadesi ("en iyi", "uygun fiyatlı", "yakınımdaki"), soranın konumu, dil ayarı, oturum açıp açmadığı ve açıksa önceki sohbetleri ya da kayıtlı tercihleri cevabı etkileyebilir. Sizin telefonunuzdaki cevap, müşterinizin telefonundakiyle aynı olmak zorunda değildir.
5. Kaynakların kendisi değişir. Rakibiniz Google İşletme Profili'ne yeni fotoğraf ekler, Şikayetvar'da yeni bir şikayet açılır, bir sektör rehberi listesini yeniler, Ekşi Sözlük'te yeni bir başlık açılır. Yapay zeka bir dahaki aramada bu yeni bilgiyi görür. Bu değişim gürültü değildir; gerçek bir değişimdir ve izlenmesi gerekir.
| Neden | Ne değişir | Sizin etkiniz |
|---|---|---|
| Olasılıklı üretim | Aynı soruda sıra ve anılan işletmeler | Yok; ancak tekrarla ölçülerek dengelenir |
| Canlı web araması | Okunan sayfalar ve gösterilen kaynaklar | Dolaylı; güçlü ve tutarlı kaynaklarla artar |
| Motor güncellemeleri | Genel davranış, kaynak seçimi | Yok; yalnız izlenir |
| Soran ve bağlam | Kişiye ve konuma göre cevap | Yok; ölçümde sabit tutulur |
| Kaynakların güncellenmesi | Sizin ve rakiplerin hakkındaki bilgi | Doğrudan; site, profil ve yorumlarla |
Tablonun son satırı önemlidir. İlk dört neden ölçüm yöntemini ilgilendirir: bunları yönetemezsiniz, ancak ölçerken hesaba katabilirsiniz. Son neden ise asıl iş alanınızdır. Sitenizdeki, profillerinizdeki ve yorumlarınızdaki bilgi güçlendikçe yapay zekanın sizi anma olasılığı artar. Değişkenlik ortadan kalkmaz, ama dağılımın merkezi sizin lehinize kayar.
Bu değişkenlik işletmeniz için neden önemli?
Değişkenliği bilmemek iki yönde yanlış karara götürür.
- Yersiz panik. Bir denemede adınız çıkmadı diye sitenizi baştan yazmaya, ajans değiştirmeye ya da bütün içeriği silmeye karar verirsiniz. Oysa üç denemenin ikisinde anılıyor olabilirsiniz.
- Yersiz rahatlık. Bir denemede birinci sırada çıktınız diye işin bittiğini düşünürsünüz. Oysa aynı soruyu soran on müşteriden yalnız birkaçı sizi görüyor olabilir.
- Yanlış yere emek. Bir rakibin öne geçtiğini tek ekran görüntüsünden çıkarır, o rakibi taklit etmeye başlarsınız. Bir sonraki denemede o rakip listede bile olmayabilir.
- Raporlara güvenememek. Size "ChatGPT'de çıkıyorsunuz" diye tek bir ekran görüntüsü gösteren bir rapor, ne zaman, kaç kez ve hangi koşulda sorulduğunu söylemiyorsa doğrulanamaz.
Müşteri açısından bakınca durum daha net görünür. Müşteri soruyu bir kez sorar ve o anki cevabı görür. Sizin için önemli olan tek bir cevabın ne dediği değil, aynı soruyu soran müşterilerin ne kadarının sizi gördüğüdür. Bu da ancak tekrarlı ölçümle tahmin edilebilir. Yapay zekada görünürlük bir sıra numarası değil, bir olasılıktır.
Tek seferlik test neden yanıltır: örnek bir senaryo
Örnek bir butik otel düşünelim. Sahibi pazartesi sabahı ChatGPT'ye "Alaçatı'da sessiz butik otel" diye soruyor ve otelini ilk üçte görüyor. Ekran görüntüsünü alıp ekibine gönderiyor. Çarşamba günü resepsiyondaki çalışan aynı soruyu Gemini'ye soruyor ve otel hiç anılmıyor. Cuma günü bir misafir "sizi yapay zekadan bulamadım" diyor.
Bu üç olay birbiriyle çelişmez. Pazartesi günkü sonuç bir olasılığın tek gerçekleşmesiydi; çarşamba günkü sonuç başka bir motorun başka kaynaklara dayanan cevabıydı; misafirin sorusu ise belki farklı bir ifadeyle, farklı bir konumdan soruldu. Otel sahibinin elindeki üç gözlem, görünürlüğü ölçmek için yetersizdir. Asıl soru şudur: aynı soruyu, aynı koşulda, dört motorda birkaçar kez sorduğumuzda otel ne sıklıkla ve hangi sırada anılıyor?
Bu senaryo, yapay zeka cevaplarındaki bilgi hatalarıyla da karışabilir. Cevap sizi anıyor ama yanlış telefonla ya da eski adresle anıyorsa, bu değişkenlik değil bir veri sorunudur. Bunu ayrı ele aldığımız yapay zeka cevaplarında yanlış adres ve telefon yazısında nasıl düzelteceğinizi anlattık.
Üç tekrar ve hata payı: değişen cevabı ölçmenin yolu
Değişkenliği ortadan kaldıramazsınız, ama ölçebilirsiniz. Bunun için kullanılan yaklaşım basittir: her soruyu her motorda birden fazla kez sormak ve sonuçları birlikte okumak.
Neden tekrar? Tek deneme bir yazı tura atışı gibidir. Üç deneme, sonucun ne kadar oynadığını görmeye yeter. Üçünde de anılıyorsanız güçlü bir konumdasınız; birinde anılıyorsanız sınırdasınız; hiçbirinde anılmıyorsanız o soru için bir eksik vardır.
Neden ortanca? Üç denemede 2, 4 ve "anılmadı" sonucunu aldıysanız ortalama almak zordur; ortanca (ortadaki değer) daha sağlam bir özet verir. Bu örnekte ortanca 4. sıradır. Bir tek uç sonuç ortancayı fazla oynatmaz.
Neden hata payı? Üç tekrarın birbirinden ne kadar uzaklaştığı, sonucun ne kadar güvenilir olduğunu söyler. Üç deneme birbirine yakınsa hata payı küçüktür. Birbirinden çok farklıysa hata payı büyüktür ve tek haftalık değişime fazla anlam yüklememek gerekir. Skorun yanında "± şu kadar" yazması, okura bu bilgiyi verir.
Neden dört motor ayrı ayrı? ChatGPT, Gemini, Perplexity ve Google'ın AI özellikleri farklı kaynaklara bakar. Bir işletme bir motorda güçlü olup diğerinde hiç görünmeyebilir. Motorları tek bir sayıda toplamak bilgi kaybettirir; ayrı ayrı görmek, sorunun nerede olduğunu gösterir. Motorlar arası farkların bir örneğini Perplexity görünürlük takibi yazısında ele aldık.
Hangi sorular daha çok oynar?
Bütün sorular aynı ölçüde değişmez. Soru ne kadar genel ve ne kadar çok olası cevabı varsa, denemeler arasındaki fark o kadar büyük olma eğilimindedir. Soru ne kadar dar ve ne kadar net bir bilgiye dayanıyorsa, cevap o kadar sabit kalır. Bu ayrım, hangi soruda sonucu daha temkinli okumanız gerektiğini gösterir.
| Soru türü | Örnek | Beklenen oynama | Okurken dikkat |
|---|---|---|---|
| Geniş öneri sorusu | "İstanbul'da iyi bir restoran" | Yüksek; aday çok | Tek denemeye hiç güvenmeyin |
| Semt ve hizmet sorusu | "Kadıköy'de çocuk diş hekimi" | Orta | Üç tekrarın ortancasına bakın |
| Özel ihtiyaç sorusu | "Pazar açık, otoparklı veteriner" | Düşük ile orta | Anılmıyorsanız bilgi eksik olabilir |
| Marka adıyla soru | "X işletmesinin çalışma saatleri" | Düşük | Hata varsa değişkenlik değil veri sorunudur |
Tablo genel bir eğilimi anlatır, ölçülmüş bir oran değildir. Pratik sonucu şudur: geniş sorularda "bazen anılıyorum" sonucu normaldir ve hedef, anılma sıklığını artırmaktır. Marka adıyla sorulan dar sorularda ise cevap her denemede doğru olmalıdır; değilse önce bilgiyi düzeltmek gerekir.
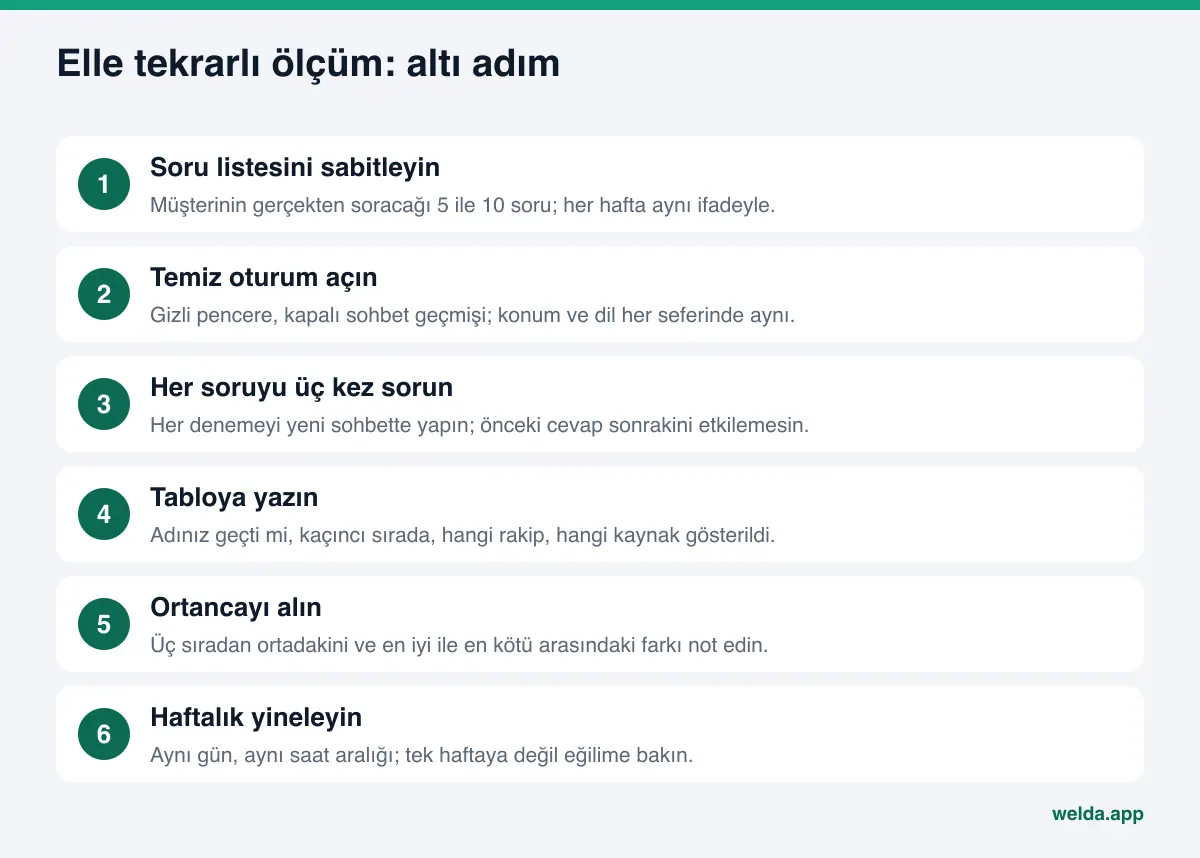
Kendi ölçümünüzü adım adım nasıl yaparsınız?
Bir yazılım kullanmadan da tekrarlı ölçüm yapabilirsiniz. Zaman alır, ama yöntemi anlamak için iyi bir başlangıçtır. Aşağıdaki adımlar, sonucu mümkün olduğunca karşılaştırılabilir kılmak içindir.
- Soru listesini yazın. Müşterinizin gerçekten sorabileceği 5 ile 10 soru seçin: "semt adı + hizmet", "en iyi + hizmet + şehir", "fiyatı uygun + hizmet", "belirli bir ihtiyaç için kim". Hangi soruların önemli olduğunu bulmak için müşterilerin yapay zekaya sorduğu soruları bulmak yazısındaki yönteme bakabilirsiniz.
- İfadeyi sabitleyin. Soruları bir belgeye yazın ve her seferinde kopyalayıp yapıştırın. "İyi" ile "en iyi" arasındaki fark bile cevabı değiştirebilir.
- Temiz bir oturum kullanın. Gizli pencere açın ya da sohbet geçmişini ve kayıtlı tercihleri kapatın. Konumu ve dili sabit tutun. Her denemeyi yeni bir sohbette yapın; aynı sohbette tekrar sormak önceki cevabı bağlam olarak kullandırır.
- Her soruyu her motorda üç kez sorun. Dört motor ve 10 soru için bu 120 deneme demektir. Küçük başlamak isterseniz önce 5 soru ve iki motorla başlayın.
- Sonucu tabloya yazın. Her deneme için: adınız geçti mi, kaçıncı sırada, ilk sıradaki kim, hangi kaynaklar gösterildi.
- Özetleyin. Her soru için üç denemenin ortancasını ve en iyi ile en kötü sonuç arasındaki farkı yazın. Bütün sorular için adınızın geçtiği soruların oranını hesaplayın.
- Haftalık yineleyin. Aynı gün ve benzer saatte, aynı listeyle. Tek haftaya değil, üç dört haftalık eğilime bakın.
Kayıt tablosu için şu basit şablon yeterlidir:
| Soru | Motor | 1. deneme | 2. deneme | 3. deneme | Ortanca | Gösterilen kaynaklar |
|---|---|---|---|---|---|---|
| Semtte butik otel | ChatGPT | Anılmadı | 4 | 2 | 4 | Otel rehberi, harita |
| Semtte butik otel | Gemini | 3 | 3 | 2 | 3 | İşletme profili |
| Kahvaltısı iyi otel | Perplexity | Anılmadı | Anılmadı | Anılmadı | Yok | Rakip sitesi, rehber |
Tablodaki değerler örnektir. Bu örnekte ilk iki satır "görünüyor ama oynuyor" durumunu, üçüncü satır ise gerçek bir eksiği gösterir. Üç denemenin üçünde de anılmadığınız soru, değişkenlikle açıklanamaz; o soru için kaynaklarda bir boşluk vardır.
Elle ölçümün sınırları da açıktır. Zaman alır, insan hatasına açıktır ve haftalar boyunca aynı disiplini korumak zordur. Sıralama takibine alışkın ekipler için iki yaklaşımın farkını sıralama takip aracı mı AI görünürlük aracı mı yazısında karşılaştırdık.
Welda bu işi nasıl yapar: üç tekrar, ortanca ve hata payı
Welda, yukarıdaki yöntemi bir yazılımın içinde düzenli yapar. Burada konuya doğrudan dokunan üç parçayı anlatıyoruz: soru ekranındaki üç tekrar, açık skor formülü ve skorun yanındaki hata payı. Önce bir gerçeği açıkça söyleyelim: Welda paneli erken erişimdedir ve Türkiye'deki işletmelerle sırayla açılmaktadır. Dört motorlu düzenli ölçüm erken erişim sürecinde ekleniyor; aşağıdaki ekranlar temsili veriyle gösterilmektedir. Bugün herkesin kullanabildiği parça ücretsiz site analizidir.
Sorular ekranı: her soru, her motor, üç tekrar. Panelde müşterilerin soracağı sorular ChatGPT, Gemini, Perplexity ve Google AI'a üçer kez sorulur. Sorular ekranında her satır bir sorudur ve her motor için ayrı bir sütun vardır. Bir soruya tıkladığınızda cevap detayı açılır: üç denemenin sonucu yan yana yazılır (örneğin "anılmadı, 4, 2") ve ortanca sıra bunların altında görünür. Bu ekranda vereceğiniz karar şudur: bu soru benim için sağlam mı, sınırda mı, yoksa hiç yok mu? Sınırda olan sorular genellikle en hızlı kazanılabilecek sorulardır; yapay zeka sizi zaten tanıyor ama her seferinde seçmiyor.
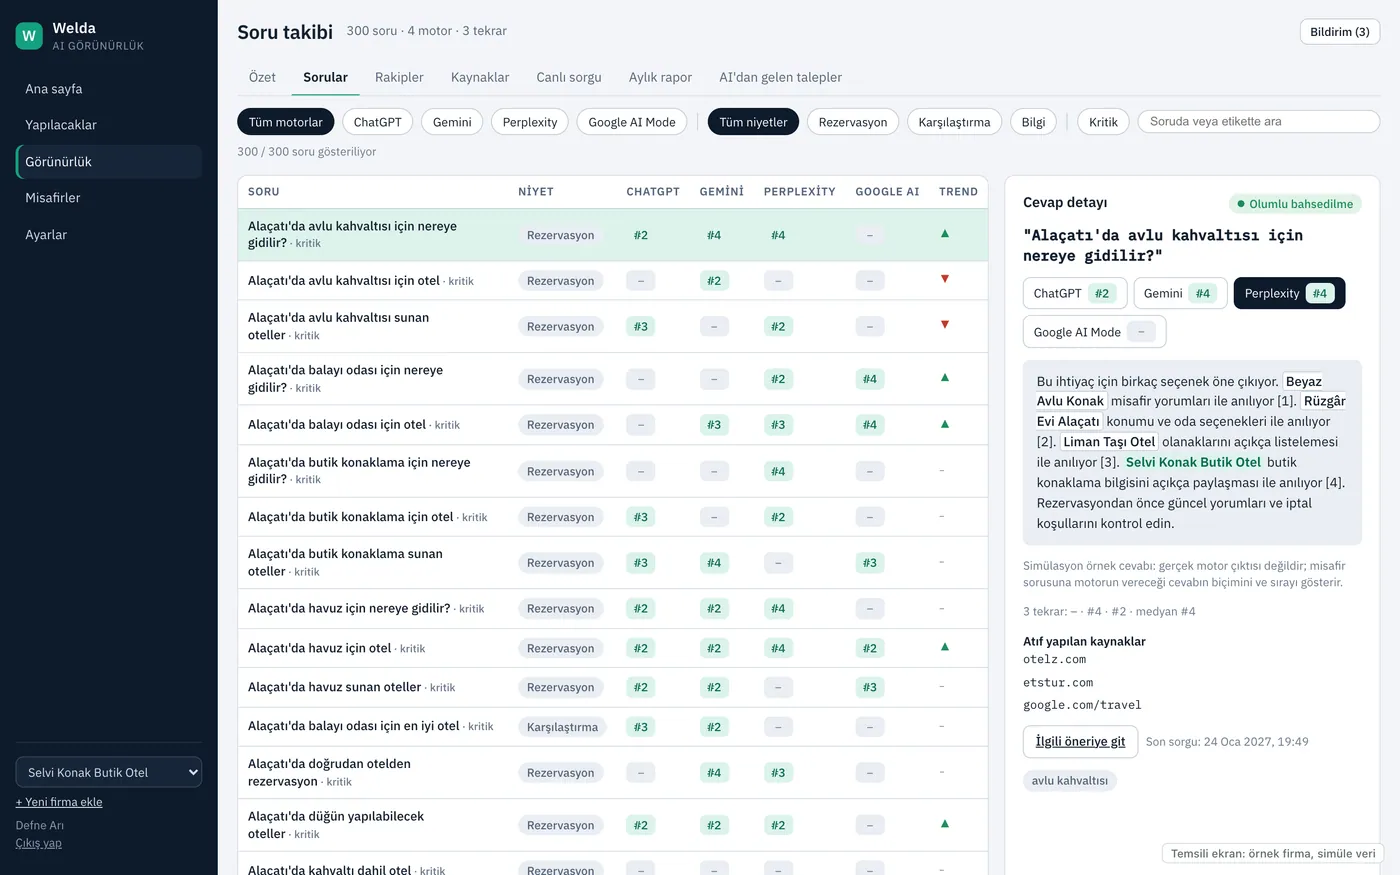
Cevap detayında atıf yapılan kaynaklar da listelenir. Bir denemede sizi anan, diğerinde anmayan cevapların hangi kaynaklara dayandığını karşılaştırmak, değişkenliğin nereden geldiğini anlamanın en pratik yoludur. Bir denemede bir rehber sitesine dayanıp sizi anan cevap, diğer denemede başka bir rehbere dayanıp sizi atlıyorsa, ikinci rehberdeki eksiğiniz ortaya çıkmış olur.
Açık skor formülü. Welda'nın görünürlük skoru gizli bir hesap değildir. Skor, 100 ile çarpılan üç parçanın toplamıdır: adınızın geçtiği soruların oranı (ağırlığı 0,5), kaçıncı sırada anıldığınızı gösteren sıra puanı (0,3) ve rakiplere göre payınız (0,2). Skor değiştiğinde hangi parçanın oynadığını görebilirsiniz. Örneğin adınızın geçtiği soru sayısı aynı kalıp sıranız düştüyse, sorun görünmemek değil, rakibin daha önde anılmasıdır. Formülün ayrıntısını AI görünürlük skoru nasıl ölçülür yazısında anlattık.
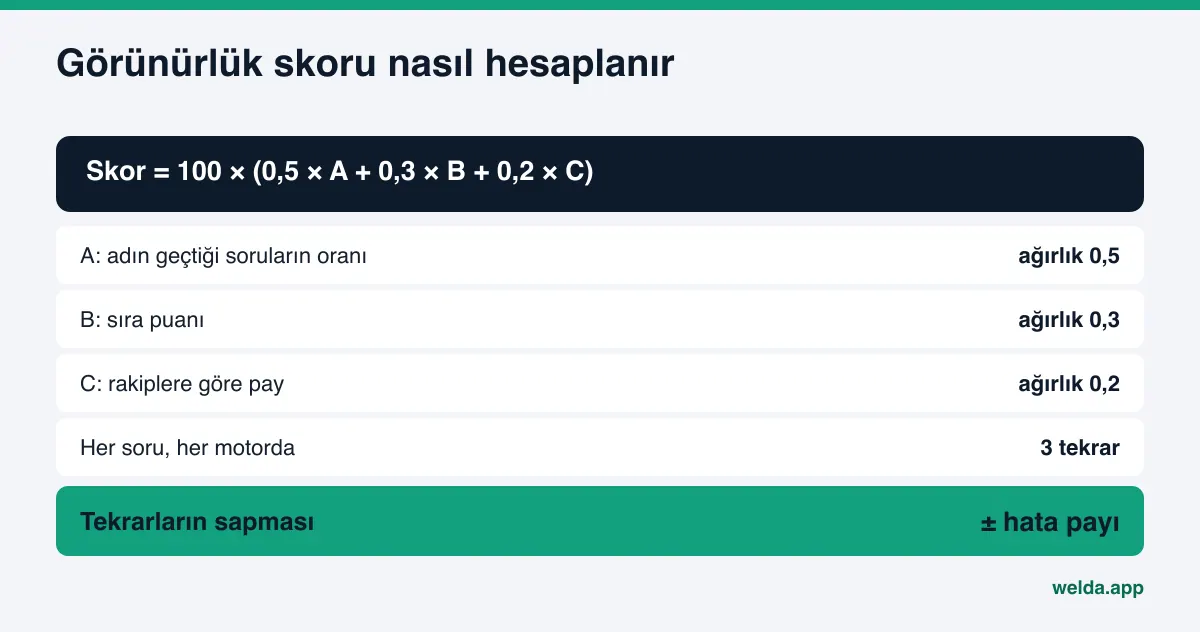
Skorun yanındaki hata payı. Üç tekrar birbirinden ne kadar uzaklaşırsa skorun yanındaki ± değeri o kadar büyür. Görünürlük ekranında skor, üç tekrarın ortalaması olarak gösterilir ve hata payı hemen yanında yazar. Haftalık değişim bu payın içinde kalıyorsa, ekranda bir oynama görseniz bile bunu gerçek bir değişim saymak için erkendir. Payı aşan ve birkaç hafta aynı yönde süren değişim ise gerçek bir eğilimdir. "Bu hafta değişenler" bölümü, hangi soruda ilk kez anıldığınızı ve bunun hangi çalışmadan sonra geldiğini gösterir; böylece değişimi bir işe bağlayabilirsiniz.
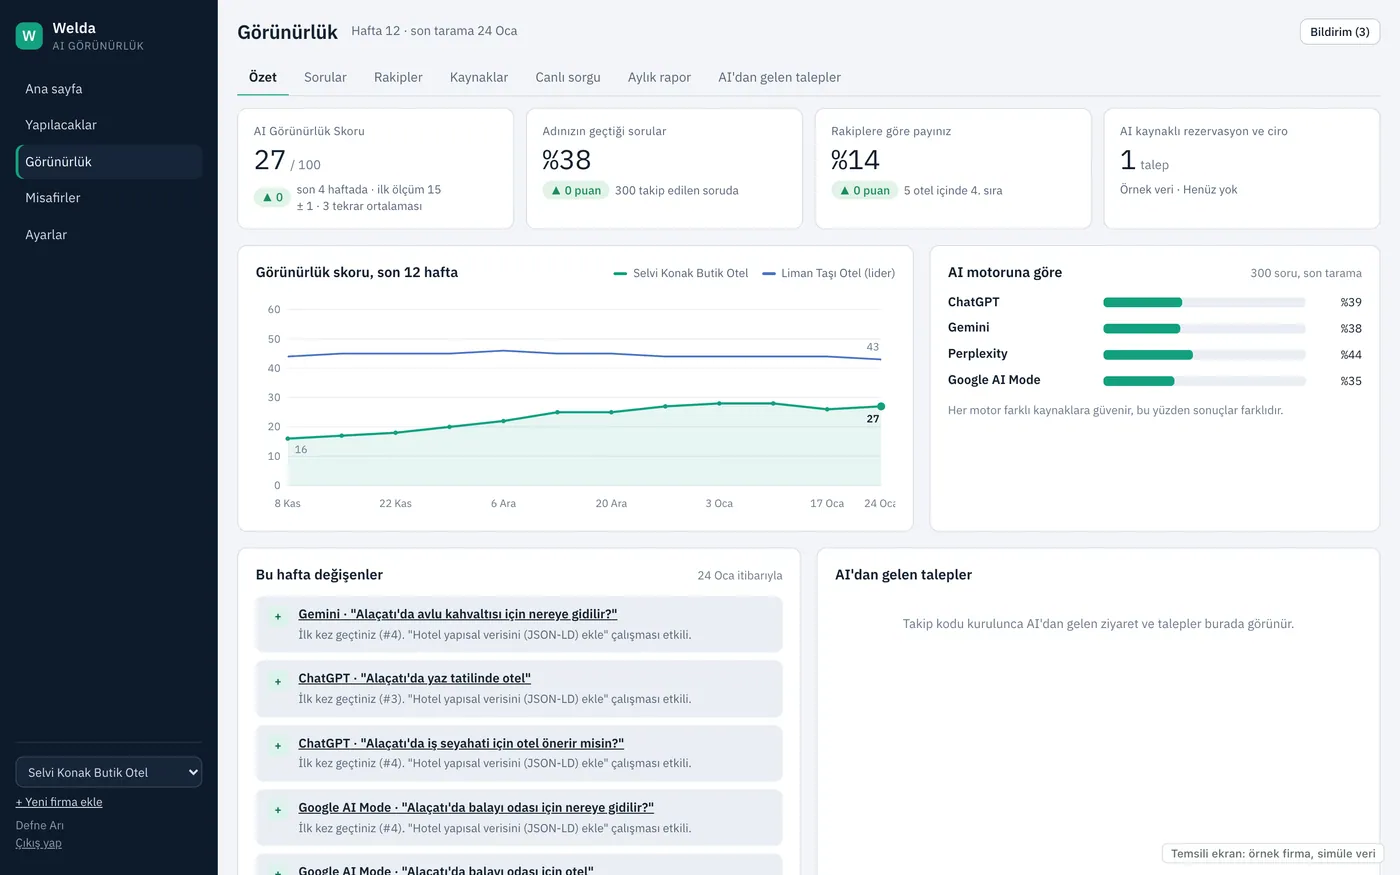
Geri kalan ekranlar bu ölçümün üzerine kuruludur. Yapılacaklar listesi, sınırda kalan sorular için eksik bilgiyi ve hazır metni gösterir; Welda içeriği ve profil metinlerini hazırlar, yayın onayı işletmede kalır. Rakipler ve kaynaklar ekranları, değişkenliğin hangi kaynaktan beslendiğini gösterir. Ayrıntılar için Welda'nın yapay zeka görünürlüğü sayfasına bakabilirsiniz.
Ücretsiz analizdeki ölçüm. Ücretsiz site analizi de müşterilerin sorabileceği 5 soruyu web araması yapabilen bir yapay zeka asistanına sorar ve cevaplarda işletme adınızın geçip geçmediğine bakar. Bu tek seferlik bir ölçümdür. Bu yazıda anlattığımız nedenlerle, bu sonucu bir başlangıç fotoğrafı olarak okuyun: adınız hiç geçmiyorsa sitenizdeki eksiklerle başlamak için iyi bir işarettir; geçiyorsa da bu, her denemede geçeceğiniz anlamına gelmez.
Değişen skoru nasıl okursunuz?
Ölçüm düzenli hale geldiğinde yeni bir soru ortaya çıkar: bu haftaki değişime tepki vermeli miyim? Aşağıdaki karar şeması bunun için.
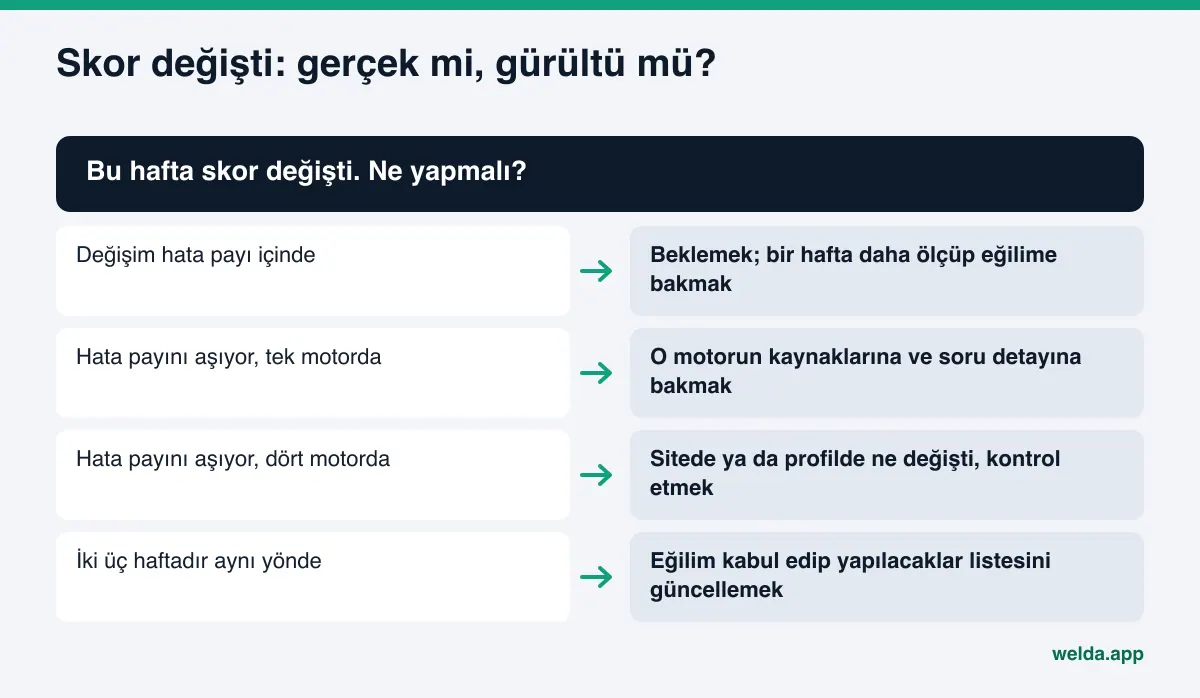
Pratikte üç okuma kuralı işinize yarar.
- Hata payından küçük değişimi not edin, ama tepki vermeyin. Bir hafta sonra yeniden bakın.
- Tek motordaki büyük değişimi o motorun kaynaklarında arayın. Bir motorun kaynak seçimi değişmiş olabilir; diğer motorlarda bir şey değişmediyse sorun sitenizde değil, o motorun beslendiği kaynaklardadır.
- Dört motorda birden olan değişimi kendinizde arayın. Sitenizde bir sayfa kaldırıldı mı, profilinizdeki bilgi değişti mi, robots.txt dosyanız yapay zeka botlarını engellemeye başladı mı?
Yeni içeriğin yapay zeka cevaplarına yansıması genelde haftalar sürer. Bir düzeltme yaptıktan sonraki ilk haftada skorun yerinden oynamaması normaldir. Beklenti yönetimi için ChatGPT'de görünmek ne kadar sürer yazısına göz atabilirsiniz.
Sınırlar ve Welda'nın yapmadıkları
Tekrarlı ölçüm değişkenliği yönetir, ama ortadan kaldırmaz. Bu yüzden neyin yapılamayacağını da açıkça söylemek gerekir.
- Kimse sabit bir sıra garanti edemez. Welda sıralama ya da "ChatGPT'de çıkma" garantisi vermez. Cevap her seferinde yeniden üretildiği için böyle bir garanti teknik olarak da anlamsızdır.
- Ölçüm, müşterinin tam olarak ne gördüğünü göstermez. Tekrarlı ölçüm, temiz ve sabit bir koşulda ne olduğunu tahmin eder. Belirli bir müşterinin kişisel ayarlarıyla gördüğü cevap bundan farklı olabilir.
- Ücretsiz analiz tek seferliktir. 5 soruluk test bir fotoğraftır, eğilim göstermez. Sıralama ölçmez.
- Welda bilmediği bilgiyi yazmaz. Bir soruda sınırda kalmanızın nedeni eksik bir bilgi ise (ör. çalışma saatleri, hizmet kapsamı), Welda bunu tahmin etmez, size sorar.
- Sahte yorum üretilmez. Değişkenliği lehinize çevirmenin kısa yolu yoktur. Olumsuz yorumlara cevap, dizin hesapları ve basın çalışması işletmede kalır.
- Onaysız hassas içerik yayınlanmaz. İçerik her zaman işletmenin kendi sitesinde durur ve yayın onayı işletmededir.
Kontrol listesi: bir sonuca güvenmeden önce
Bir ekran görüntüsü elinize geldiğinde, ister sizin aldığınız ister bir raporda size gösterilen olsun, aşağıdaki sorulardan geçirin.
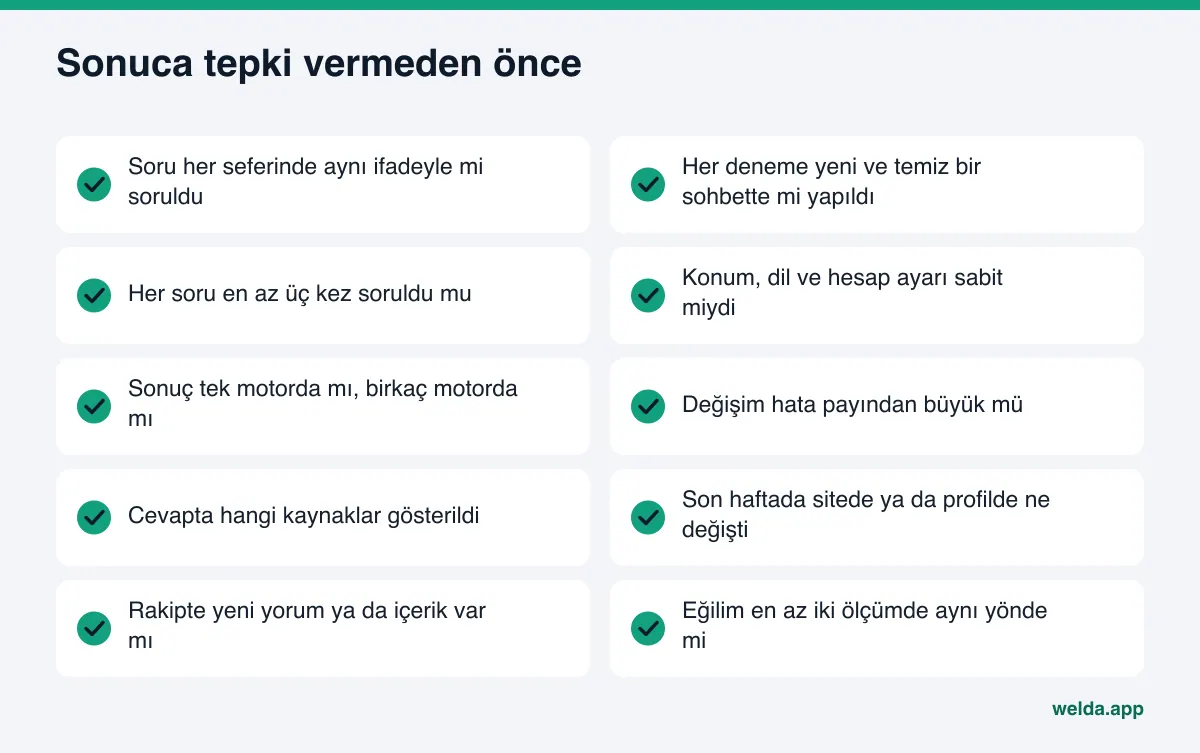
Bu listeyi bir ölçüm hizmeti ya da yazılımı değerlendirirken de kullanabilirsiniz. Şu üç soruyu sorun: Her soru kaç kez soruluyor? Sonuçlar motor bazında ayrı mı gösteriliyor? Skorun yanında bir hata payı ya da güven aralığı var mı? Bu üç sorunun cevabı yoksa, gösterilen sayıların ne kadar oynayabileceğini bilemezsiniz.
Sık sorulan sorular
Aynı soruyu iki kez sordum, farklı cevap aldım. Bir sorun mu var?
Hayır. Yapay zeka cevapları her seferinde yeniden üretilir ve çoğu zaman o anki web aramasına dayanır. Farklı cevap almak beklenen bir durumdur. Önemli olan, birkaç denemede ne sıklıkla anıldığınızdır.
Kaç tekrar yeterli?
Üç tekrar, sonucun ne kadar oynadığını görmeye ve ortanca almaya yeter. Daha fazla tekrar hata payını küçültür ama maliyeti ve süreyi artırır. Welda panelinde her soru her motorda üç kez sorulur.
Hata payı ne demek?
Üç tekrarın birbirinden ne kadar uzaklaştığından çıkan bir aralıktır. Örneğin skor 30 ve hata payı küçükse, gerçek görünürlüğünüz 30'a yakındır. Hata payı büyükse, haftalık küçük değişimlere anlam yüklememek gerekir.
Gizli pencere kullanmak yeterli mi?
Kişiselleştirmeyi azaltır ama değişkenliği ortadan kaldırmaz. Gizli pencerede de cevap her seferinde yeniden üretilir. Bu yüzden temiz oturum ile tekrarı birlikte kullanmak gerekir.
Ücretsiz analizdeki 5 soruluk test neden tek seferlik?
Ücretsiz analizin amacı sitenizdeki eksikleri göstermek ve nereden başlayacağınızı söylemektir. 5 soruluk test buna bir başlangıç fotoğrafı ekler. Düzenli, tekrarlı ve dört motorlu ölçüm Welda panelinde yapılır; panel erken erişimdedir.
Bir motorda varım, diğerinde yokum. Hangisine inanmalıyım?
İkisine de. Motorlar farklı kaynaklara bakar. Bir motorda görünüp diğerinde görünmemek, o motorun beslendiği kaynaklarda bir eksiğiniz olduğunu gösterir. Kaynak listesi bu eksiği bulmanın en kısa yoludur.
Sonuç: yapay zeka cevapları neden değişiyor ve ne yapmalı?
Yapay zeka cevapları neden değişiyor sorusunun kısa cevabı, cevabın her seferinde yeniden yazılmasıdır. Bu değişkenlik kalıcıdır ve onu yok etmeye çalışmak boşunadır. Yapılacak iş, ölçümü buna göre kurmaktır: aynı soruyu aynı koşulda birkaç kez sormak, motorları ayrı okumak, sonucu hata payıyla değerlendirmek ve kararları tek ekran görüntüsüne değil haftalık eğilime dayandırmak. Asıl iş ise sitenizi, profillerinizi ve yorumlarınızı güçlendirerek dağılımın merkezini kendi lehinize kaydırmaktır. Başlangıç noktanızı görmek için ücretsiz site analizini çalıştırın: sitenizin yapay zeka gözüyle nasıl okunduğunu, hangi eksiğin skoru ne kadar artıracağını ve uygulanacak hazır düzeltmeleri tek raporda görürsünüz.