AI görünürlük skoru nasıl ölçülür? Aynı soru setini birden çok AI motoruna, her soruyu birkaç kez sorarak ölçülür. Sonra üç sinyal tek sayıda toplanır: adınızın ne sıklıkla geçtiği, cevapta kaçıncı sırada geçtiği ve rakiplere göre payınız. Bu yazıda kullandığımız formül şu: 100 × (0,5 × geçme + 0,3 × sıra + 0,2 × pay). Yanına tekrarların sapmasından çıkan bir ± hata payı yazılır. Hata payı olmayan bir skor, tek bir ekran görüntüsünden çok az şey söyler.
Yazı, iki durumda işinize yarar: kendi ölçümünüzü bir tabloda kurmak istiyorsunuzdur ya da bir araç veya ajansın verdiği skorun neye dayandığını anlamak istiyorsunuzdur. GEO kavramının kendisi için SEO, GEO ve AEO yazımıza bakabilirsiniz; burada yalnızca ölçüm yöntemini ele alıyoruz.
Neden tek sorgu yanıltır?
ChatGPT'ye bir soru sorup adınızı görmek, ölçüm değil, tek bir çekiliştir. Aynı soruyu tekrar sorduğunuzda liste çoğu zaman değişir. Bunu gösteren iki çalışma var:
- BrightLocal'ın yerel AI görünürlük çalışmasına (16 Eylül 2026) göre tekrar edilen aramalarda sonuç kümeleri ortalama yalnızca şu kadar örtüşüyor: ChatGPT %23, Google AI Mode %21, AI Overviews %33. Bir kez görünen işletme ise sonraki denemelerin yaklaşık yarısında yeniden çıkıyor (ChatGPT ve AI Mode %50, AI Overviews %58).
- SparkToro ve Gumshoe.ai'nin çalışmasında (28 Ocak 2026) 600 gönüllü, 12 soruyu ChatGPT, Claude ve Google'ın AI cevaplarında toplam 2.961 kez çalıştırdı. Rand Fishkin'in hesabına göre ChatGPT veya Google'ın AI'ı aynı soruya 100 kez cevap verse, iki cevapta aynı marka listesinin çıkma ihtimali 100'de 1'in altında. Aynı sırada iki liste görmek için ise 1.000 çalıştırma civarı gerekiyor.
Sonuç açık: tek sorguda "çıktık" ya da "çıkmadık" demek anlamsız. Anlamlı olan oran, yani çok sayıda soruda ve tekrarda ne sıklıkla geçtiğiniz. SparkToro da aynı sonuca varıyor: tam isabetli ölçüm mümkün değil, ama onlarca ya da yüzlerce sorunun defalarca çalıştırılmasıyla bulunan görünürlük yüzdesi makul bir gösterge. Bu çalışmalar Türkçe pazara özel değil, bu yüzden oranları birebir taşımayın. Taşınacak olan ilke: tek cevaba güvenmeyin.
Formül: 0,5 geçme, 0,3 sıra, 0,2 pay
Skor = 100 × (0,5 × geçme + 0,3 × sıra puanı + 0,2 × pay)
| Bileşen | Soru | Hesap (0 ile 1 arası) | Ağırlık |
|---|---|---|---|
| Geçme | Cevapların ne kadarında adınız var? | Adınızın geçtiği cevap ÷ tüm cevaplar | 0,5 |
| Sıra puanı | Geçtiğinizde ne kadar önde geçiyorsunuz? | 1. sıra 1,0; 2. sıra 0,8; 3. sıra 0,6; 4. sıra 0,4; 5. sıra 0,2; daha aşağısı veya hiç geçmemek 0. Tüm cevapların ortalaması alınır. | 0,3 |
| Pay | Rakiplerle yan yana ne kadar yer tutuyorsunuz? | Sizin geçme sayınız ÷ izlenen tüm markaların toplam geçme sayısı | 0,2 |
Tablodaki puan basamakları bizim önerimiz, sektör standardı değil. Ağırlıklar için de aynısı geçerli: 0,5, 0,3 ve 0,2 bir tercihtir, deneysel olarak kanıtlanmış bir sabit değildir. Bu tercihin mantığı şu: önce cevapta olmak gerekir, bu yüzden geçme en ağır; sıra ve pay onu tamamlar. Başka ağırlık seçebilirsiniz. Önemli olan seçtiğinizi yazmak ve aylar boyunca değiştirmemek, çünkü ağırlık değişirse eski skorlarla kıyas biter.
Sıra puanı neden dikkat ister?
Formülün en tartışmalı parçası bu. SparkToro'nun yazısı, "AI'da sıralama pozisyonu" veren araçları açıkça eleştiriyor. Haklı bir nokta: tek cevaptaki sıra neredeyse rastgele. Burada kullandığımız şey ise tek bir sıra değil, yüzlerce cevabın ortalaması. O yüzden sıra puanını "kaçıncıyım" diye değil, "cevaplarda genelde önde mi arkada mı geçiyorum" diye okuyun.
İkinci tuzak paydadır. Ortalama sıra yalnızca adınızın geçtiği cevaplardan alınırsa, 150 cevabın birinde birinci geçen bir marka tam puan alır ve skoru şişer. Bu yüzden yukarıdaki hesapta geçilmeyen cevap 0 sayılıyor.
Araçlar aynı şeyi aynı biçimde ölçmüyor
Formülünü yazan üreticilerin tanımları karşılaştırıldığında farklar hemen görünür (dokümanlar 1 Kasım 2026'da kontrol edildi):
- Peec AI görünürlüğü adınızın geçtiği cevap ÷ tüm cevaplar olarak hesaplıyor. Pozisyonda yalnızca izlediğiniz rakipleri değil, cevapta tespit edilen tüm markaları sayıyor.
- Otterly kapsamı cevap yerine soru üzerinden hesaplıyor ve AI Overview çıkmayan soruları paydaya katmıyor. Ortalama pozisyonu ise yalnızca markanın göründüğü sorulardan alıyor.
Hiçbiri yanlış değil, yalnızca farklı. Bu nedenle iki aracın skorunu yan yana koymak çoğu zaman anlamsızdır. Aynı aracın kendi zaman serisine bakın.
Hesap örneği
Sayılar kurgudur, yalnızca hesabı göstermek içindir. Örnek bir butik otel 50 soruyu tek motorda 3 kez soruyor; toplam 150 cevap var.
- Geçme: Otelin adı 60 cevapta geçiyor. 60 ÷ 150 = 0,40.
- Sıra puanı: Geçtiği 60 cevapta puanların toplamı 30, geçmediği 90 cevapta 0. 30 ÷ 150 = 0,20.
- Pay: Otel ve izlenen rakiplerin toplam geçme sayısı 300. 60 ÷ 300 = 0,20.
- Skor: 100 × (0,5 × 0,40 + 0,3 × 0,20 + 0,2 × 0,20) = 20 + 6 + 4 = 30.
- Hata payı: Üç tekrar ayrı ayrı hesaplanınca 28, 30 ve 32 çıkıyor. Ortalama 30, standart sapma 2. Rapora "30 ± 2" yazılır.
Üç tekrar küçük bir örneklemdir. Bu ± değeri kesin bir istatistiksel güven aralığı değil, oynaklığın kaba bir göstergesidir. Tekrar sayısı arttıkça daha güvenilir hale gelir, maliyet de artar.
Soru seti nasıl kurulur: niyet, konum, durum
Skor, sorduğunuz sorular kadar dürüsttür. Yalnızca adınızın geçtiği ya da güçlü olduğunuz sorularla kurulan bir set, yüksek ama boş bir sayı verir. Seti üç eksende kurun:
| Eksen | Ne ölçer | Örnek |
|---|---|---|
| Niyet | Müşterinin hangi aşamada olduğu: araştırma, karşılaştırma, karar | "Küçük şirket için muhasebeci nasıl seçilir?", "Küçük şirket için muhasebeci öner" |
| Konum | Şehir, semt, "yakınımda" ifadesi | "Kadıköy'de teraslı restoran" |
| Durum | Özel ihtiyaç veya vesile | "Balayı için sakin butik otel", "Hafta sonu açık diş hekimi" |
Konum ekseni küçümsenmemeli. BrightLocal, aynı kasabanın farklı noktalarından yapılan aramalarda örtüşmeyi ChatGPT'de %36,2, AI Mode'da %46,9, AI Overviews'te %47,4 olarak ölçtü. Yani sorunun nereden sorulduğu da sonucu değiştiriyor.
Kurarken şu listeyi kontrol edin:
- Marka adı içeren sorular skora girmiyor; onlar ayrı izleniyor.
- Sorular müşterinin yazacağı gibi doğal Türkçe yazılmış.
- Bir ekseni şişirmemiş, üçünü dengeli dağıtmışsınız.
- Rakip listesi sabit. Liste değişirse pay da değişir.
- Set sürümlü. Soru eklerseniz yeni sürüm diye işaretliyor, eski skorla kıyaslamıyorsunuz.
- Her ölçümde tarih, motor, tekrar ve konum kaydı var.
Araç olmadan başlamak isterseniz 20 soru, 2 motor ve 3 tekrar, yani 120 cevaplık bir tablo bile ilk fikri verir. Dar kategorilerde sonuçlar daha tutarlı olabilir; SparkToro seçenek sayısı az olan bulut sağlayıcı sorularında, seçeneği çok olan bilimkurgu kitabı sorularına göre daha yüksek uyum gördü.
API cevabı ile uygulama cevabı aynı değildir
Bazı ölçüm araçları motorlara API üzerinden soru sorar. Ama müşteriniz API kullanmaz, uygulamayı açar. İki kanal arasındaki fark küçük değil:
- Surfer'ın analizinde (veri 4 Ağustos 2026, sayfa 4 Ekim 2026'da güncellendi) 1.000 soruda, API ile uygulamadan toplanan cevaplarda geçen markalar yalnızca %15,5 ile %23,8 arasında örtüştü.
- Brandlight'ın çalışmasında (Haziran 2026) 2.565 eşleşmiş cevap çiftinde marka örtüşmesi ChatGPT'de %11, Gemini'de %12, Perplexity'de %6 çıktı.
İki rakamı doğrudan kıyaslamayın: örneklem, konu ve eşleştirme yöntemi farklı. İki yayıncı da bu alanda ürün satıyor, bu bağlamı da akılda tutun. Yine de yön aynı: API verisi, müşterinin gördüğü ekranın birebir karşılığı değildir.
Uygulamadan veri toplamak da kusursuz değildir: oturum, konum, kişiselleştirme ve motorun o günkü sürümü sonucu etkiler. Bu yüzden doğru soru "hangisi kesin doğru?" değil, "bu skor hangi kanaldan geldi ve bu bana açıkça söyleniyor mu?" sorusudur. Araç seçiyorsanız bunu sorun; araç seçim rehberimiz diğer ölçütleri de sıralıyor. Google tarafının kendine özgü davranışı için AI Overviews yazımıza bakabilirsiniz.
Skoru nasıl okumalı, nasıl okumamalı?
| Gördüğünüz | Doğru okuma | Ne yapmalı |
|---|---|---|
| Skor hata payı içinde oynuyor (30 ± 2, sonra 31 ± 2) | Değişim yok, gürültü | Karar vermeyin, ölçmeye devam edin |
| Skor birkaç ölçüm üst üste hata payının dışında | Gerçek bir değişim olabilir | O dönemde yapılan işlere ve motor güncellemelerine bakın |
| Hata payı skorun kendisine yakın | Ölçüm çok oynak | Soru ve tekrar sayısını artırın |
| Geçme yüksek, sıra puanı düşük | Listedesiniz ama arkalardasınız | Önde geçen rakiplerin kaynaklarını inceleyin |
| Geçme genelde düşük, tek motorda yüksek | O motorun kaynaklarında varsınız, diğerlerinde yoksunuz | Motor bazında eksik kaynaklara bakın |
| İçerik yayınladınız, skor aynı gün aynı | Normal; motorların yeni içeriği işlemesi zaman alır | Haftalar içinde yeniden ölçün |
Skoru şunlar için kullanmayın:
- Ciro tahmini. Skor görünürlüğü ölçer, kaç müşteri geldiğini değil. Talep tarafını ayrı izlemek gerekir.
- Doğruluk kontrolü. Adınızın geçmesi, hakkınızda doğru şey söylendiği anlamına gelmez. Cevapları örnekleyip okuyun.
- Araçlar arası kıyas. Tanımlar farklı olduğu için 30 ile 45'in farkı yöntem farkı olabilir.
- Ajans performansının tek ölçütü. Soru setini ölçülen taraf belirliyorsa skor kolayca yükselir. Seti siz onaylayın; ajans mı yazılım mı kararı için karar rehberimize bakabilirsiniz.
Sık sorulan sorular
İyi bir AI görünürlük skoru kaçtır?
Evrensel bir eşik yok. Skor, soru setine ve rakip listesine bağlıdır, bu yüzden başka sektörle kıyaslanamaz. Anlamlı olan, aynı set üzerinde kendi eğiliminiz ve aynı formülle hesaplanan rakiplerinizle farkınızdır.
Ne sıklıkla ölçmek gerekir?
Standart bir sıklık yok. Küçük işletme için haftalık veya aylık ölçüm çoğu zaman yeterlidir. Motorların içeriği işlemesi zaman aldığından, günlük ölçüm kararlardan çok gürültü üretir.
Share of voice ile görünürlük skoru aynı şey mi?
Hayır. Share of voice, tüm markaların bahsedilmeleri içinde sizin payınızdır ve formülde yalnızca bir bileşendir. Rakipler de düştüğünde payınız artabilir, oysa görünürlüğünüz değişmemiştir. Bu yüzden tek başına okunmamalıdır.
Skoru yükseltmek için ne yapmak gerekir?
Skorun kendisi bir iş değil, kayıp soruları gösteren bir göstergedir. Önce hangi sorularda ve hangi kaynaklarda eksik kaldığınıza bakın. Sırayla atılacak adımlar için ChatGPT yol haritamıza bakabilirsiniz. Hiçbir yöntem belirli bir sıra için garanti veremez, çünkü cevaplar zaten değişkendir.
Welda AI Görünürlük bu yöntemi nasıl uyguluyor?
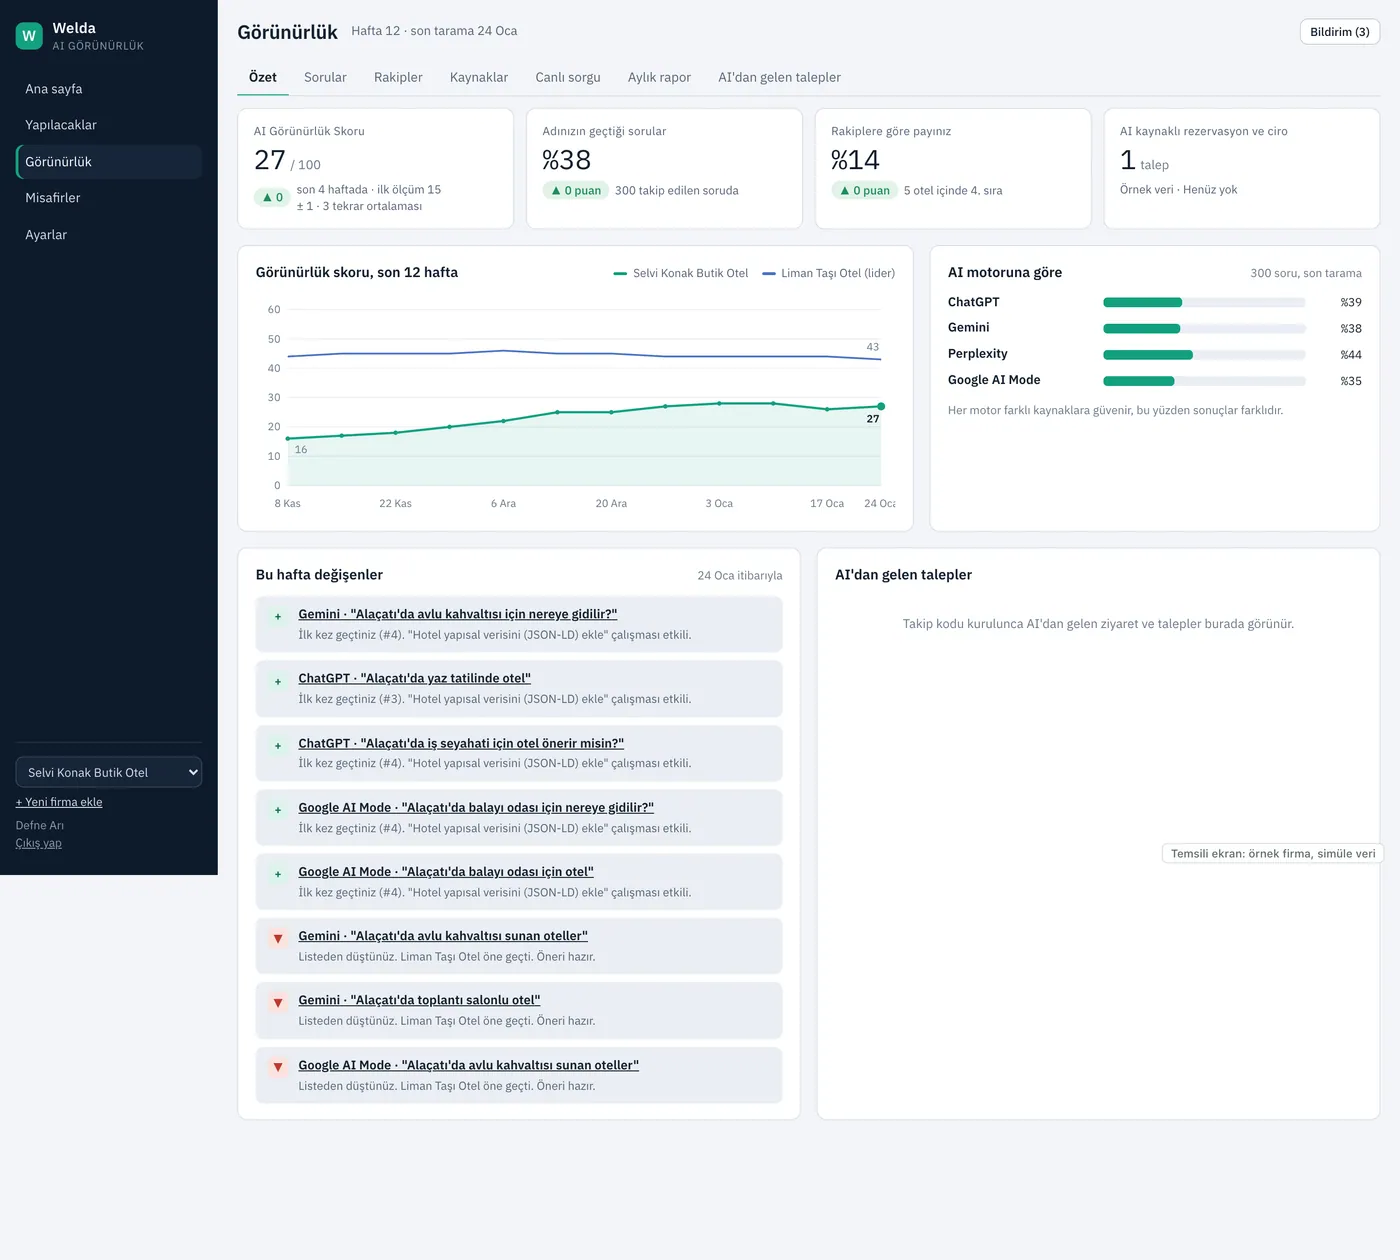
Welda AI Görünürlük, şu an erken erişim aşamasında bir üründür ve skor ekranı bu yazıdaki formül ve ağırlıklarla tasarlandı: sektöre ve semte göre 300 soru, ChatGPT, Gemini, Perplexity ve Google AI Mode, 3 tekrar, tekrarların sapmasından ± hata payı.
Açık konuşalım: erken erişimde skor ve motor ölçümleri simüledir, motorlara henüz gerçek sorgu atılmıyor. Rakip skorları da simüledir. Aşağıdaki ekrandaki sayılar bir ölçüm sonucu değil, ekranın nasıl görüneceğini gösteren örnek verilerdir. Site taraması ise gerçektir.
Ölçüm yönteminizi konuşmak ya da ürün hazır olduğunda haberdar olmak isterseniz erken erişim sayfasından kayıt bırakabilirsiniz.