Sollte Ihre robots.txt KI-Crawler sperren, und welche sollten Sie zulassen? Die robots.txt für KI-Crawler funktioniert wie bei Google: eine einfache Textdatei im Stammverzeichnis Ihrer Website, die Bots mitteilt, welche Pfade sie crawlen dürfen. Der Haken: KI-Bots sind nicht gleich. Manche sammeln Inhalte für das Training von Modellen, andere rufen Seiten ab, damit ChatGPT oder Perplexity Sie in einer Antwort als Quelle nennen können. Wenn Ihnen KI-Sichtbarkeit wichtig ist, lassen Sie die Such-Crawler offen und entscheiden Sie über Trainings-Crawler getrennt und bewusst.
Dieser Beitrag richtet sich an Inhaberinnen, Inhaber und Marketingverantwortliche kleiner und mittlerer Unternehmen in Deutschland, Österreich und der Schweiz, die sich mit GEO (Generative Engine Optimization) beschäftigen, also damit, in KI-generierten Antworten genannt und zitiert zu werden. Sie erfahren, was die wichtigsten Bots tun, was eine bestimmte Zeile tatsächlich sperrt, wie Sie Ihre Datei in einer Viertelstunde prüfen, welche Sperren außerhalb der Datei liegen und wie Welda Zugriffsprobleme findet und Ihnen die Korrektur vorbereitet.
Warum die robots.txt für KI-Crawler über Ihre KI-Sichtbarkeit mitentscheidet
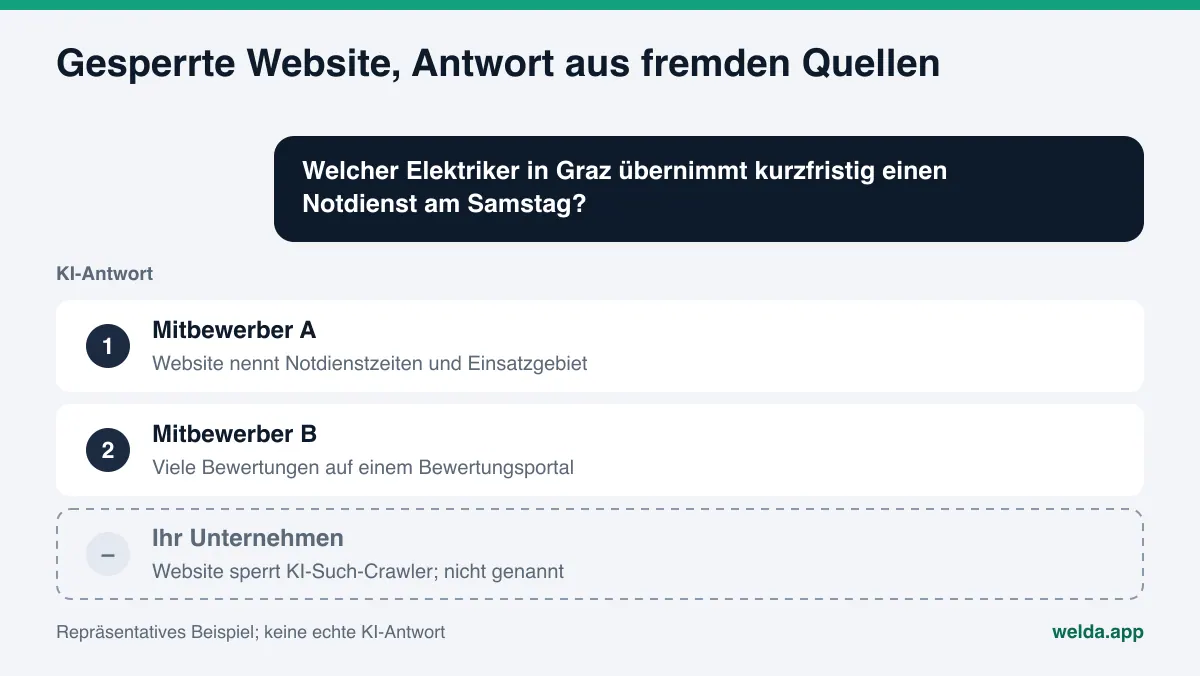
Fragt jemand ChatGPT oder Perplexity nach einem Elektriker mit Notdienst am Wochenende in Graz, führt das Werkzeug häufig eine Websuche durch, liest einige Seiten und baut daraus seine Antwort. Eine Seite, die es nicht lesen durfte, kann es nicht zitieren. Sagt Ihre robots.txt einem KI-Such-Crawler „draußen bleiben“, kennt die KI Sie nur aus dem, was andere über Sie schreiben: Ihr Google Unternehmensprofil, Gelbe Seiten, ProvenExpert, Trustpilot oder ein Forenbeitrag. Ihre eigenen Angaben zu Leistungen, Einsatzgebiet und häufigen Fragen fließen nicht ein.
Die meisten Unternehmen, die KI-Such-Crawler aussperren, tun das nicht absichtlich. Die Sperre entsteht meist so:
- Eine Zeile
Disallow: /aus der Entwicklungsphase, die beim Livegang nicht entfernt wurde. - Eine CMS-Einstellung wie „Suchmaschinen davon abhalten, diese Website zu indexieren“, die noch aktiv ist.
- Ein Sicherheits-Plugin oder Theme, das „KI-Bots blockieren“ standardmäßig einschaltet.
- Eine lange Sperrliste, die im Zuge der Debatte um KI-Training aus einem Blogbeitrag kopiert wurde und dabei neben Trainings- auch Such-Crawler ausschließt.
- Ein Botschutz beim CDN oder Hoster, der KI-User-Agents unabhängig von der robots.txt abweist.
Die Wirkung ist immer gleich: Für menschliche Besucher sieht die Website normal aus, aber der Crawler, der KI-Antworten speist, bleibt vor der Tür. Deshalb gehört der Crawler-Zugriff zu den ersten Punkten jeder ernsthaften Prüfung der KI-Sichtbarkeit. Gute Inhalte helfen wenig, wenn niemand sie lesen kann. Wenn Sie wissen möchten, wie es um Ihre Website steht, prüft die kostenlose Website-Analyse genau diesen Punkt als einen der ersten.
Welche KI-Crawler gibt es und was tun sie?
Bot-Namen sollten Sie aus den Dokumentationen der Anbieter entnehmen, nicht aus Vermutungen; Namen und Aufgaben ändern sich. Die Tabelle fasst zusammen, was die offiziellen Dokumentationen mit Stand November 2026 sagen. Den aktuellen Wortlaut finden Sie in der Crawler-Dokumentation von OpenAI, im Bot-Leitfaden von Perplexity und in Googles Übersicht der Crawler.
| User-Agent | Anbieter | Wozu er kommt | Verhältnis zur robots.txt |
|---|---|---|---|
OAI-SearchBot | OpenAI | Zeigt Websites in den Suchfunktionen von ChatGPT | Hält sich daran. Gesperrt, verlieren Sie Quellenangaben in ChatGPT-Suchantworten. |
GPTBot | OpenAI | Crawlt Inhalte, die für das Training von Basismodellen genutzt werden können | Hält sich daran. Eine Sperre signalisiert: kein Training. Die Sichtbarkeit in der Suche steuert sie nicht. |
ChatGPT-User | OpenAI | Öffnet eine Seite, wenn ein Nutzer ChatGPT fragt | Vom Nutzer ausgelöst, daher gelten robots.txt-Regeln möglicherweise nicht. |
PerplexityBot | Perplexity | Zeigt und verlinkt Websites in Perplexity-Ergebnissen | Die Doku empfiehlt, ihn zuzulassen; er wird laut Anbieter nicht für Modelltraining genutzt. |
Perplexity-User | Perplexity | Ruft eine Seite für eine Nutzerfrage ab | Ignoriert robots.txt laut Doku in der Regel. |
Google-Extended | Kein eigener Crawler, sondern ein Token: steuert die Nutzung für Gemini-Training und einige Gemini-Produkte | Laut Google ohne Einfluss auf Aufnahme oder Ranking in der Google Suche. |
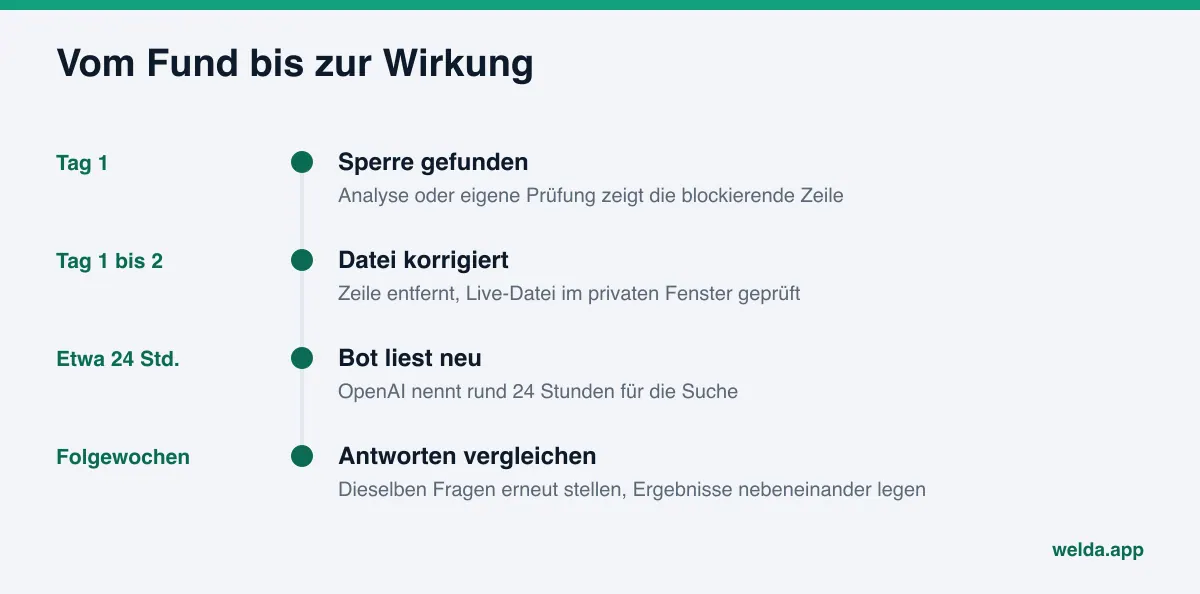
Die wichtigste Erkenntnis: Ein Anbieter betreibt mehrere Bots, und jeder wird einzeln gesteuert. OpenAI schreibt ausdrücklich, dass eine Website OAI-SearchBot für die Suche zulassen und GPTBot für das Training sperren kann. „Keine Nutzung fürs Training“ heißt also nicht zwingend „keine Sichtbarkeit in der ChatGPT-Suche“. Laut OpenAI kann es etwa 24 Stunden dauern, bis eine Änderung der robots.txt in den Suchergebnissen wirkt.
Bei Google liegt der Fall anders. Nach Googles Dokumentation zu KI-Funktionen gibt es keine zusätzlichen Anforderungen für KI-Übersichten oder den KI-Modus: Die Seite muss indexiert und berechtigt sein, in der Google Suche mit Snippet zu erscheinen. Praktisch bedeutet das: normaler Zugriff für den Googlebot. Für Google öffnen Sie keine eigene KI-Tür, Sie sorgen dafür, dass die normale nicht verschlossen ist.
Trainings-Crawler oder Such-Crawler: was jede Sperre kostet
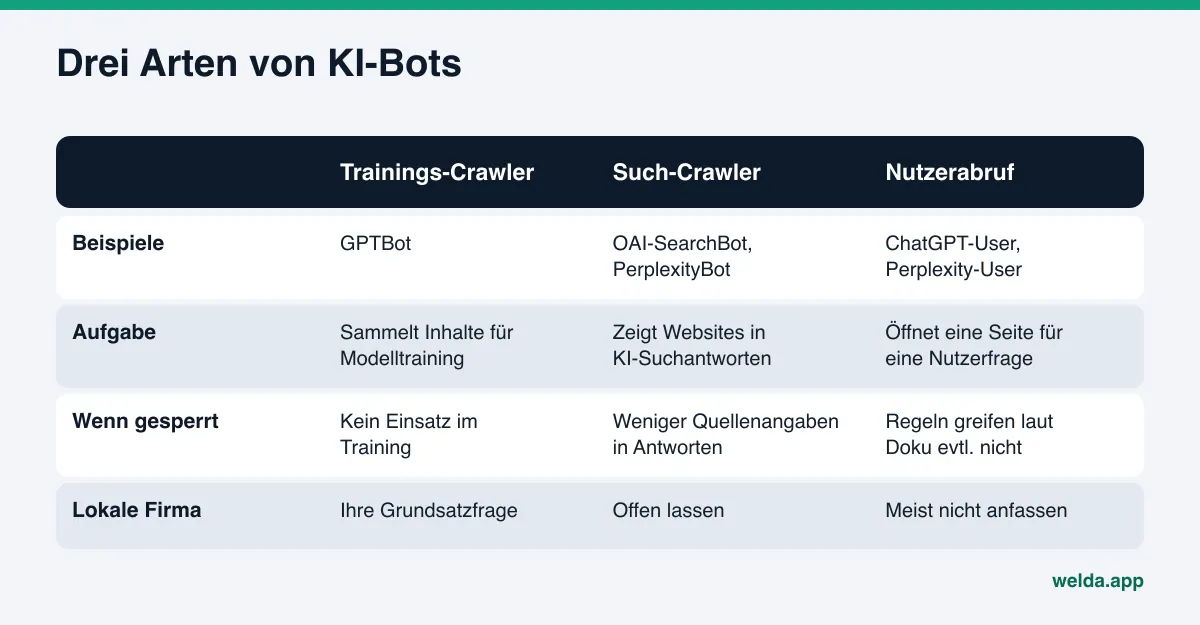
Der häufigste Fehler ist, alle KI-Bots als eine Gruppe zu behandeln. Es sind drei, und jede Sperre hat eine andere Folge.
Trainings-Crawler wie GPTBot sammeln Inhalte, die für künftige Modellversionen genutzt werden können. Sie zu sperren ist eine Grundsatzentscheidung. Verlage und Kreative wollen ihre Werke oft nicht in Trainingsdaten sehen, das ist eine legitime Haltung. Für eine Zahnarztpraxis oder einen Handwerksbetrieb bringt es dagegen wenig, öffentliche Angaben wie Öffnungszeiten und Leistungen vom Training fernzuhalten. Die Entscheidung liegt bei Ihnen; treffen Sie sie bewusst.
Such-Crawler wie OAI-SearchBot und PerplexityBot lesen Ihre Website, damit die KI sie in aktuellen Antworten zitieren kann. Eine Sperre ist hier ein direkter Verlust an KI-Sichtbarkeit. Die KI beantwortet die Frage trotzdem, nur aus anderen Quellen. Selbst wenn Ihr Name fällt, führt der Link womöglich zu einem Branchenverzeichnis statt zu Ihrer Website.
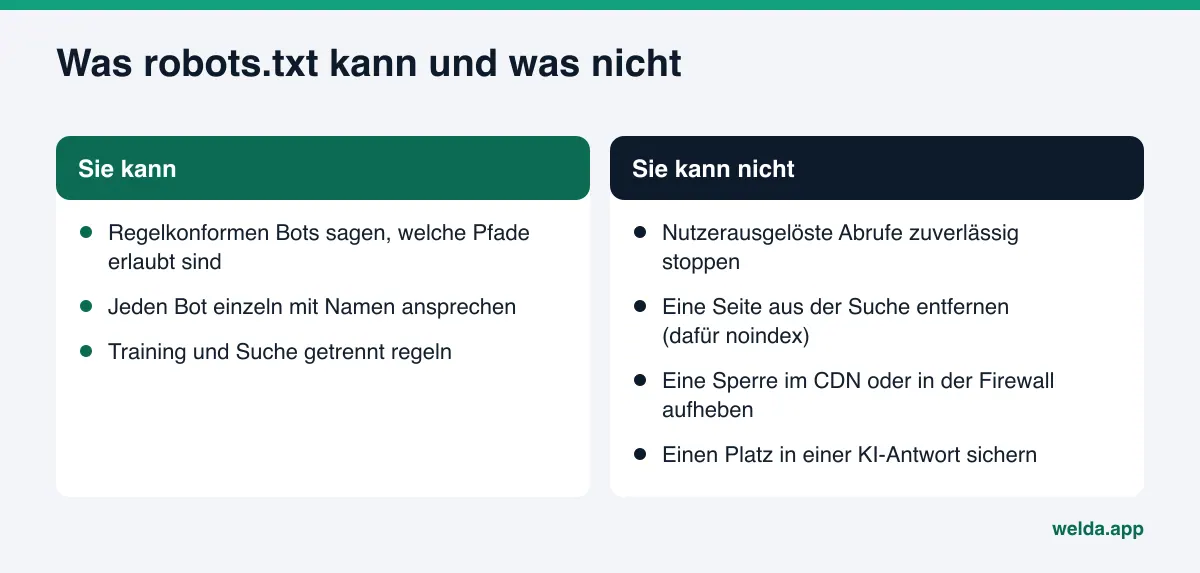
Nutzerausgelöste Abrufe wie ChatGPT-User und Perplexity-User kommen, wenn eine Person die KI bittet, eine bestimmte Seite zu öffnen. Beide Anbieter schreiben, dass die robots.txt hier möglicherweise nicht greift, weil ein Mensch den Abruf ausgelöst hat. Diese Bots über die robots.txt zu steuern, führt selten zum Ziel, und meist gibt es auch keinen Grund dafür.
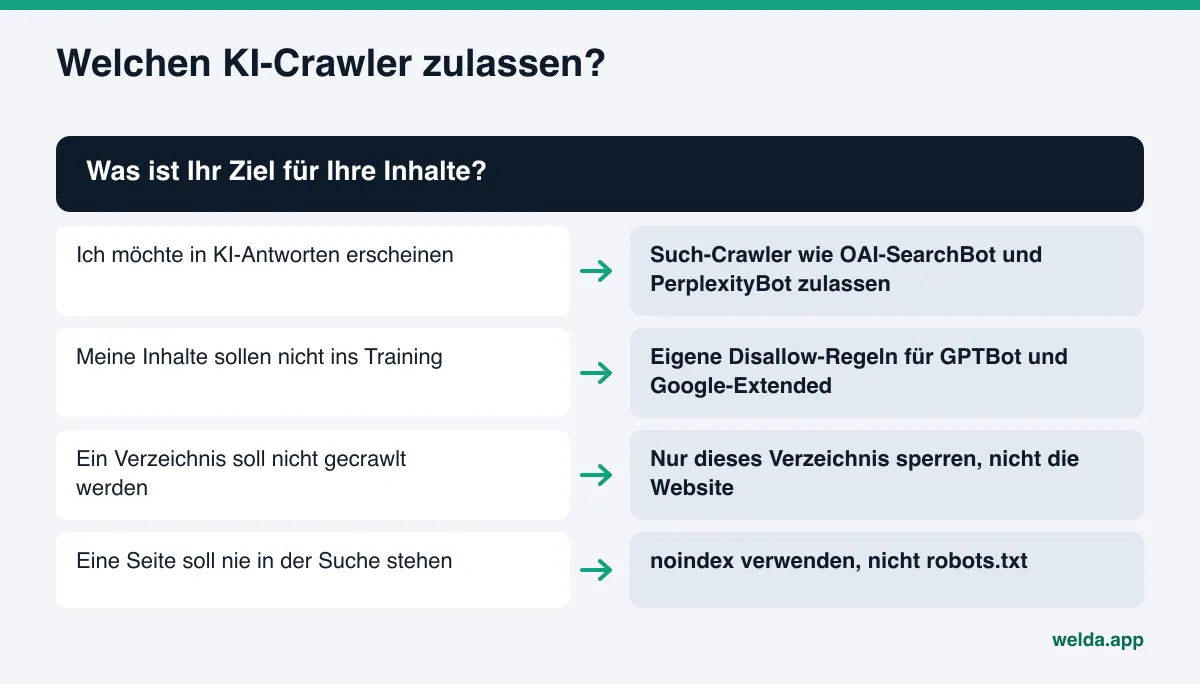
Kurz gesagt: Wer in KI-Antworten erscheinen will, lässt Such-Crawler offen, schreibt für Trainings-Crawler eine eigene, bewusste Regel und lässt nutzerausgelöste Abrufe in Ruhe. Zu Gemini: Laut Google steuert das Token Google-Extended, ob Inhalte für das Training von Gemini-Modellen und in einigen Gemini-Produkten genutzt werden, nicht aber die Google Suche. Wenn Sie es sperren möchten, beziehen Sie die Gemini-Seite in Ihre Abwägung ein.
robots.txt für KI-Crawler Schritt für Schritt prüfen
Dafür brauchen Sie keine Agentur. Ein Browser und eine Viertelstunde genügen.
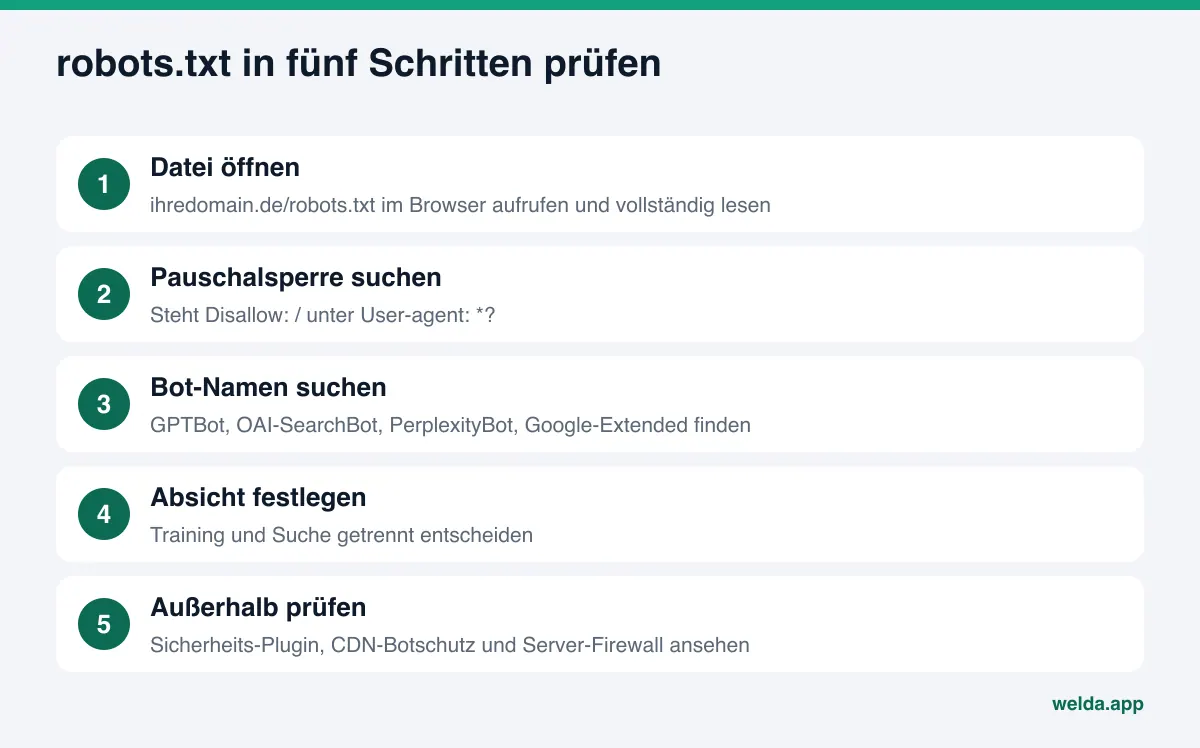
- Datei öffnen. Geben Sie
ihredomain.de/robots.txtim Browser ein. Lädt nichts, gibt es keine Datei, und Bots betrachten die Website in der Regel als crawlbar. Lädt die Datei, lesen Sie jede Zeile, nicht nur den Anfang. - Pauschalsperre suchen. Steht unter
User-agent: *die ZeileDisallow: /? Dann ist jeder Bot, der nicht ausdrücklich erlaubt ist, von der ganzen Website ausgeschlossen. Diese Zeile stammt meist aus der Entwicklungsphase. - Bot-Namen suchen. Kommen
GPTBot,OAI-SearchBot,ChatGPT-User,PerplexityBotoderGoogle-Extendedvor? Notieren Sie, was jeweils darunter steht. - Pfade prüfen. Sind einzelne Verzeichnisse statt der ganzen Website gesperrt? Leistungs-, Preis- oder Kontaktseiten liegen womöglich unter einem versehentlich gesperrten Pfad.
- Absicht festhalten. Beantworten Sie zwei Fragen getrennt: Dürfen Ihre Inhalte ins Training, und wollen Sie in der KI-Suche erscheinen? Passen Sie die Datei an beide Antworten an.
- Sperren außerhalb der Datei prüfen. Sicherheits-Plugins, CDN-Botschutz, Serverregeln. Mehr dazu weiter unten.
- Speichern und neu laden. Öffnen Sie die Datei nach der Änderung in einem privaten Fenster. Sehen Sie noch die alte Fassung, muss eventuell ein Cache geleert werden.
Am Ende haben Sie eine kurze Notiz, welcher Bot welche Seiten erreicht, und eine klare Antwort, ob das zu Ihrer Absicht passt. Wo der Crawler-Zugriff im größeren Zusammenhang steht, zeigt unser Beitrag zum GEO-Audit.
Drei Beispieldateien
Die Beispiele decken die drei häufigsten Absichten ab. Bevor Sie eines übernehmen, behalten Sie bestehende Regeln bei, die Ihre Website braucht, etwa für Adminbereich, Warenkorb oder interne Suchseiten. Es sind Beispiele; die richtige Datei hängt immer vom Aufbau Ihrer Website ab.
Beispiel 1: In der KI-Suche erscheinen, keine Einwände gegen Training. Die einfachste Fassung. Eigene KI-Zeilen sind nicht nötig:
User-agent: *
Disallow: /wp-admin/

Sitemap: https://ihredomain.de/sitemap.xml
Beispiel 2: In der KI-Suche erscheinen, aber nicht ins Training. Trainings-Crawler werden namentlich gesperrt, Such-Crawler bleiben offen:
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: *
Disallow: /wp-admin/
Beispiel 3: Nur einen Bereich ausnehmen. Haben Sie einen Mitgliederbereich, sperren Sie nur dieses Verzeichnis, nicht die ganze Website:
User-agent: *
Disallow: /mitglieder/
Typische Fehler: einen User-Agent falsch schreiben (etwa „GPT-Bot“), zwei widersprüchliche Blöcke für denselben Bot stehen lassen, die Datei in einen Unterordner statt ins Stammverzeichnis legen und die robots.txt nutzen, um eine Seite aus der Suche zu nehmen. Der letzte Punkt ist wichtig: Soll eine Seite nie in der Suche erscheinen, gehört noindex auf die Seite. Die robots.txt steuert nur das Crawling.
Sperren außerhalb der robots.txt, die KI-Crawler trotzdem aufhalten
Ihre robots.txt kann sauber sein, und KI-Such-Crawler werden trotzdem abgewiesen. Auch Google empfiehlt, das Crawling nicht nur in der robots.txt, sondern auch beim CDN und in der Hosting-Infrastruktur zu erlauben. Hier sollten Sie nachsehen:
- CDN-Botschutz. Manche CDN-Anbieter bieten eine Einstellung, die KI-Bots mit einem Klick blockiert. Sie wirkt unabhängig von der robots.txt: Die Datei sagt „herein“, die Anfrage erreicht den Server trotzdem nicht.
- Sicherheits-Plugins. Bei WordPress weisen Sicherheits- oder Performance-Plugins unbekannte Bots mitunter ab. Prüfen Sie deren Bot-Einstellungen. Mehr dazu im Beitrag WordPress und GEO.
- Server- und Firewall-Regeln. Die Firewall Ihres Hosters oder Regeln in der
.htaccesskönnen bestimmte User-Agents blockieren. - Langsame Seiten und Zeitüberschreitungen. Der Bot versucht es, aber die Seite antwortet nicht rechtzeitig. Das behandeln wir unter Ladezeit und KI-Crawler.
- Tags auf Seitenebene.
noindexundnosnippetbegrenzen, wie Google eine Seite in der Suche und in KI-Funktionen zeigt. - Inhalte nur per JavaScript. Selbst wenn der Bot hineinkommt, findet er womöglich kaum Text, wenn die Seite erst im Browser entsteht.
„Meine robots.txt ist in Ordnung“ ist also nicht das Ziel. Die eigentliche Frage lautet: Kann ein Such-Crawler Ihre Seite öffnen und ihren Text lesen?
Wie Sie prüfen, ob die Korrektur wirkt
Die Datei zu ändern ist die halbe Arbeit. Die andere Hälfte ist die Bestätigung, dass Crawler wirklich hineinkommen. Drei Prüfungen reichen.
Die Live-Datei ansehen. Die bearbeitete Datei und die ausgelieferte Datei können sich unterscheiden. Manche CMS erzeugen die robots.txt dynamisch, und ein Plugin kann die Änderung eines anderen überschreiben. Erledigt ist die Aufgabe erst, wenn Sie die neuen Zeilen in einem privaten Fenster sehen.
Server-Logs prüfen. Haben Sie Zugriff auf die Logs Ihres Hosters, suchen Sie im User-Agent-Feld nach OAI-SearchBot oder PerplexityBot. Entscheidend ist der Statuscode: 200 heißt, die Seite wurde ausgeliefert; 403 oder 429 heißt, eine Sicherheitsschicht hat den Bot abgewiesen. Ohne Zugriff bitten Sie Ihren Hoster oder Ihre Webagentur um diese Prüfung. Beachten Sie dabei, dass Server-Logs je nach Inhalt personenbezogene Daten enthalten können; ob und wie lange sie gespeichert werden dürfen, regelt die DSGVO. Das ist keine Rechtsberatung, klären Sie Details mit Ihrem Datenschutzbeauftragten.
Vorher und nachher vergleichen. Notieren Sie vor der Korrektur einige Fragen, die Ihre Kundschaft wirklich stellt, und halten Sie fest, ob KI-Assistenten Sie nennen. Stellen Sie dieselben Fragen einige Wochen nach der Korrektur erneut. Verlassen Sie sich nicht auf einen einzigen Versuch, denn KI-Antworten können bei derselben Frage variieren. Jede Frage mehrmals zu stellen und die Ergebnisse nebeneinanderzulegen, ergibt ein verlässlicheres Bild.
Ein Beispielszenario: Ein Schreinerbetrieb lässt seine Website neu aufsetzen, und die Agentur vergisst beim Livegang das Disallow: / aus der Entwicklungsphase. Neue Leistungsseiten, Einsatzgebiet und FAQ sind online, aber keine davon taucht als Quelle in KI-Antworten auf. Ist die Zeile entfernt, folgen die drei Prüfungen oben in dieser Reihenfolge, danach geht es an die Inhalte.
Wie Welda den Zugriff von KI-Crawlern prüft
Welda ist eine Software, die misst, wo ein Unternehmen in KI-Antworten erscheint, und fehlende Bausteine im Auftrag des Unternehmens ergänzt. Der Crawler-Zugriff spielt dabei an zwei Stellen eine Rolle: bei der ersten Diagnose und bei der laufenden Quellenbeobachtung.
Diagnose in der kostenlosen Analyse. Die kostenlose Website-Analyse liest Ihre Startseite und einige Unterseiten wie Leistungen, Preise, Über uns und Kontakt. Eine der ersten Prüfungen gilt der Frage, ob KI-Bots über die robots.txt auf Ihre Website gelangen. Zu jedem Befund nennt der Bericht, was gefunden wurde, warum es wichtig ist und wie es sich beheben lässt. Eine Simulation zeigt, wie stark jede Korrektur den Score verändern würde; so sehen Sie die Zugriffskorrektur neben den übrigen Aufgaben und können die Reihenfolge festlegen. Außerdem stellt die Analyse fünf typische Kundenfragen an einen KI-Assistenten mit Websuche und prüft, ob Ihr Unternehmensname in den Antworten vorkommt. Das ist eine einmalige Momentaufnahme: als Ausgangswert nützlich, aber kein Ersatz für eine laufende Messung nach der Änderung. Die kostenlose Analyse funktioniert auf Deutsch.
Quellenbeobachtung im Dashboard. Das Welda-Dashboard hat eine Quellenansicht, die zeigt, auf welche Websites sich KI-Systeme bei ihren Antworten stützen und wie Sie dort aufgestellt sind. Ihre eigene Website ist eine dieser Zeilen. Ist sie nicht erreichbar, steht dort ein Zugriffshinweis mit der Aufgabe, das Problem zu beheben. Die Entscheidung, die Sie dort treffen, ist einfach: Fehlt Ihre eigene Website als Quelle, oder liegt die Lücke bei Verzeichnissen und Profilen? Der Zugriff hat Vorrang, denn jede neue Seite hilft erst, wenn sie gelesen werden kann.
Was bei Ihnen bleibt. robots.txt, CDN-Einstellungen und Sicherheits-Plugins liegen in Ihrer Website und Ihrem Hosting-Konto. Welda ändert sie nicht selbst. Welda beschreibt, was geändert werden muss, und legt die Aufgabe als manuelle Aufgabe in Ihre Aufgabenliste, mit fertigem Text daneben: die genauen Zeilen für die Datei oder eine kurze Notiz für Ihre Webagentur. Bei WordPress-Websites kann sich Welda über einen eigenen Redakteur-Benutzer verbinden und Inhalte als Entwurf anlegen; Servereinstellungen wie die robots.txt bleiben bei Ihnen.
Das Dashboard befindet sich im Early Access und wird schrittweise freigeschaltet, zuerst für Unternehmen in der Türkei. Die regelmäßige Messung über vier KI-Systeme wird während des Early Access ergänzt; Beispielansichten zeigen repräsentative Daten. Eine deutschsprachige Oberfläche des Dashboards gibt es derzeit nicht. Was heute alle nutzen können, ist die kostenlose Website-Analyse. Preise werden im Early-Access-Gespräch besprochen.
Grenzen: was robots.txt und Welda nicht versprechen können
Eine korrigierte robots.txt ist eine Voraussetzung, kein Ergebnis. Wenn ein Such-Crawler hineinkommt, heißt das nicht, dass die KI Sie empfiehlt. Sie liest Ihre Website und baut die Antwort trotzdem auf Klarheit der Inhalte, Stimmigkeit Ihrer Unternehmensdaten, Bewertungen und darauf, was andere Quellen sagen. Nach der Öffnung dauert es meist Wochen, bis neue Inhalte in KI-Antworten auftauchen.
Weldas Grenzen sind hier klar:
- Welda verspricht keine Rankings und keinen Platz in ChatGPT. Die kostenlose Analyse misst keine Rankings.
- Welda ändert weder robots.txt noch CDN- oder Serverregeln für Sie. Welda sagt, was zu tun ist; umsetzen müssen Sie oder Ihre Agentur.
- Welda ergänzt nichts, was es nicht weiß. Ist unklar, warum ein Verzeichnis gesperrt ist, fragt Welda nach, statt zu raten.
- Ob Trainings-Crawler zugelassen werden, ist Ihre Inhaltsrichtlinie. Welda zeigt die Wirkung auf die KI-Sichtbarkeit und überlässt Ihnen die Entscheidung.
- Ob nutzerausgelöste Abrufe die robots.txt beachten, legt der jeweilige KI-Anbieter fest. Darauf hat Welda keinen Einfluss.
Noch ein Hinweis: Die robots.txt ist kein Sicherheitswerkzeug. Was vertraulich bleiben muss, braucht Passwort und Zugriffsschutz. Die Datei ist öffentlich, ebenso die Pfade, die Sie darin auflisten.
Prüfliste: Ist Ihre robots.txt bereit für KI-Crawler?
Öffnen Sie Ihre Datei und gehen Sie die Tabelle Zeile für Zeile durch. Die Spalte „Erwartet“ zeigt den üblichen Zustand für ein Unternehmen, das in KI-Antworten erscheinen möchte.
| Prüfpunkt | Erwartet | Falls nicht |
|---|---|---|
Disallow: / unter User-agent: * | Nicht vorhanden | Entfernen oder auf nötige Verzeichnisse begrenzen |
OAI-SearchBot gesperrt | Nein | Sperre aufheben; nötig für Quellenangaben in der ChatGPT-Suche |
PerplexityBot gesperrt | Nein | Sperre aufheben; nötig für Quellenangaben bei Perplexity |
| Zugriff für Googlebot | Offen | Seiten müssen für KI-Übersichten und KI-Modus indexiert sein |
GPTBot und Google-Extended | Bewusste Entscheidung | Trainingsrichtlinie schriftlich festhalten |
| Leistungs-, Preis-, Kontaktseiten | Crawlbar | Regel korrigieren, die diese Pfade sperrt |
| CDN und Sicherheits-Plugin | Offen für Such-Crawler | Botschutz-Einstellungen prüfen |
| Sitemap-Zeile | Vorhanden | Sitemap-Adresse ergänzen |
Brauchen zwei oder mehr Zeilen Arbeit, beheben Sie zuerst den Zugriff, bevor Sie an Titel oder Inhalte gehen. Titel und Beschreibungen behandeln wir unter Title und Meta Description für KI-Suche, doch der Zugriff kommt zuerst. Im englischsprachigen Raum hören Sie für dieselbe Arbeit oft auch AEO (Answer Engine Optimization); gemeint ist im Kern dasselbe wie GEO.
Häufige Fragen
Wenn ich keine robots.txt habe, können KI-Crawler meine Website erreichen?
In der Regel ja. Ohne Datei gilt die Website als crawlbar. Trotzdem ist es sinnvoll, eine Datei anzulegen, die Sitemap einzutragen und Ihre Absicht klar festzuhalten.
Wenn ich GPTBot sperre, verschwinde ich dann aus ChatGPT?
Laut OpenAI nein. Es sind getrennte Einstellungen. GPTBot dient dem Training. Für ChatGPT-Suchantworten muss OAI-SearchBot zugelassen sein. Sie können GPTBot sperren und OAI-SearchBot offen lassen.
Nimmt mich eine Sperre von Google-Extended aus den KI-Übersichten?
Laut Google beeinflusst Google-Extended weder die Aufnahme in die Google Suche noch das Ranking. Für KI-Übersichten und den KI-Modus muss die Seite indexiert und mit Snippet darstellbar sein, was vom Googlebot-Zugriff abhängt. Google-Extended steuert bestimmte Nutzungen bei Gemini.
Wie schnell wirkt eine Änderung an der robots.txt?
Das hängt davon ab, wann der Bot die Datei neu liest. OpenAI nennt etwa 24 Stunden bis zur Wirkung in den Suchergebnissen. Gecrawlt werden und in KI-Antworten genannt werden sind aber zwei verschiedene Dinge; Letzteres dauert meist Wochen.
Ist es eine sichere Wahl, alle KI-Bots zu sperren?
Das ist Ihre Grundsatzentscheidung. Eine Sperre, die auch Such-Crawler umfasst, verhindert aber weitgehend, dass Ihre Website in KI-Antworten zitiert wird. Ist Ihnen KI-Sichtbarkeit wichtig, behandeln Sie Trainings- und Such-Crawler getrennt.
Korrigiert Welda meine robots.txt selbst?
Nein. Welda findet das Problem und liefert die Änderung als fertigen Text. Die Datei oder die Servereinstellungen ändern Sie oder Ihre Agentur.
Prüfen Sie, ob KI-Crawler Ihre Website erreichen
Die robots.txt gehört zu den günstigsten und schnellsten Stellschrauben der KI-Sichtbarkeit, und zu den folgenreichsten, wenn ein Fehler unbemerkt bleibt. Ihre eigene Datei können Sie mit den Schritten oben prüfen. Möchten Sie Crawler-Zugriff, Titel, Unternehmensangaben und FAQ in einem Bericht sehen, starten Sie die kostenlose Website-Analyse. Sie ist einmal pro Website kostenlos; E-Mail-Adresse und Telefonnummer werden bestätigt, der Ergebnislink kommt per E-Mail und bleibt 14 Tage abrufbar.