robots.txt yapay zeka botlarını engelliyor mu, hangisine izin vermelisiniz? robots.txt, sitenizin kökünde duran ve botlara hangi sayfaları tarayabileceklerini söyleyen kısa bir metin dosyasıdır. Yapay zeka botları tek tip değildir: bir kısmı model eğitimi için içerik toplar, bir kısmı ChatGPT ve Perplexity gibi araçların arama cevaplarında sitenizi gösterir. Yapay zeka cevaplarında görünmek istiyorsanız arama botlarını açık tutmanız, eğitim botları için ise ayrı ve bilinçli bir karar vermeniz gerekir.
Bu yazıda robots.txt dosyasının yapay zeka botlarıyla ilişkisini sade bir dille anlatıyoruz: hangi bot ne iş yapar, hangi satır neyi kapatır, dosyanızı nasıl kontrol edersiniz ve dosyanın dışında kalan engelleri nasıl bulursunuz. Sonda Welda'nın bu erişim sorununu nasıl tespit ettiğini ve işletmeye ne iş bıraktığını da göreceksiniz.
robots.txt yapay zeka botları için neden önemli?
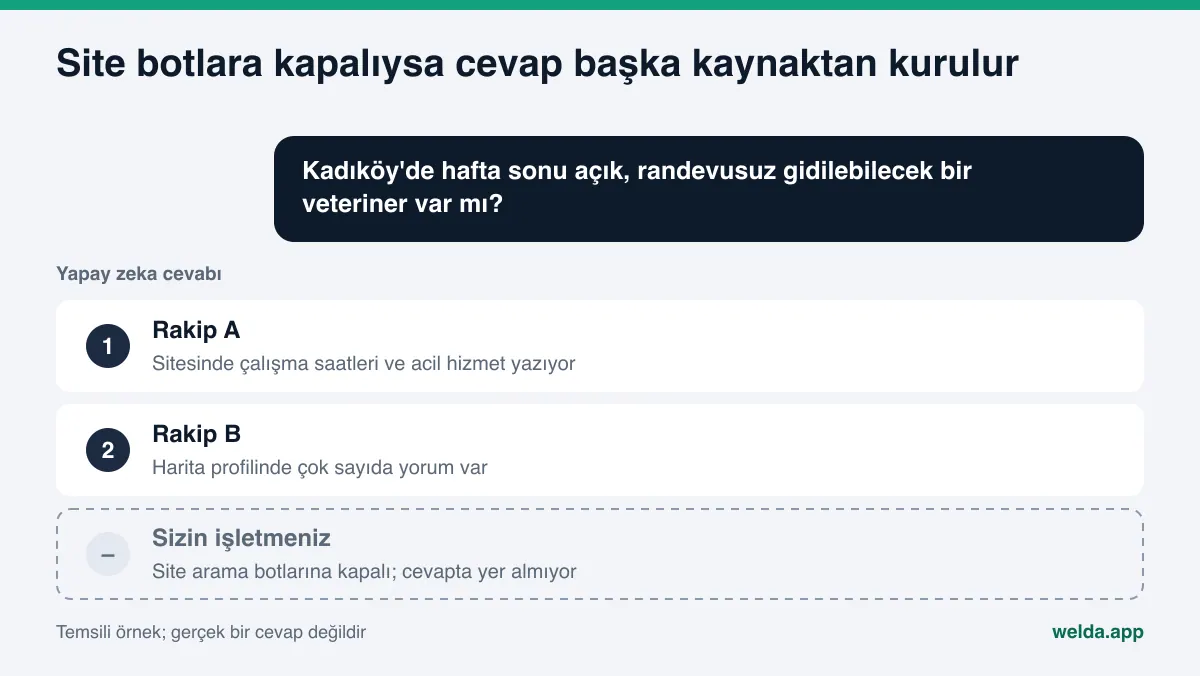
Bir müşteri ChatGPT'ye ya da Perplexity'ye "yakınımda hafta sonu açık bir veteriner" diye sorduğunda, araç çoğu zaman web'de arama yapar, birkaç sayfayı okur ve cevabını bu sayfalardan kurar. Okuyamadığı sayfayı kaynak olarak kullanamaz. Sitenizin robots.txt dosyası arama botuna "girme" diyorsa, yapay zeka sizi ancak başka sitelerin sizin hakkınızda yazdıkları kadarıyla bilir: harita profili, rehber siteleri, şikayet siteleri, forumlar.
Bu durumun can sıkıcı tarafı, çoğu işletmenin bunu bilerek yapmamasıdır. Engel genelde şu yollardan gelir:
- Site yapım aşamasında eklenen ve yayına geçince kaldırılmayan
Disallow: /satırı. - İçerik yönetim sistemindeki "arama motorlarının siteyi dizine eklemesini engelle" kutusunun işaretli kalması.
- Bir güvenlik eklentisinin ya da hazır bir şablonun "yapay zeka botlarını engelle" seçeneğini varsayılan olarak açması.
- Bir dönem "içeriğimiz eğitimde kullanılmasın" diye internetten kopyalanan uzun bir engel listesinin, eğitim botlarıyla birlikte arama botlarını da kapatması.
- Barındırma ya da CDN tarafında açılan bot korumasının robots.txt'den bağımsız olarak botları geri çevirmesi.
Sonuç aynıdır: siteniz insan ziyaretçiye açık görünür, ama yapay zeka aracının arama botu kapıda kalır. Sitenizdeki güncel fiyat aralığı, çalışma saatleri, hizmet listesi ve sık sorulan sorular cevaba hiç girmez. Bu yüzden yapay zeka görünürlüğü çalışmasında ilk bakılan şeylerden biri robots.txt dosyasıdır. İçerik ne kadar iyi olursa olsun, okunamıyorsa etkisi sınırlı kalır. Kendi sitenizin durumunu merak ediyorsanız ücretsiz site analizi bu kontrolü ilk adımlardan biri olarak yapar.
Hangi yapay zeka botları var, her biri ne yapar?
Bot adlarını tahminle değil, şirketlerin kendi belgelerinden okumak gerekir; adlar ve görevler zaman içinde değişebilir. Aşağıdaki tablo Kasım 2026 itibarıyla resmî belgelerde yazanları özetler. OpenAI botlarını OpenAI'ın bot belgesinde, Perplexity botlarını Perplexity'nin bot sayfasında, Google'ın belirteçlerini Google'ın tarayıcı listesinde bulabilirsiniz.
| Bot adı (User-agent) | Şirket | Ne için gelir | robots.txt ile ilişkisi |
|---|---|---|---|
OAI-SearchBot | OpenAI | ChatGPT'nin arama özelliklerinde siteleri göstermek | Uyar. Engellerseniz ChatGPT arama cevaplarında atıf olarak gösterilmezsiniz. |
GPTBot | OpenAI | Temel modellerin eğitiminde kullanılabilecek içeriği toplamak | Uyar. Engellemek içeriğin eğitimde kullanılmaması isteğidir; arama görünürlüğünü belirlemez. |
ChatGPT-User | OpenAI | Bir kullanıcı sorduğunda sayfayı o an açmak | Kullanıcı başlattığı için robots.txt kuralları uygulanmayabilir. |
PerplexityBot | Perplexity | Perplexity arama sonuçlarında siteleri göstermek ve bağlantı vermek | Belgede sitelerin bu bota izin vermesi öneriliyor; eğitim için kullanılmadığı yazıyor. |
Perplexity-User | Perplexity | Kullanıcının sorusu için sayfayı getirmek | Belgeye göre genelde robots.txt kurallarını dikkate almaz. |
Google-Extended | Ayrı bir tarayıcı değil, bir belirteç: içeriğin Gemini eğitiminde ve bazı Gemini ürünlerinde kullanımı | Google'a göre Google Arama'ya dahil olmayı ve sıralamayı etkilemez. |
Bu tablodan çıkan en önemli ders şudur: aynı şirketin botları ayrı işler yapar ve ayrı ayrı yönetilir. OpenAI belgesi, bir sitenin arama için OAI-SearchBot'a izin verip eğitim için GPTBot'u engelleyebileceğini açıkça yazar. Yani "içeriğim eğitimde kullanılmasın" kararı, "ChatGPT aramasında görünmeyeyim" anlamına gelmek zorunda değildir. OpenAI ayrıca robots.txt değişikliğinin arama sonuçlarına yansımasının yaklaşık 24 saat sürebileceğini belirtir.
Google tarafında durum biraz farklıdır. Google'ın yapay zeka özellikleri belgesine göre AI Bakışı ve AI Modu'nda yer almak için ek bir gereklilik yoktur: sayfanın Google Arama'da dizine eklenmiş ve snippet ile gösterilmeye uygun olması gerekir. Bu da Googlebot'un sayfayı tarayabilmesi demektir. Yani Google'ın yapay zeka cevaplarında görünmek için ayrı bir yapay zeka botuna değil, sıradan Googlebot erişimine bakılır.
Eğitim botu ile arama botu arasındaki fark: hangi engel neye mal olur?
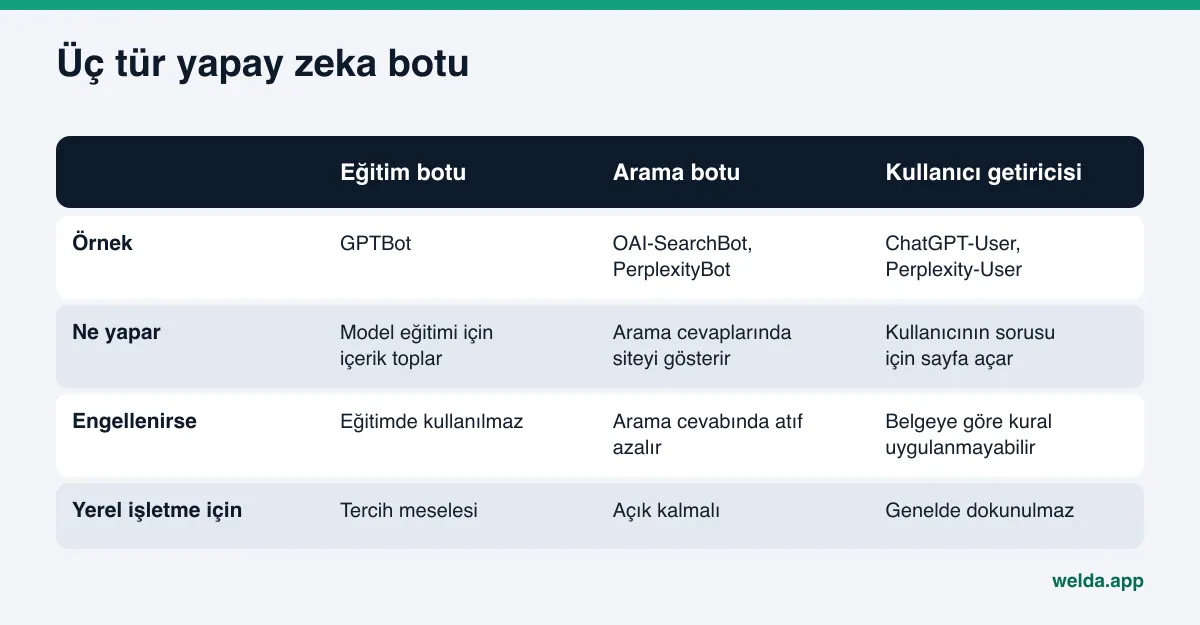
İşletmelerin en sık yaptığı hata, bütün yapay zeka botlarını tek bir kategori gibi görmektir. Oysa üç ayrı bot türü vardır ve her birini engellemenin sonucu farklıdır.
Eğitim botları (ör. GPTBot) içerik toplayıp modellerin gelecekteki sürümlerinin eğitiminde kullanılabilecek veriye ekler. Bunları engellemek bir tercih meselesidir. Bazı işletmeler özgün içeriklerinin eğitim verisine girmesini istemez; bu meşru bir karardır. Ancak bir yerel işletme için, çalışma saatleri ve hizmet listesi gibi zaten kamuya açık bilgilerin eğitimden uzak tutulması pek bir şey kazandırmaz. Karar sizindir; önemli olan bilerek vermektir.
Arama botları (ör. OAI-SearchBot, PerplexityBot) sitenizi o aracın arama cevaplarında kaynak olarak gösterebilmek için tarar. Bunları engellemek, yapay zeka görünürlüğü açısından doğrudan kayıptır: araç cevabı yine kurar, ama sizin sitenizden değil, başka kaynaklardan. Cevapta adınız geçse bile bağlantı sitenize değil, bir rehber sitesine gidebilir.
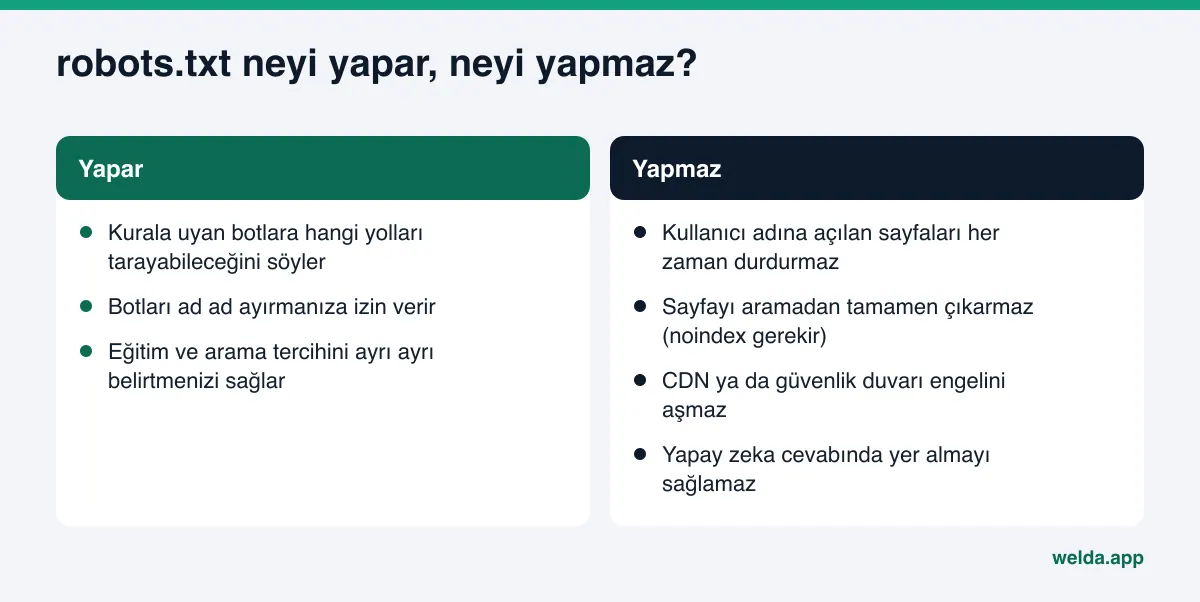
Kullanıcı adına sayfa getiren botlar (ör. ChatGPT-User, Perplexity-User) bir kişi sohbet içinde bir sayfayı açmak istediğinde gelir. Şirket belgelerine göre bu istekler kullanıcı başlattığı için robots.txt kuralları uygulanmayabilir. Bu botları robots.txt ile yönetmeye çalışmak çoğu zaman beklenen sonucu vermez; zaten çoğu işletmenin bunları engellemek için bir nedeni de yoktur.
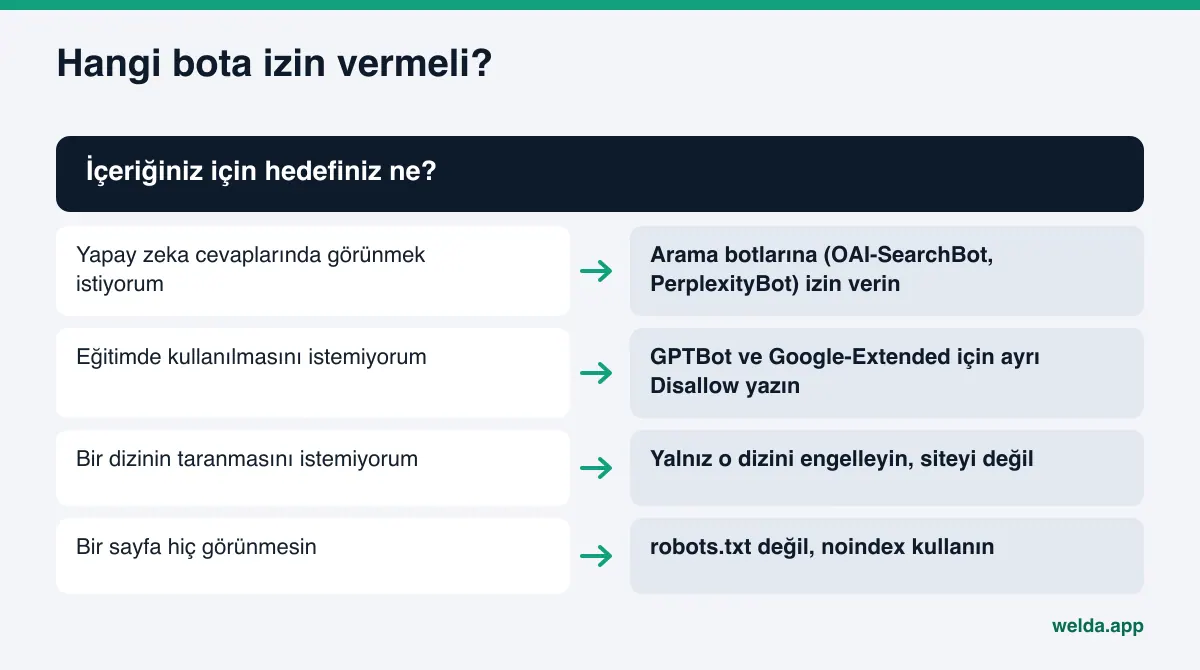
Kısaca: yapay zeka cevaplarında görünmek istiyorsanız arama botlarını açık tutun, eğitim botları için ayrı ve bilinçli bir satır yazın, kullanıcı getiricilerine dokunmayın. Gemini için not: Google belgesine göre Google-Extended belirteci içeriğin Gemini modellerinin eğitiminde ve Gemini uygulamalarındaki bazı kullanımlarda kullanılmasını yönetir, Google Arama'yı etkilemez. Bu belirteci kapatmayı düşünüyorsanız Gemini tarafındaki etkisini de hesaba katın.
robots.txt dosyanızı yapay zeka botları için adım adım kontrol edin
Bu kontrol teknik bilgi gerektirmez; bir tarayıcı ve on beş dakika yeter. Aşağıdaki adımları sırayla yapın.
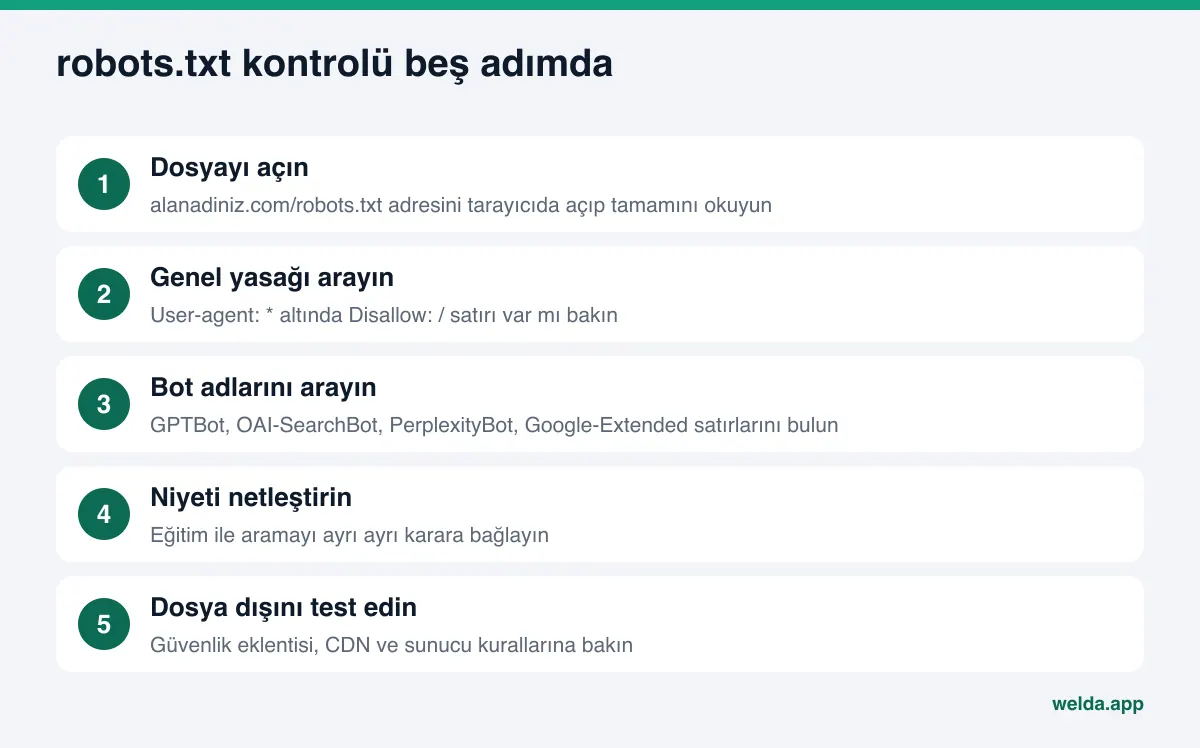
- Dosyayı açın. Tarayıcıya
alanadiniz.com/robots.txtyazın. Sayfa açılmıyorsa dosya yoktur; bu durumda botlar genelde her yeri tarayabilir kabul eder. Açılıyorsa tamamını okuyun, yalnız ilk satırlarını değil. - Genel yasağı arayın.
User-agent: *satırının altındaDisallow: /var mı? Varsa, ayrıca izin verilen botlar dışında bütün botlar bütün siteye kapalıdır. Bu satır genelde site yapım döneminden kalır. - Bot adlarını tek tek arayın. Dosyada
GPTBot,OAI-SearchBot,ChatGPT-User,PerplexityBot,Google-Extendedgeçiyor mu? Her birinin altında ne yazdığını not edin. - Yolları kontrol edin. Bütün site yerine belirli dizinler mi kapatılmış? Hizmet, fiyat ya da iletişim sayfalarınızın bulunduğu yol yanlışlıkla engellenmiş olabilir.
- Niyetinizi yazın. İki soruyu ayrı cevaplayın: içeriğiniz eğitimde kullanılabilir mi, yapay zeka aramasında görünmek istiyor musunuz? Dosyayı bu iki cevaba göre düzenleyin.
- Dosya dışındaki engellere bakın. Güvenlik eklentisi, CDN bot koruması, sunucu kuralları. Bunları aşağıda ayrı bölümde anlatıyoruz.
- Değişikliği kaydedip tekrar açın. Dosyayı güncelledikten sonra tarayıcıda yeniden açıp yeni hâlini görün. Eski hâl görünüyorsa önbellek temizliği gerekebilir.
Bu adımların sonunda elinizde iki şey olmalı: hangi botun hangi sayfaya girebildiğini gösteren bir not ve bu durumun sizin niyetinizle uyuşup uyuşmadığına dair net bir cevap. Daha geniş bir site kontrolü için GEO denetimi yazısında robots.txt'nin diğer kontrollerle birlikte nasıl sıralandığını anlattık.
Üç örnek robots.txt dosyası
Aşağıdaki örnekler yaygın üç niyeti karşılar. Kendi sitenize uyarlamadan önce mevcut dosyanızdaki diğer kuralları (yönetim paneli, sepet, arama sonuç sayfaları gibi) korumayı unutmayın. Bunlar örnektir; her site için doğru dosya, sitenin yapısına bağlıdır.
Örnek 1: Yapay zeka aramasında görünmek, eğitime de karşı olmamak. En sade hâli budur. Ayrı bir yapay zeka satırı yazmanız gerekmez:
User-agent: *
Disallow: /yonetim/

Sitemap: https://alanadiniz.com/sitemap.xml
Örnek 2: Aramada görünmek, ama eğitime izin vermemek. Eğitim botlarını adıyla engeller, arama botlarını açık bırakır:
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: *
Disallow: /yonetim/
Örnek 3: Yalnız bir bölümü kapatmak. Üyelere özel bir içerik alanınız varsa, bütün siteyi değil yalnız o dizini engelleyin:
User-agent: *
Disallow: /uye-alani/
Sık rastlanan hatalar da şunlar: User-agent adını yanlış yazmak (ör. "GPT-Bot"), aynı bot için çelişen iki blok bırakmak, dosyayı kök dizin yerine alt klasöre koymak ve bir sayfayı aramadan çıkarmak için robots.txt kullanmak. Son madde önemlidir: bir sayfanın aramada hiç görünmemesini istiyorsanız robots.txt değil, sayfaya noindex eklemek gerekir. robots.txt yalnız taramayı yönetir.
robots.txt dışında yapay zeka botlarını durduran engeller
robots.txt temiz olduğu hâlde arama botları sitenize giremeyebilir. Google'ın kendi belgesi de taramaya yalnız robots.txt'de değil, CDN ve barındırma altyapısında da izin verilmesini önerir. Bakılacak yerler şunlar:
- CDN bot koruması. Bazı CDN hizmetleri yapay zeka botlarını tek tıkla engelleyen seçenekler sunar. Bu seçenek robots.txt'den bağımsız çalışır; dosyanız "gir" dese bile bot sunucuya ulaşamaz.
- Güvenlik eklentileri. WordPress sitelerde güvenlik ya da hız eklentileri bilinmeyen botları geri çevirebilir. Eklentinin bot ayarlarına bakın. WordPress özelinde daha fazlası için WordPress sitesi için GEO yazısına göz atabilirsiniz.
- Sunucu kuralları. Barındırma firmasının güvenlik duvarı ya da
.htaccesskuralları belirli user-agent'ları engelleyebilir. - Yavaş ya da zaman aşımına düşen sayfalar. Bot sayfayı açmaya çalışır ama cevap gelmez. Bu konuyu site hızı ve yapay zeka botları yazısında ayrıca ele aldık.
- Sayfa düzeyinde etiketler.
noindexya danosnippetetiketleri, Google tarafında sayfanın arama ve yapay zeka özelliklerinde gösterilmesini sınırlar. - İçeriğin yalnız JavaScript ile yüklenmesi. Bot sayfaya girse bile, metin tarayıcıda sonradan oluşuyorsa okuyacak bir şey bulamayabilir.
Bu yüzden "robots.txt'im temiz" demek yeterli değildir. Asıl soru, arama botunun sayfanızı açıp metnini okuyup okuyamadığıdır. Bazı işletmeler bu konuda llms.txt dosyasını da sorar; onun neyi yapıp neyi yapmadığını llms.txt değerlendirmesinde anlattık. Kısaca, llms.txt robots.txt'nin yerini tutmaz.
Değişikliği yaptıktan sonra nasıl doğrularsınız?
robots.txt dosyasını düzenlemek işin yarısıdır. Öteki yarısı, botların gerçekten içeri girebildiğini görmektir. Bunun için üç basit yol vardır.
Dosyanın yayındaki hâline bakın. Düzenlediğiniz dosya ile tarayıcıda açılan dosya aynı olmayabilir. Bazı içerik yönetim sistemleri robots.txt'yi kendisi üretir; siz bir yerde değişiklik yaparken başka bir eklenti dosyayı ezebilir. Adresi gizli pencerede açıp yeni satırları görmeden işi bitmiş saymayın.
Sunucu kayıtlarına bakın. Barındırma panelinizde erişim kayıtları varsa, user-agent alanında OAI-SearchBot ya da PerplexityBot geçen istekleri arayın. Bu isteklere sunucunun verdiği cevap kodu önemlidir: 200 sayfanın açıldığını, 403 ya da 429 bir güvenlik katmanının botu geri çevirdiğini gösterir. Kayıtlara erişiminiz yoksa barındırma firmanızdan ya da web sorumlunuzdan bu kontrolü isteyebilirsiniz.
Önce ve sonra karşılaştırması yapın. Düzeltmeden önce birkaç müşteri sorusunu not edin ve yapay zeka araçlarının bu sorulara verdiği cevaplarda adınızın geçip geçmediğini kaydedin. Düzeltmeden birkaç hafta sonra aynı soruları tekrar sorun. Tek bir denemeye güvenmeyin; yapay zeka cevapları aynı soruda bile değişebilir. Bu yüzden aynı soruyu birkaç kez sormak ve sonuçları yan yana koymak daha güvenilir bir fikir verir.
Örnek bir senaryo düşünelim: örnek bir mobilya mağazasının sitesi yeniden yapılmış, ajans yayına alırken robots.txt'deki genel yasağı kaldırmayı unutmuş. Sitede yeni ürün grubu sayfaları, teslimat bilgileri ve sık sorulan sorular var, ama hiçbiri yapay zeka cevaplarında kaynak olarak görünmüyor. Satır kaldırıldıktan sonra yapılacak ilk iş, yukarıdaki üç kontrolü sırayla yapmak ve sonra içerik tarafına geçmektir.
Welda bu işi nasıl yapar?
Welda, işletmenin yapay zeka cevaplarında nerede göründüğünü ölçen ve eksikleri işletme adına tamamlayan bir yazılımdır. robots.txt konusu Welda'nın işinde iki yerde karşınıza çıkar: ilk teşhiste ve kaynak takibinde.
Ücretsiz site analizinde teşhis. Ücretsiz site analizi ana sayfanızı ve hizmetler, fiyatlar, hakkımızda, iletişim gibi birkaç iç sayfanızı okur. İlk kontrollerden biri, yapay zeka botlarının sitenize girip giremediğidir. Rapor, robots.txt dosyanızda ne gördüğünü, bunun neden önemli olduğunu ve nasıl düzeleceğini yazar. Aynı raporda hangi düzeltmenin skoru ne kadar artıracağını gösteren bir simülasyon da vardır; erişim düzeltmesini öteki işlerle yan yana görüp sırayı buna göre koyabilirsiniz. Analiz ayrıca müşterilerin sorabileceği beş soruyu web araması yapabilen bir yapay zeka asistanına sorar ve cevaplarda işletme adınızın geçip geçmediğine bakar. Bu tek seferlik bir ölçümdür; robots.txt'yi düzelttikten sonra etkiyi düzenli izlemek için yeterli değildir, ama başlangıç fotoğrafını verir.
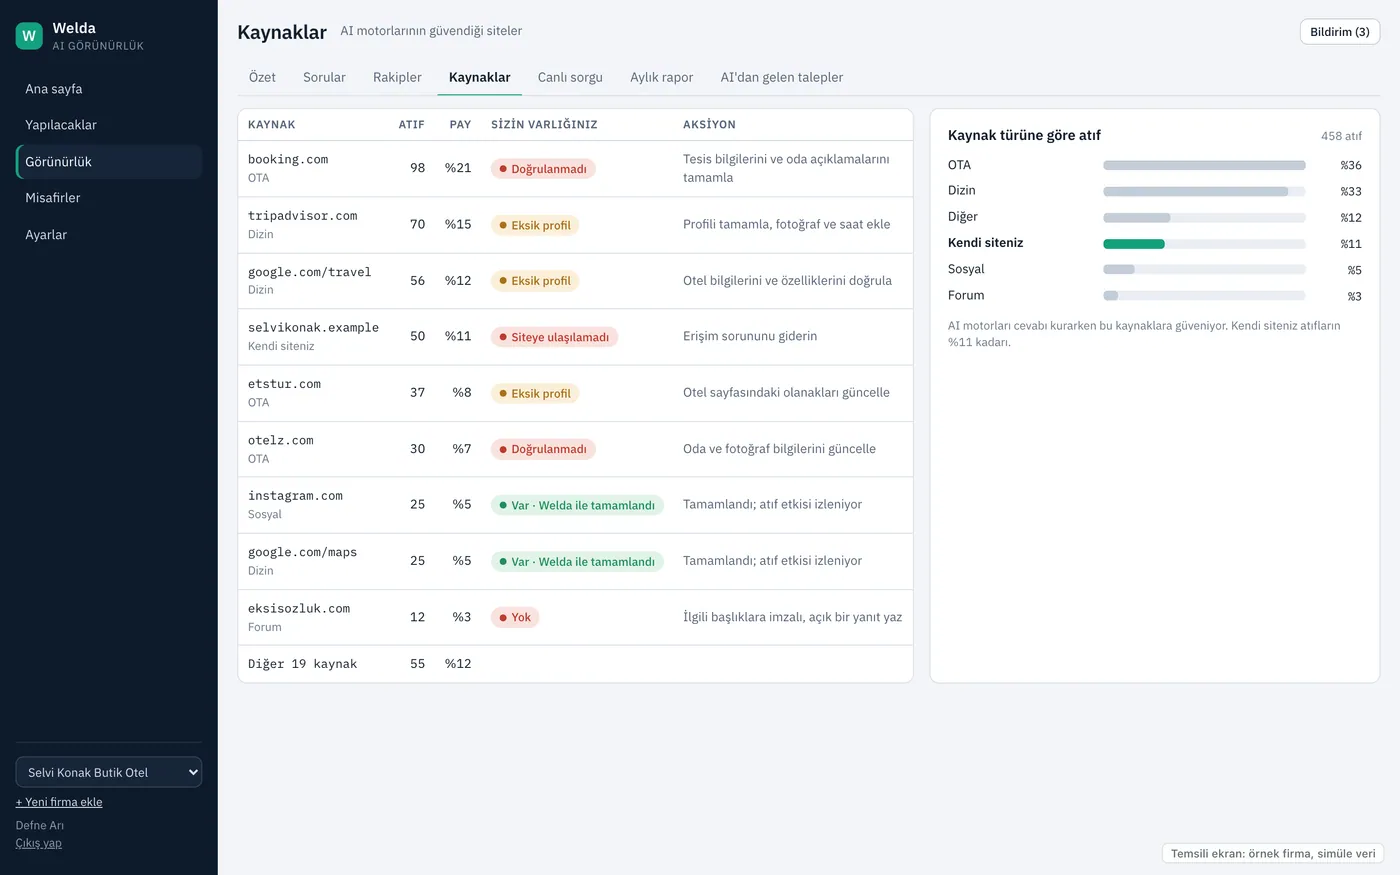
Panelde kaynak takibi. Welda panelindeki kaynaklar ekranı, yapay zeka motorlarının cevap kurarken hangi sitelere dayandığını ve sizin oradaki durumunuzu gösterir. Kendi siteniz de bu listede bir satırdır. Siteniz ulaşılamaz görünüyorsa, bu satırın karşısında bir erişim uyarısı ve "erişim sorununu giderin" gibi bir aksiyon durur. Bu ekranda vereceğiniz karar basittir: sitenizin kendisi mi kaynak olarak eksik, yoksa sorun rehber ve profil sitelerinde mi? Erişim sorunu varsa önce o çözülür, çünkü sitenize eklenecek her yeni içerik ancak okunabildiğinde işe yarar.
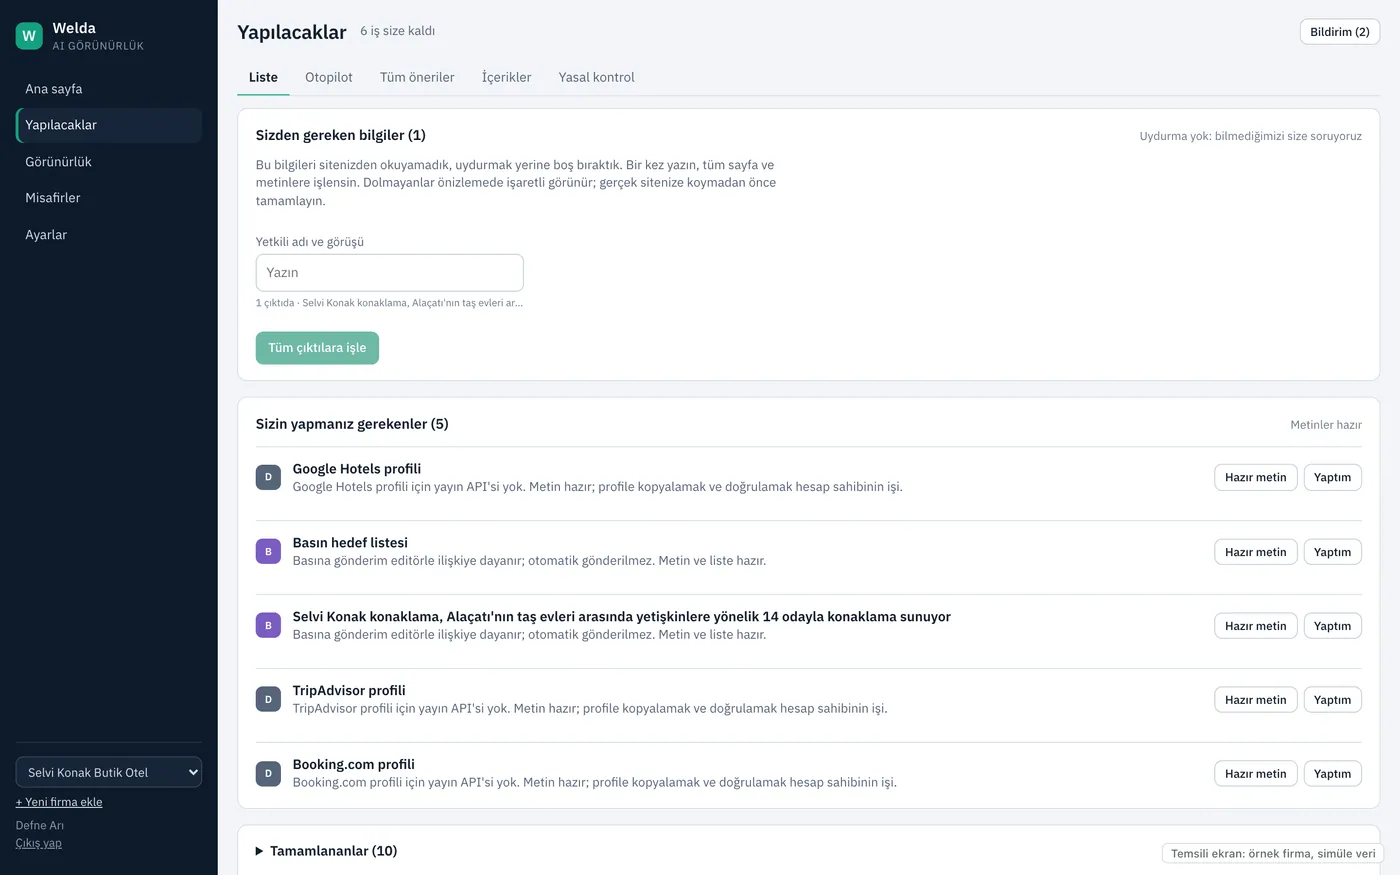
İşletmede kalan iş. robots.txt dosyası, CDN ayarı ya da güvenlik eklentisi sitenizin ve barındırma hesabınızın içindedir. Welda bu dosyaya kendisi dokunmaz; ne değişmesi gerektiğini yazar ve işi yapılacaklar listesine "elle yapılacak" olarak koyar. Listede hazır metin yanınızdadır: dosyaya eklenecek satırlar ya da web sorumlunuza iletilecek kısa açıklama. İşi yaptığınızda "yaptım" diye işaretlersiniz. WordPress sitelerde Welda ayrı bir Editör kullanıcısıyla bağlanıp içerikleri taslak olarak açabilir; robots.txt gibi sunucu ayarları ise sizde kalır.
Panel bugün erken erişimdedir ve sırayla açılmaktadır, ilk olarak Türkiye'deki işletmelerle. Dört motorlu düzenli ölçüm erken erişim sürecinde ekleniyor; paneldeki örnek ekranlar temsili veriyle gösterilir. Bugün herkesin kullanabildiği parça ücretsiz site analizidir. Fiyat erken erişim görüşmesinde konuşulur. Panelin tamamını AI görünürlük sayfasında görebilirsiniz.
Sınırlar: robots.txt ve Welda neyi garanti etmez?
robots.txt düzeltmesi bir ön koşuldur, sonuç değildir. Arama botuna kapıyı açmak, yapay zekanın sizi önereceği anlamına gelmez. Yapay zeka aracı sitenizi okuyabilir, ama cevabı yine içeriğin netliğine, işletme bilgilerinizin tutarlılığına, yorumlara ve başka kaynakların ne söylediğine göre kurar. Kapı açıldıktan sonra yeni içeriğin cevaplara yansıması genelde haftalar sürer.
Welda'nın bu konudaki sınırları da açıktır:
- Welda sıralama ya da "ChatGPT'de çıkma" garantisi vermez. Ücretsiz analiz sıralama ölçmez.
- Welda robots.txt dosyanızı, CDN ayarınızı ya da sunucu kurallarınızı sizin yerinize değiştirmez; ne yapılacağını yazar, uygulama sizde ya da web sorumlunuzda kalır.
- Welda bilmediği bilgiyi yazmaz. Bir dizinin neden kapalı olduğunu bilmiyorsa varsayım yapmaz, size sorar.
- Eğitim botlarına izin verip vermeme kararı sizin içerik politikanızdır. Welda bu kararı sizin yerinize vermez; yalnız arama görünürlüğüne etkisini gösterir.
- Kullanıcı adına sayfa getiren botların robots.txt'ye uyup uymadığı, ilgili şirketin politikasıdır. Welda bunu değiştiremez.
Bir de şunu hatırlatalım: robots.txt bir güvenlik aracı değildir. Gizli kalması gereken bir sayfa varsa onu robots.txt ile değil, parola ve erişim kontrolüyle korumak gerekir. Dosya herkese açıktır ve içinde listelediğiniz yollar da görünür.
Karar ve kontrol listesi: robots.txt yapay zeka botları için hazır mı?
Aşağıdaki tabloyu dosyanızı açıp satır satır doldurun. Her satırda "beklenen" sütunu, yapay zeka cevaplarında görünmek isteyen bir yerel işletme için olağan durumu gösterir.
| Kontrol | Beklenen | Sorun varsa |
|---|---|---|
User-agent: * altında Disallow: / | Yok | Satırı kaldırın ya da yalnız gereken dizinlere daraltın |
OAI-SearchBot engeli | Yok | Engeli kaldırın; ChatGPT aramasında atıf için gerekir |
PerplexityBot engeli | Yok | Engeli kaldırın; Perplexity cevaplarında bağlantı için gerekir |
| Googlebot erişimi | Açık | AI Bakışı ve AI Modu için sayfanın dizinde olması gerekir |
GPTBot ve Google-Extended | Bilinçli karar | Eğitim tercihinizi yazılı hâle getirin |
| Hizmet, fiyat, iletişim sayfaları | Taranabilir | Bu yolları kapatan satırı düzeltin |
| CDN ve güvenlik eklentisi | Arama botlarına açık | Bot koruma ayarını gözden geçirin |
| Sitemap satırı | Var | Site haritası adresini ekleyin |
Tabloda iki ya da daha fazla "sorun var" satırı çıkıyorsa, içerik ya da başlık çalışmasına başlamadan önce erişimi düzeltin. Başlık ve açıklama tarafını başlık ve meta açıklama yapay zeka çağında yazısında ele aldık; ama sıra önce erişimdedir.
Sık sorulan sorular
robots.txt dosyam yoksa yapay zeka botları siteme girebilir mi?
Genelde evet. robots.txt olmadığında botlar siteyi taranabilir kabul eder. Yine de bir dosya oluşturup site haritası adresinizi eklemek ve niyetinizi açıkça yazmak iyi bir uygulamadır.
GPTBot'u engellersem ChatGPT'de görünmez miyim?
OpenAI belgesine göre hayır, ikisi ayrı ayarlardır. GPTBot eğitim içindir. ChatGPT arama cevaplarında görünmek için OAI-SearchBot'a izin verilmesi gerekir. GPTBot'u engelleyip OAI-SearchBot'u açık bırakabilirsiniz.
Google-Extended'ı engellemek Google AI Bakışı'ndan çıkarır mı?
Google'ın belgesine göre Google-Extended, Google Arama'ya dahil olmayı ve sıralamayı etkilemez. AI Bakışı ve AI Modu için sayfanın Google Arama'da dizine eklenmiş ve snippet ile gösterilebilir olması gerekir; bu Googlebot erişimine bağlıdır. Google-Extended ise Gemini tarafındaki bazı kullanımları yönetir.
robots.txt değişikliği ne kadar sürede etkili olur?
Botun dosyayı yeniden okumasına bağlıdır. OpenAI, arama sonuçlarına yansımanın yaklaşık 24 saat sürebileceğini yazar. Ancak erişimin açılması ile yapay zeka cevaplarında görünmeye başlamak ayrı şeylerdir; ikincisi genelde haftalar alır.
Bütün yapay zeka botlarını engellemek güvenli bir seçim mi?
Hukuki ya da içerik politikası açısından sizin kararınızdır. Ancak arama botlarını da kapsayan bir engel, yapay zeka cevaplarında sitenizin kaynak olarak kullanılmasını büyük ölçüde engeller. Görünürlük istiyorsanız eğitim ve arama botlarını ayrı ele almanızı öneririz.
Welda robots.txt dosyamı kendisi düzeltir mi?
Hayır. Welda sorunu tespit eder, ne değişmesi gerektiğini ve dosyaya eklenecek satırları hazır metin olarak verir. Dosyayı ya da sunucu ayarını değiştirmek size veya web sorumlunuza kalır.
Sitenizin yapay zeka botlarına açık olup olmadığını öğrenin
robots.txt, yapay zeka görünürlüğünde en ucuz ve en hızlı düzeltilebilen konulardan biridir; ama gözden kaçtığında öteki bütün çalışmaların etkisini sınırlar. Kendi dosyanızı yukarıdaki adımlarla kontrol edebilirsiniz. Erişimi, başlık ve açıklamayı, işletme bilgilerini ve sık sorulan soruları tek raporda görmek isterseniz ücretsiz site analizini başlatın. Her site için bir kez ücretsizdir; e-posta ve telefon doğrulanır, sonuç bağlantısı e-postanıza gelir ve 14 gün açık kalır.