Wie funktioniert eine Logfile-Analyse für KI-Bots, und was erfahren Sie daraus? Das Zugriffsprotokoll Ihres Webservers hält jede Anfrage mit User-Agent und IP-Adresse fest. Wenn Sie es nach Namen wie GPTBot, OAI-SearchBot, ChatGPT-User oder PerplexityBot filtern und die IP-Adressen mit den Listen der Anbieter abgleichen, sehen Sie, ob KI-Crawler Ihre Website erreichen und wo sie hängen bleiben. Ob Ihr Unternehmen in KI-Antworten genannt wird, verrät das Logfile nicht. Das ist eine eigene Messung.
Dieser Beitrag erklärt die Logfile-Analyse für KI-Bots Schritt für Schritt: welcher Bot was tut, wo Sie Ihre Logfiles finden, wie Sie Statuscodes lesen und wo die Aussagekraft von Serverprotokollen endet. Das klingt nach Technik, das Ergebnis ist aber eine unternehmerische Entscheidung. Für KI-Sichtbarkeit, also GEO (Generative Engine Optimization), müssen Bots Ihre Seiten zuerst einmal lesen können. Im englischsprachigen Raum heißt dieselbe Arbeit oft AEO (Answer Engine Optimization). Wenn Sie schnell sehen möchten, wie Ihre Website heute aus Sicht der KI wirkt, prüft die kostenlose Website-Analyse unter anderem, ob Ihre robots.txt KI-Bots hereinlässt und wie gut Ihre wichtigsten Seiten lesbar sind.
Warum ist die Logfile-Analyse für KI-Bots wichtig?
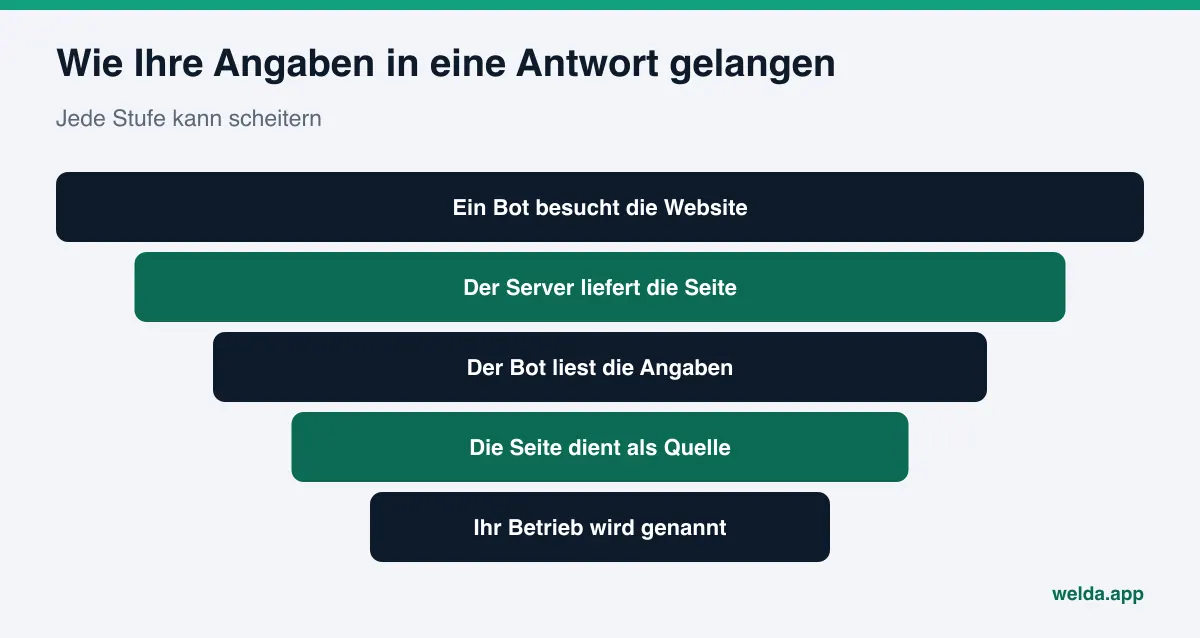
Wenn ChatGPT, Gemini, Perplexity oder die KI-Übersichten von Google eine Frage wie "Zahnarzt mit Angstpatienten-Erfahrung in Graz" beantworten, lernen sie Unternehmen auf zwei Wegen kennen. Der eine sind Seiten, die vorher gecrawlt und indexiert wurden. Der andere ist ein Live-Abruf, ausgelöst in dem Moment, in dem jemand fragt. Beide Wege hängen am selben Punkt: Ein Bot fordert eine Seite an, und Ihr Server antwortet. Verweigert der Server die Auslieferung, liefert er einen Fehler oder schickt er den Bot im Kreis, kommen die Informationen Ihrer Website nie in der Antwort an.
Den meisten Betrieben fällt das nicht auf. Im Browser lädt die Seite einwandfrei. Gleichzeitig weist eine Firewall-Regel, ein Plugin gegen Bots oder eine vor Jahren eingetragene Zeile in der robots.txt die KI-Crawler still ab. Sichtbar wird das nur im Zugriffsprotokoll: Dort sehen Sie, dass der Bot kommt und statt der Seite einen 403 oder 503 erhält.
Logfiles helfen außerdem beim Priorisieren. Wenn KI-Crawler vor allem eine alte Aktionsseite aufrufen und Ihre Leistungsseiten kaum, lohnt ein Blick auf interne Verlinkung und Sitemap. Und Logfiles zeigen nutzerausgelöste Abrufe. Ein Eintrag von ChatGPT-User oder Perplexity-User bedeutet, dass jemand eine Frage gestellt hat und der Assistent dafür Ihre Seite geöffnet hat. Das ist ein indirekter Hinweis, dass Ihre Website als Quelle in Betracht gezogen wird. Indirekt, weil das Öffnen einer Seite noch keine Nennung in der Antwort ist.
Welche KI-Crawler erscheinen im Server-Logfile?
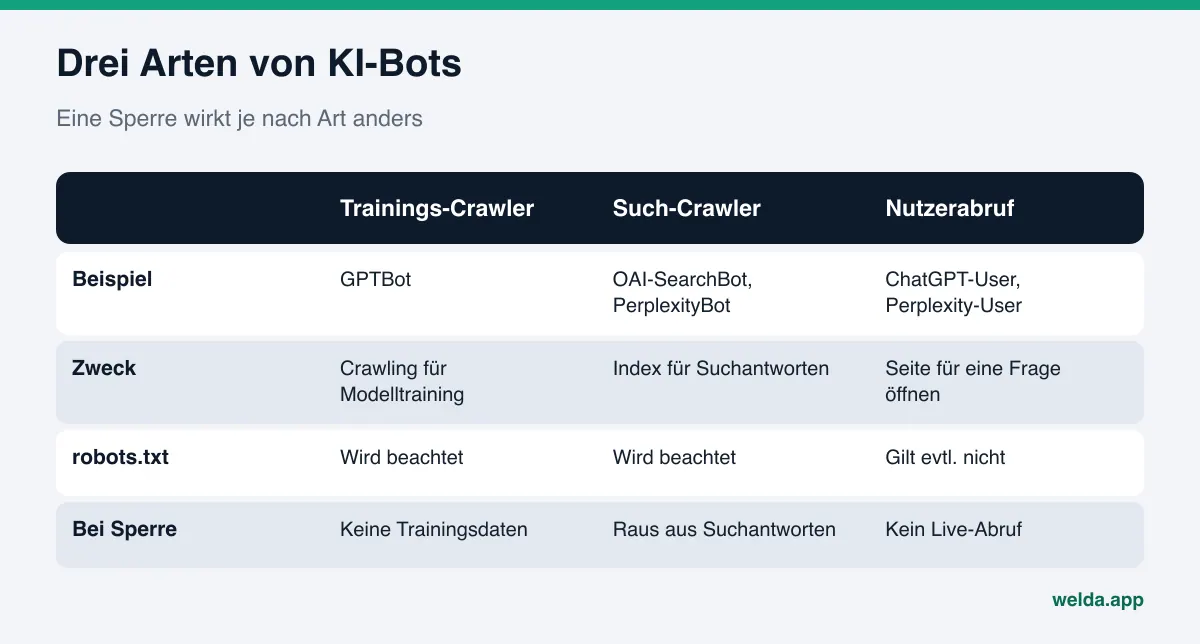
KI-Anbieter betreiben drei Arten von Bots. Die Unterscheidung ist wichtig, weil das Sperren jeweils andere Folgen hat. Die folgenden Angaben stammen aus den Dokumentationen der Anbieter, Stand November 2026. OpenAI beschreibt seine Crawler auf der offiziellen Bot-Seite, Perplexity seine in einem eigenen Leitfaden.
| Name im Logfile | Anbieter | Aufgabe | robots.txt |
|---|---|---|---|
| GPTBot | OpenAI | Crawlt Inhalte, die für das Modelltraining genutzt werden können | Wird beachtet; Sperre bedeutet Widerspruch gegen Training |
| OAI-SearchBot | OpenAI | Crawlt, um Websites in der ChatGPT-Suche anzuzeigen | Wird beachtet; gesperrte Seiten erscheinen nicht in Suchantworten |
| ChatGPT-User | OpenAI | Öffnet eine Seite, wenn eine Nutzerfrage es erfordert | Gilt möglicherweise nicht, da vom Nutzer ausgelöst |
| PerplexityBot | Perplexity | Crawlt, um Websites in Perplexity-Ergebnissen anzuzeigen und zu verlinken | Wird beachtet |
| Perplexity-User | Perplexity | Ruft eine Seite ab, um eine Nutzerfrage zu beantworten | Wird in der Regel ignoriert |
| Googlebot | Crawlt für den Google-Suchindex | Wird beachtet |
Bei Google gibt es eine Besonderheit. Laut der Crawler-Dokumentation von Google ist Google-Extended kein eigener Crawler, sondern ein Steuerungs-Token für die robots.txt ohne eigenen User-Agent. Es legt fest, ob von Google gecrawlte Inhalte für das Training von Gemini-Modellen und zur Fundierung von Antworten in Gemini-Apps genutzt werden dürfen; auf Ihr Erscheinen in der Google-Suche hat es keinen Einfluss. Wer im Logfile nach "Google-Extended" sucht, findet also nichts. Auf Google-Seite ist der relevante Eintrag Googlebot.
Eine Logzeile sieht ungefähr so aus (die IP-Adresse ist ein Dokumentationsbeispiel):
203.0.113.10 - - [12/Nov/2026:09:14:02 +0100] "GET /leistungen HTTP/1.1" 200 18432 "-" "Mozilla/5.0 ... compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot"
Fünf Felder zählen: die anfragende IP, Datum und Uhrzeit, die aufgerufene Adresse, der Statuscode (hier 200, also erfolgreich) und der User-Agent. KI-Bots zu finden heißt vor allem, das letzte Feld zu filtern. Der User-Agent allein beweist aber nichts, denn er lässt sich beliebig fälschen.
Wo finden Sie Ihre Zugriffsprotokolle?
Der Weg zum Logfile hängt davon ab, wo Ihre Website liegt. Typisch sind drei Situationen.
- Webhosting-Paket: Im Kundenbereich Ihres Hosters gibt es meist einen Bereich wie "Zugriffsprotokolle", "Logfiles" oder "Access-Logs". Dort laden Sie Tages- oder Monatsdateien herunter. Manche Hoster speichern Protokolle nur wenige Tage oder nur anonymisiert, deshalb lohnt ein fester Rhythmus.
- Eigener Server: Die Webserver-Software schreibt das Zugriffsprotokoll in eine Datei auf dem Server. Wer den Server betreut, weiß, wo sie liegt und wie lange sie aufbewahrt wird.
- Vorgeschaltetes CDN oder Sicherheitsdienst: Anfragen landen zuerst dort. Wird ein Bot auf dieser Ebene blockiert, erreicht er Ihren Server nie und taucht im Server-Logfile nicht auf. Dann brauchen Sie zusätzlich die Protokolle dieser Ebene.
Der dritte Fall wird am häufigsten übersehen. Sehen Sie überhaupt keinen GPTBot oder PerplexityBot, kann es sein, dass die Bots kommen, aber vor Ihrem Server gestoppt werden. Klären Sie den Weg der Anfragen, bevor Sie aus einem leeren Logfile Schlüsse ziehen.
Ein wichtiger Hinweis für den DACH-Raum: Zugriffsprotokolle enthalten IP-Adressen, und IP-Adressen können nach DSGVO als personenbezogene Daten gelten. Bevor Sie Logfiles an eine Agentur weitergeben oder in ein Tool hochladen, prüfen Sie Speicherdauer, Rechtsgrundlage und gegebenenfalls einen Auftragsverarbeitungsvertrag. Wo möglich, geben Sie nur die Bot-Zeilen weiter oder kürzen die IP-Adressen von Besuchern. Dies ist keine Rechtsberatung.
Schritt für Schritt: Logfile-Analyse für KI-Bots
Die folgende Reihenfolge ist so geschrieben, dass auch ein Betrieb ohne eigene IT sie mit Hilfe eines Entwicklers oder des Hoster-Supports umsetzen kann. Der erste Durchgang dauert ein bis zwei Stunden, danach geht es deutlich schneller.
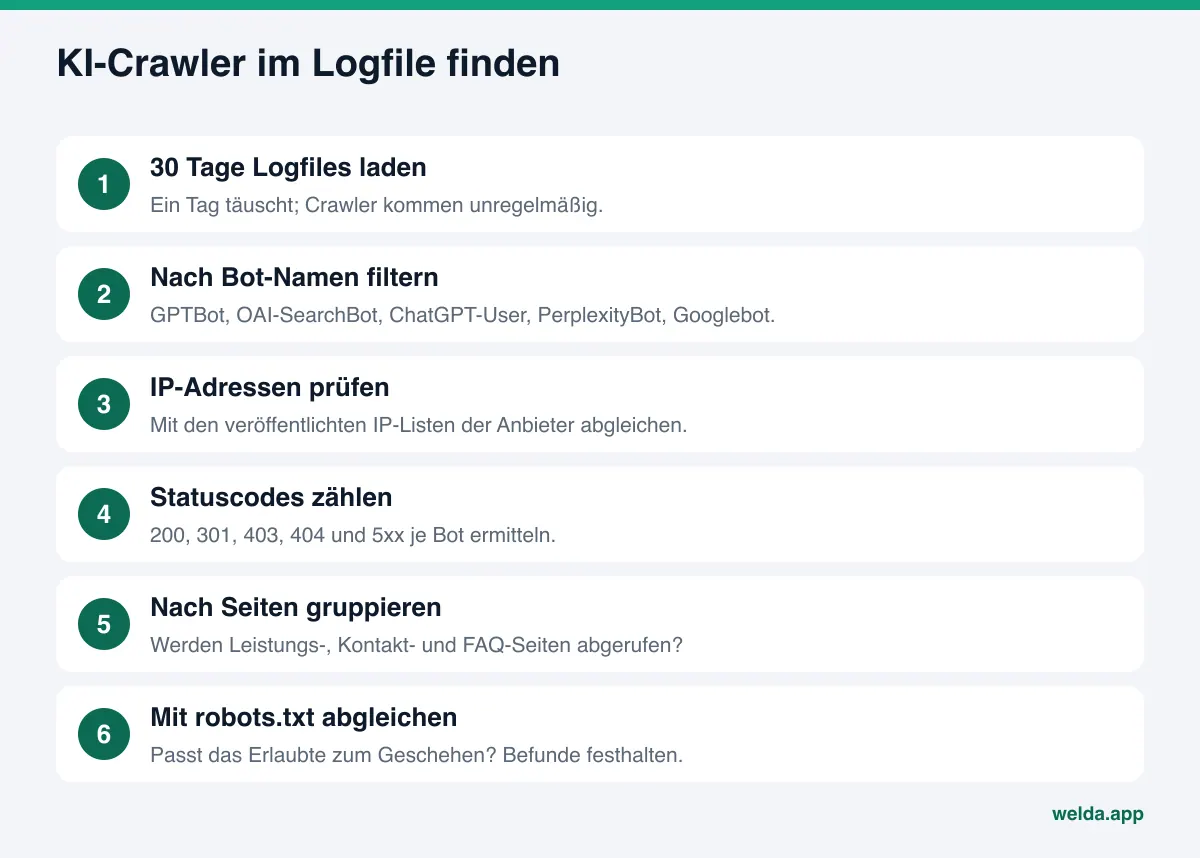
- Logfiles der letzten 30 Tage herunterladen. Ein einzelner Tag täuscht; Crawler kommen unregelmäßig. Ein Monat ergibt ein brauchbares Bild.
- Nach Bot-Namen filtern. Suchen Sie nach
GPTBot,OAI-SearchBot,ChatGPT-User,PerplexityBot,Perplexity-UserundGooglebot. Auf der Kommandozeile etwa:grep -E "GPTBot|OAI-SearchBot|ChatGPT-User|PerplexityBot|Perplexity-User" access.log - IP-Adressen prüfen. OpenAI und Perplexity veröffentlichen die IP-Bereiche ihrer Bots als JSON-Dateien. Eine Anfrage, die sich als OAI-SearchBot ausgibt, aber von einer IP außerhalb dieser Liste kommt, ist sehr wahrscheinlich gefälscht. Für Googlebot nutzen Sie das von Google beschriebene Prüfverfahren.
- Statuscodes zählen. Ermitteln Sie je Bot, wie viele Anfragen 200 (erfolgreich), 301 oder 302 (Weiterleitung), 403 (verboten), 404 (nicht gefunden) und 5xx (Serverfehler) erhalten haben. Hier liegen die eigentlichen Befunde.
- Nach Seiten gruppieren. Welche Adressen rufen die Bots auf? Sind Startseite, Leistungsseiten, Kontakt und FAQ darunter?
- Mit der robots.txt abgleichen. Vielleicht haben Sie einen Bot gesperrt, den Sie eigentlich zulassen wollten. Oder ein Bot, den Sie für gesperrt hielten, kommt weiterhin.
- Ergebnisse festhalten. Welcher Bot, welches Problem, wer behebt es. Im nächsten Monat wiederholen Sie dieselben Schritte und vergleichen.
Schauen Sie sich dabei die nutzerausgelösten Abrufe gesondert an. Seiten, die ChatGPT-User oder Perplexity-User geöffnet haben, wurden für echte Fragen herangezogen. Laden sie fehlerfrei, ist der Inhalt aktuell? Zeigt eine solche Seite noch die Preise des Vorjahres oder einen geschlossenen Standort, kann genau diese veraltete Angabe in die Antwort wandern. Wie Sie solche Seiten aktuell halten, beschreibt der Beitrag zur Content-Aktualität für die KI-Suche.
Was bedeuten die Statuscodes im Logfile?
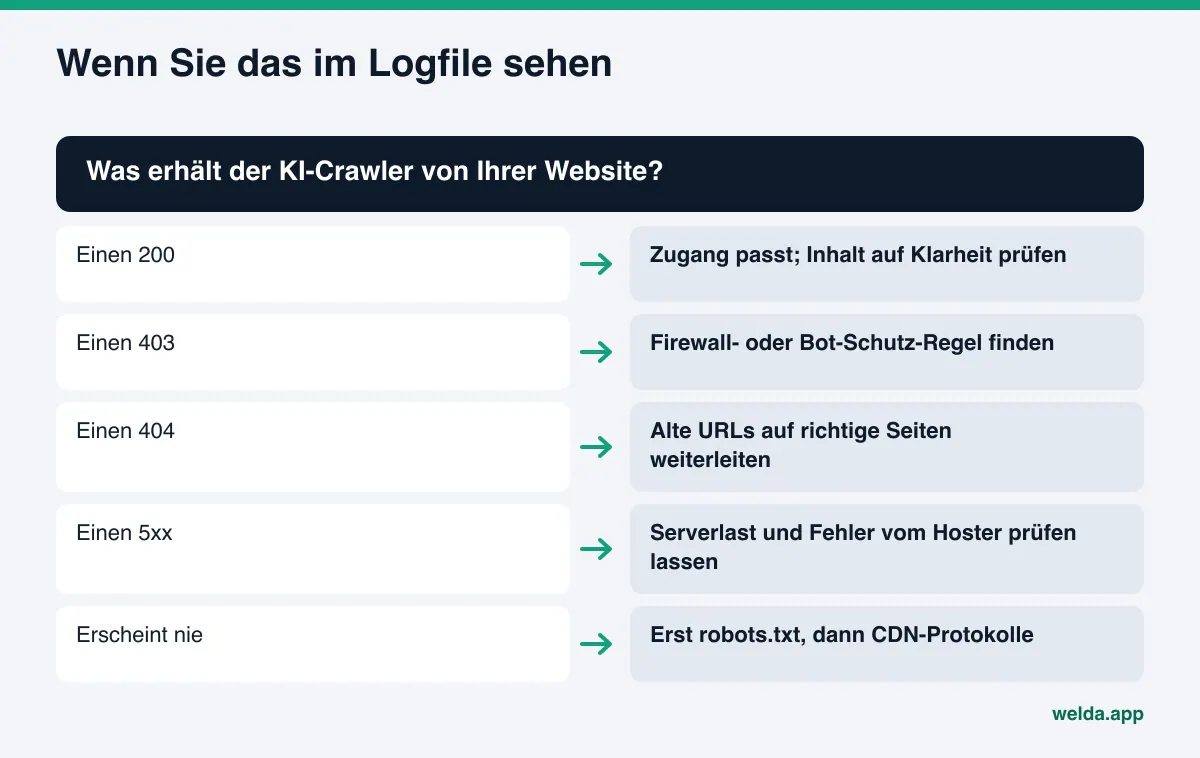
Die Bot-Zeilen zu finden ist der leichte Teil. Die Arbeit liegt in der Deutung. Derselbe Eintrag kann auf verschiedenen Websites Verschiedenes bedeuten, doch die folgende Tabelle zeigt in den meisten Fällen die richtige Richtung.
| Was Sie sehen | Wahrscheinliche Ursache | Was zu tun ist |
|---|---|---|
| Bot kommt, erhält 200 | Kein Zugriffsproblem | Weiter zum Inhalt: Sind die Angaben klar und aktuell? |
| Bot kommt, erhält 403 | Firewall, Bot-Schutz-Plugin oder Serverregel | Regel finden; ungewollte Sperre aufheben |
| Bot kommt, erhält 404 | Alte oder falsche URLs, defekte interne Links | Dauerhafte Weiterleitung auf die richtige Seite |
| Bot kommt, erhält 5xx | Serverlast, Zeitüberschreitung, Anwendungsfehler | Hoster oder Entwickler prüfen lassen |
| Lange Weiterleitungsketten | Mehrere 301 oder 302 hintereinander | Auf eine einzige Weiterleitung kürzen |
| Bot erscheint nie | Sperre in robots.txt, Sperre im CDN oder Bot war noch nicht da | Erst robots.txt, dann CDN- oder Sicherheitsprotokolle prüfen |
Die letzte Zeile sorgt am häufigsten für Verwirrung. Ein fehlender Bot ist nicht immer ein Problem; kleine und neue Websites werden selten gecrawlt. Sperrt aber die robots.txt oder eine Sicherheitsregel, wird der Bot nie erscheinen. Unterscheiden lässt sich das, indem Sie zuerst jede Sperre ausschließen und dann einige Wochen abwarten.
Dazu kommt ein Inhaltsproblem, das kein Logfile meldet. Ein Bot kann einen 200 erhalten und trotzdem nichts Wesentliches sehen, wenn die wichtigen Angaben erst per Skript nach dem Laden der Seite erscheinen. Nicht für jeden KI-Crawler ist dokumentiert, ob er Skripte ausführt. Sicher ist es, Leistungen, Adresse, Telefonnummer, Öffnungszeiten und FAQ im einfachen HTML der Seite zu halten.
Beispiel: ein Monat Logfiles einer Zahnarztpraxis
Das folgende Szenario ist ein Beispiel und beschreibt keinen realen Betrieb. Es zeigt, wie die Schritte zusammenspielen.
Eine Beispiel-Zahnarztpraxis in einer österreichischen Landeshauptstadt lädt die Zugriffsprotokolle der letzten 30 Tage herunter und filtert nach KI-Bots. Googlebot und PerplexityBot kommen regelmäßig und erhalten 200. Auch OAI-SearchBot kommt, ein Teil seiner Anfragen endet aber mit 403. GPTBot taucht gar nicht auf. ChatGPT-User erscheint einige Male und öffnet jedes Mal die Seite zu Implantaten.
Die Praxis geht der Reihe nach vor. In der robots.txt steht eine Sperre für GPTBot, die eine frühere Agentur eingetragen hat. Die Praxis möchte nicht, dass ihre Inhalte für Modelltraining genutzt werden, und lässt die Sperre deshalb bewusst stehen. Die 403-Antworten für OAI-SearchBot haben eine andere Ursache: Ein Sicherheits-Plugin bremst Besucher aus, die viele Anfragen in kurzer Zeit stellen, und der Bot fällt unter diese Regel. Die Praxis bittet ihren Webbetreuer, die Regel für Such-Crawler zu lockern.
Der letzte Befund betrifft den Inhalt. Die Implantatseite, die ChatGPT-User wiederholt aufruft, nennt noch das Team vom Vorjahr und eine Sprechstunde, die es nicht mehr gibt. Fragt jemand ChatGPT nach Implantaten in der Stadt, könnte genau diese Angabe gelesen werden. Die Praxis aktualisiert die Seite und prüft dabei auch, ob die Formulierungen den Werberegeln für Heilberufe entsprechen.
Einen Monat später zeigt dieselbe Prüfung: OAI-SearchBot erhält jetzt 200. Das heißt noch nicht, dass die Praxis in ChatGPT-Antworten genannt wird. Dafür muss man die Antworten auf Fragen wie "Zahnarzt für Implantate mit Abendsprechstunde" ansehen. Das Logfile hat seine Aufgabe erfüllt: Es hat die Sperre an der Tür gefunden.
Ein echtes Beispiel: 17 Tage Logfiles unserer eigenen Testseite
Das Praxisbeispiel oben ist erfunden. Daneben stellen wir eine echte Zählung. Wir haben die Server-Logfiles der eigenen Testseite von Welda, einer einzelnen kleinen Unternehmenswebsite, für die 17 Tage vom 31. Oktober bis 16. November 2026 nach Art des KI-Crawlers sortiert.
| Art des Eintrags | Anzahl in 17 Tagen | Was es bedeutet |
|---|---|---|
| Crawling für Modelltraining | 77.955 Anfragen | Bots, die Inhalte für das Modelltraining lesen; mit Abstand die größte Gruppe |
| Crawling für den Suchindex | 7.075 Anfragen | Bots, die die Website für die Suchfunktion eines Assistenten indexieren |
| Abruf im Moment der Frage | 166 Anfragen | Jemand hat einen Assistenten gefragt, und dieser hat die Seite beim Antworten geöffnet |
| Personen, die auf einen Link in der Antwort geklickt haben | 8 Besucher | Der Teil, der in der Webanalyse als "Besuche aus KI" erscheint |
Im selben Zeitraum sahen wir außerdem 24 Anfragen, die den Namen eines Assistenten nutzten und versteckte Dateinamen ausprobierten. Das waren Sicherheitsscans, keine echten Fragen, und sie zeigen konkret, warum man dem User-Agent allein nicht trauen sollte.
Der einzige ehrliche Schluss aus diesen Zahlen lautet: KI-Crawler lesen eine Website um ein Vielfaches häufiger, als Menschen von dort auf die Website klicken. Deshalb misst die Zahl "Besuche aus KI" in Ihrer Webanalyse allein keine Sichtbarkeit. Es handelt sich um eine einzelne Website über 17 Tage; bei Ihnen können die Verhältnisse anders aussehen, und wir verallgemeinern diese Zahlen nicht.
Was Server-Logfiles nicht zeigen
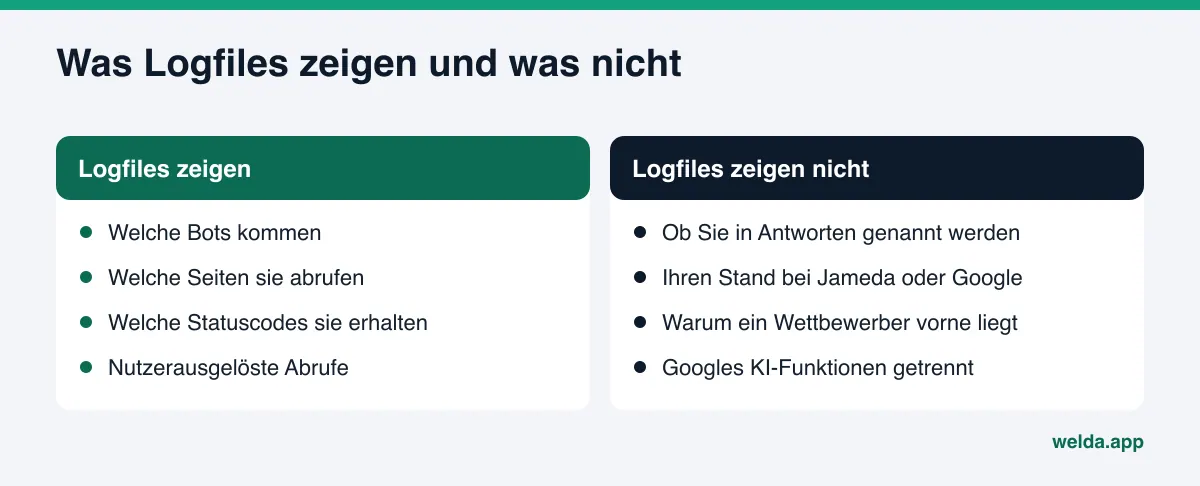
Logfiles sind wertvoll, aber begrenzt. Wer sie als Maß für KI-Sichtbarkeit liest, trifft falsche Entscheidungen. Vier Dinge zeigen sie nicht.
Ob Sie in Antworten genannt werden. Dass GPTBot Ihre Website hundertmal crawlt, heißt nicht, dass ChatGPT Sie bei der Frage nach einem Zahnarzt in Ihrer Stadt nennt. Antworten entstehen aus vielen Quellen, Ihre Website ist nur eine davon.
Was externe Quellen über Sie sagen. KI lernt lokale Betriebe oft weniger über deren eigene Website kennen als über das Google Unternehmensprofil, Jameda, Gelbe Seiten, ProvenExpert, Trustpilot oder Branchenverzeichnisse. Bots, die diese Seiten besuchen, erscheinen nicht in Ihrem Logfile. Wie Sie herausfinden, welche dieser Quellen für Sie zählen, beschreibt die Quellenanalyse für KI-Sichtbarkeit.
Warum ein Wettbewerber vorne liegt. Nichts im Logfile erklärt, warum bei einer bestimmten Frage ein anderer Betrieb zuerst genannt wird.
Googles KI-Funktionen als eigenen Verkehr. Da Google keinen eigenen KI-User-Agent nutzt, lassen sich KI-Übersichten oder der KI-Modus nicht vom normalen Googlebot-Crawling trennen.
Die Logfile-Analyse ist also eine Zugangsprüfung. Sie beantwortet die Frage "Ist die Tür offen?". Um zu wissen, was drinnen gesagt wird, müssen Sie echte Fragen an die KI-Systeme stellen und die Antworten auswerten. Welche Kennzahl was zeigt, ordnet der Beitrag zu GEO-KPIs, und wie Sie Kundschaft aus KI-Antworten zuordnen, steht im Beitrag zur Attribution für KI-Empfehlungen.
Wie Welda diese Aufgabe übernimmt
Vorweg, damit keine falsche Erwartung entsteht: Welda liest keine Server-Logfiles und fordert keine Protokolldateien an. Die Logfile-Analyse erledigen Sie oder die Person, die Ihre Website betreut. Welda arbeitet an den beiden Enden davor und danach: Von außen prüfen, ob die Tür offen ist, und messen, was in den Antworten passiert, wenn sie offen ist.
Die kostenlose Analyse: die Website mit den Augen eines Bots. Die Analyse liest Ihre Startseite und einige Unterseiten, etwa Leistungen, Preise, Über uns und Kontakt, so wie Google und KI-Crawler sie sehen. Zu den ersten Prüfpunkten gehört, ob Ihre robots.txt KI-Bots zulässt. Findet sie eine Sperre, steht im Bericht, was gefunden wurde, warum es wichtig ist und wie es sich beheben lässt. Derselbe Bericht prüft Seitentitel und Beschreibung, strukturierte Unternehmensdaten (Schema), Adresse und Telefon, FAQ-Inhalte und Ladezeit. Für die Deutung eines 403 im Logfile ist das ein guter erster Schritt: Findet die Analyse keine Sperre in der robots.txt, liegt die Ursache eher in einer Firewall- oder Sicherheitsregel. Die kostenlose Analyse funktioniert auf Deutsch.
Das Welda-Dashboard: Quellen und Fragen. Im Dashboard listet die Quellenansicht die Websites, auf die sich KI-Systeme in Ihrer Branche stützen, und Ihren Stand dort. Ihre eigene Website ist eine dieser Zeilen. Ist sie nicht erreichbar, wird die Zeile markiert, mit der passenden Aufgabe daneben. Den Zugang selbst zu reparieren, also eine Firewall-Regel zu ändern oder Serverfehler zu beheben, bleibt bei Ihnen oder Ihrem Hoster; Welda führt das als manuelle Aufgabe. Die Fragenansicht zeigt das Ergebnis. Welda stellt die Fragen, die Ihre Kundschaft stellen würde, je dreimal an ChatGPT, Gemini, Perplexity und Google AI und zeigt, ob und an welcher Stelle Ihr Name fällt. Nach einer Zugangskorrektur sehen Sie hier, ob die betroffenen Fragen Sie zu nennen beginnen. Das dauert in der Regel Wochen.
Zusammen decken diese Teile ab, was die Logfile-Analyse nicht kann. Das Logfile sagt, dass ein Bot da war. Die Quellenansicht zeigt, ob KI Ihre Website als Quelle nutzt, die Fragenansicht, ob daraus eine Nennung wird. Das Dashboard hat außerdem eine Aufgabenliste, eine Wettbewerbsansicht und einen einseitigen Monatsbericht; für dieses Thema sind aber die beiden genannten Ansichten entscheidend.
Zum Stand: Das Welda-Dashboard ist im Early Access und öffnet zuerst in der Türkei. Die regelmäßige Messung über vier KI-Systeme wird während des Early Access ergänzt, Beispielansichten zeigen repräsentative Daten. Heute für alle nutzbar ist die kostenlose Website-Analyse, auf Deutsch und Englisch. Preise werden im Early-Access-Gespräch besprochen.
Grenzen und was Welda nicht tut
Manches kann kein Werkzeug steuern, weder bei der Logfile-Analyse noch bei KI-Sichtbarkeit insgesamt. Wer das vorher weiß, hat realistische Erwartungen.
- Welda macht keine Logfile-Analyse. Es nimmt keine Protokolldateien entgegen und zählt keine Bot-Besuche. Diese Prüfung liegt bei Ihnen oder Ihrem Webteam.
- Keine Zusage für Platzierungen oder Nennungen in ChatGPT. Dass Bots Ihre Website sauber lesen, ist notwendig, aber nicht ausreichend. Weder Welda noch sonst jemand kann einen Platz in einer Antwort zusagen.
- Server- und Sicherheitseinstellungen bleiben bei Ihnen. Welda ändert keine Firewall-Regeln und greift nicht auf Ihren Server zu. Die WordPress-Verbindung dient nur dazu, Inhalte als Entwurf anzulegen und nach Ihrer Freigabe zu veröffentlichen.
- Keine erfundenen Angaben. Fehlen auf einer Seite Öffnungszeiten oder Einzugsgebiet, fragt Welda nach, statt zu raten.
- Nichts geht ohne Freigabe online. Vorbereitete Inhalte erscheinen als Entwurf auf Ihrer Website; Sie entscheiden über die Veröffentlichung.
- Wirkung braucht Zeit. Nach einer Zugangskorrektur müssen Crawler neu vorbeikommen und Antworten sich anpassen. Das dauert in der Regel Wochen.
Hinzu kommt die Natur der Messung. KI-Antworten schwanken von Abfrage zu Abfrage. Deshalb stellt Welda jede Frage dreimal und zeigt neben dem Wert eine Fehlerspanne. Wie Sie diese Spanne lesen, erklärt der Beitrag zu Schwankungen im KI-Sichtbarkeits-Tracking.
Monatliche Checkliste für KI-Crawler im Logfile
Die Logfile-Analyse für KI-Bots ist keine einmalige Sache. Website-Updates, neue Plugins und Hosting-Wechsel können den Zugang jederzeit stören. Die folgende Liste ist auf etwa eine halbe Stunde im Monat ausgelegt.
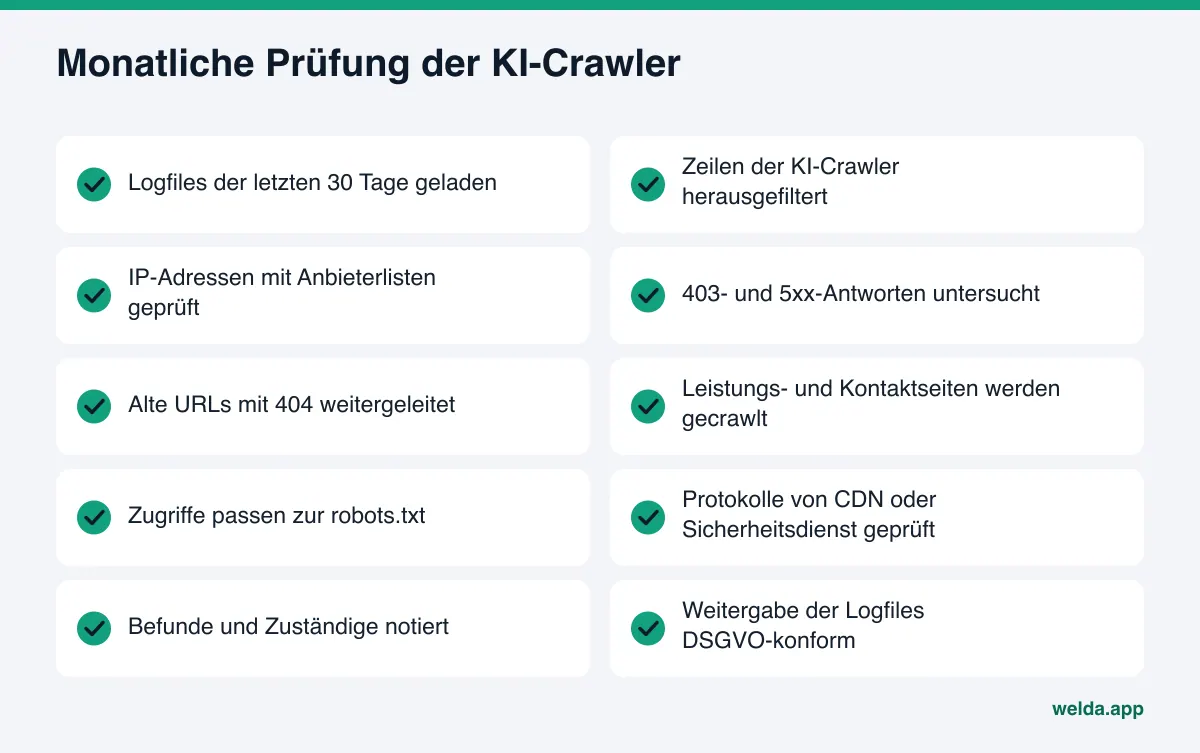
Hinter der Liste stehen zwei Entscheidungen. Die erste: Welche Bots lassen Sie zu? Sie können den Trainings-Crawler (GPTBot) sperren und die Such-Crawler (OAI-SearchBot, PerplexityBot) offen lassen. Das ist ein vernünftiger Mittelweg, wenn Sie Ihre Inhalte nicht fürs Training hergeben, aber in KI-Suchantworten erscheinen möchten. Wer einen Such-Crawler sperrt, nimmt sich aus den Suchantworten dieses Systems heraus. Die zweite: Wer ist zuständig? Liest jemand anderes die Logfiles als derjenige, der Probleme behebt, beschleunigen schriftliche Befunde alles.
| Entscheidung | Folge | Passend für |
|---|---|---|
| Alle KI-Crawler zulassen | Inhalte können für Training und Suchantworten genutzt werden | Lokale Betriebe, für die Sichtbarkeit an erster Stelle steht |
| Training sperren, Suche zulassen | Sie bleiben in KI-Suchantworten, ohne Trainingsdaten zu liefern | Betriebe, die sichtbar sein und Inhalte schützen wollen |
| Alle KI-Crawler sperren | Ihre eigene Website speist die Suchantworten dieser Systeme nicht mehr | Betriebe, die keine KI-Sichtbarkeit anstreben |
Häufige Fragen
Heißt GPTBot im Logfile, dass ich in ChatGPT erscheine?
Nein. GPTBot crawlt Inhalte für das Modelltraining. Ob Sie genannt werden, erfahren Sie nur, indem Sie Fragen stellen und die Antworten auswerten. Das Logfile zeigt lediglich, dass der Bot Ihre Website erreicht hat.
Was tun, wenn im Logfile überhaupt keine KI-Crawler auftauchen?
Prüfen Sie zuerst die robots.txt auf sperrende Zeilen. Steht ein CDN oder Sicherheitsdienst vor Ihrer Website, sehen Sie auch dessen Protokolle an. Findet sich keine Sperre, werden kleine Websites schlicht seltener gecrawlt; schauen Sie in einigen Wochen erneut.
Kommt jede Anfrage mit dem User-Agent GPTBot wirklich von OpenAI?
Nein. User-Agents lassen sich leicht fälschen. Gleichen Sie die IP der Anfrage mit der von OpenAI veröffentlichten IP-Liste ab. Eine Adresse außerhalb der Liste ist sehr wahrscheinlich ein Nachahmer.
Warum finde ich Google-Extended nicht im Logfile?
Weil Google-Extended kein Crawler ist, sondern ein Token in der robots.txt. Das Crawling von Google erscheint als Googlebot; Google-Extended steuert nur, wie Ihre Inhalte für Gemini verwendet werden dürfen.
Analysiert Welda meine Server-Logfiles?
Nein. Welda nimmt keine Logfiles entgegen und zählt keine Bot-Besuche. Die kostenlose Analyse prüft robots.txt-Zugang und Lesbarkeit von außen, das Dashboard misst, ob Ihr Name in Antworten fällt.
Wann zeigt sich nach einer Zugangskorrektur eine Wirkung?
Einen festen Zeitraum gibt es nicht. Crawler müssen erneut vorbeikommen und Antworten sich anpassen, was in der Regel Wochen dauert. Dieselben Fragen über ein bis zwei Monate zu verfolgen, ist der ehrliche Weg, eine Veränderung zu erkennen.
Fazit: erst die Tür öffnen, dann die Antworten messen
Die Logfile-Analyse für KI-Bots beantwortet die grundlegendste Frage der KI-Sichtbarkeit: Kommen die Crawler überhaupt herein? Lautet die Antwort nein, bleibt Arbeit an Inhalten und Profilen weitgehend wirkungslos. Lautet sie ja, geht es als Nächstes darum, was in den Antworten steht. Als ersten Schritt prüfen Sie mit der kostenlosen Website-Analyse, wie Ihre Website für KI lesbar ist und ob die robots.txt etwas sperrt. Der Bericht nennt jede gefundene Lücke und den Weg, sie zu schließen.