Können KI-Crawler eine Website lesen, die mit JavaScript aufgebaut ist? Oft nur teilweise. Die meisten KI-Crawler lesen das HTML, das Ihr Server beim ersten Aufruf ausliefert, und führen das JavaScript nicht aus, das die Seite im Browser füllt. Erscheinen Leistungen, Adresse und FAQ erst, nachdem JavaScript gelaufen ist, kommen diese Angaben in KI-Antworten womöglich nie an.
Dieser Beitrag behandelt JavaScript-Websites und KI-Crawler aus Sicht von Inhaberinnen und Inhabern kleiner und mittlerer Unternehmen: worin die Lücke besteht, wie Sie Ihre eigene Website in etwa fünf Minuten prüfen, welche Darstellungsverfahren Sie mit Ihrer Agentur oder Ihrem Entwickler besprechen sollten und welchen Teil der Arbeit Welda übernimmt. Das Thema gehört zur KI-Sichtbarkeit und zu GEO (Generative Engine Optimization), also der Arbeit daran, in KI-Antworten genannt zu werden. Im englischsprachigen Raum heißt dasselbe häufig AEO (Answer Engine Optimization). Die Korrektur betrifft meist den technischen Aufbau der Website, die Entscheidung liegt deshalb bei Ihnen, auch wenn die Details technisch sind. Wenn Sie vorab sehen möchten, wie Ihre Website für einen Crawler aussieht, starten Sie die kostenlose KI-Sichtbarkeitsanalyse. Sie liest Ihre Seiten so, wie der Server sie ausliefert, und markiert es, wenn dort kaum Text ankommt.
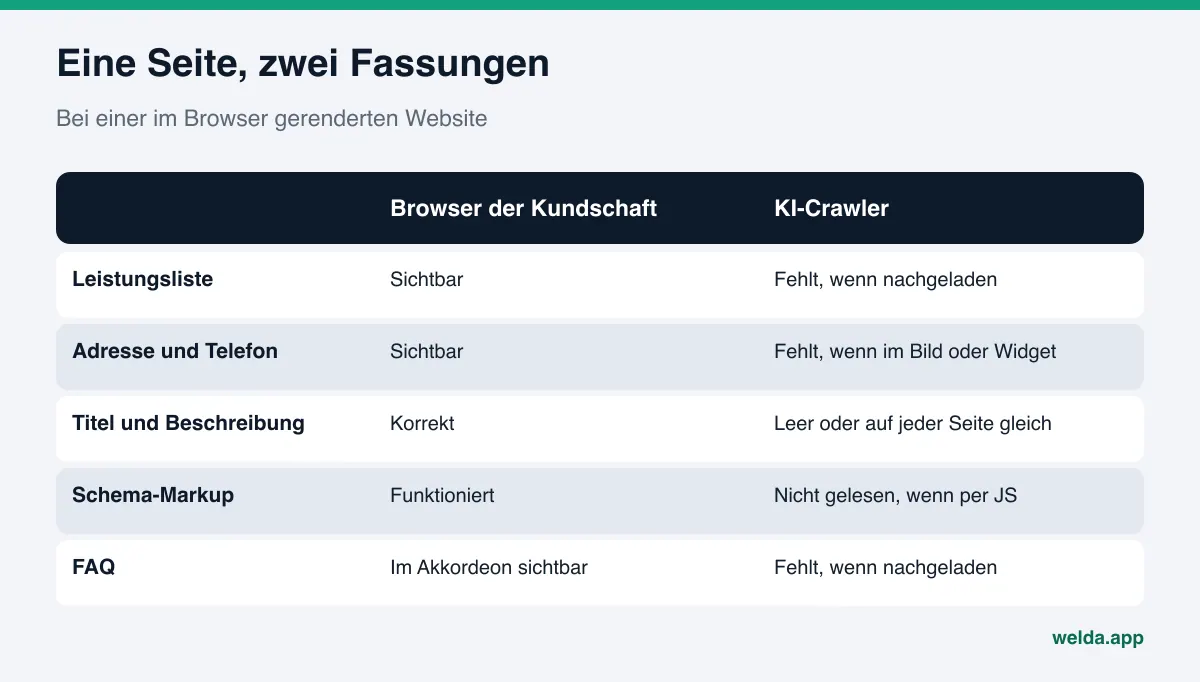
Was sieht der Browser, was sieht der KI-Crawler?
Beim Aufruf einer Webseite passiert zweierlei. Zuerst schickt der Server eine HTML-Datei. Dann führt der Browser das darin verlinkte JavaScript aus, und dieses Skript baut einen Teil der Seite oder die ganze Seite auf. Für Besucherinnen und Besucher ist kein Unterschied zu erkennen: Einen Augenblick später stehen Leistungsliste, Preistabelle und Telefonnummer auf dem Bildschirm.
Für einen Crawler ist genau dieser Unterschied entscheidend. Google arbeitet in Stufen. Laut den JavaScript-Grundlagen von Google Search Central wird eine Seite zuerst gecrawlt, später mit einem Headless-Browser gerendert und erst dann indexiert. Dieselbe Anleitung hält ausdrücklich fest, dass nicht alle Bots JavaScript ausführen können. Bei den Crawlern der KI-Anbieter ist das Bild noch deutlicher. Eine im Dezember 2024 veröffentlichte Auswertung von Crawler-Zugriffen kam zu dem Ergebnis, dass keiner der untersuchten großen KI-Crawler JavaScript rendert; Ausnahme war Gemini, das die Crawling-Infrastruktur von Google nutzt.
Jede Seite, die Sie veröffentlichen, existiert also in zwei Fassungen:
- Das Server-HTML: die Fassung, die der Crawler liest. Bei manchen Websites besteht sie fast nur aus einem leeren Container und einem Verweis auf eine Skriptdatei.
- Die gerenderte Seite: die Fassung, die Ihre Kundschaft sieht. Hier stehen alle Texte, Überschriften und Kontaktdaten.
Je größer der Abstand zwischen beiden, desto weniger weiß ein KI-System über Ihr Unternehmen.
Warum JavaScript-Websites und KI-Crawler für Ihre KI-Sichtbarkeit zählen
Beantworten ChatGPT, Perplexity oder die KI-Übersichten von Google eine Frage wie „Elektriker mit Notdienst in Graz“ oder „Physiotherapie in Zürich-Oerlikon mit Abendterminen“, holen sie Informationen aus dem Web. Die Crawler-Dokumentation von OpenAI beschreibt dafür getrennte User-Agents: OAI-SearchBot zeigt Websites in den Suchfunktionen von ChatGPT an, GPTBot sammelt Inhalte, die für das Training von Modellen verwendet werden können, und ChatGPT-User ruft eine Seite auf, wenn die Frage einer Person das erfordert. Welcher Bot auch kommt: Was er von Ihrer Seite mitnimmt, ist der Text, den Ihr Server zurückgibt.
Ist dieser Text dünn, hat das drei Folgen:
- Die KI erkennt nicht, was Sie anbieten. Leistungsbezeichnungen, Zielgruppe und Einzugsgebiet erreichen den Crawler nicht. Das System kann Sie keiner Frage zuordnen.
- Andere Quellen sprechen für Sie. Liefert Ihre Website nichts, werden Google Unternehmensprofil, Gelbe Seiten, ProvenExpert oder Jameda zur wichtigsten Beschreibung Ihres Betriebs. Sind die Angaben dort lückenhaft oder veraltet, ist es die Antwort auch.
- Ihre Inhaltsarbeit verpufft. Ein sorgfältig geschriebener FAQ-Bereich, der per JavaScript nachgeladen wird, existiert für diese Crawler nicht.
Am häufigsten tritt das Muster bei Websites auf, die als Single-Page-Application gebaut sind, bei Seiten, die mit Frameworks wie React, Vue oder Angular nur im Browser gerendert werden, bei Vorlagen, die Inhalte nach dem Laden über eine Schnittstelle abrufen, und bei Websites, die Speisekarte, Preisliste oder Bewertungen über ein externes Widget einbinden. Die Frameworks selbst sind nicht das Problem; mit denselben Werkzeugen lassen sich vollständig serverseitig gerenderte Seiten bauen. Das Problem ist wichtiger Text, der erst im Browser entsteht.
So prüfen Sie Ihre Website in fünf Minuten
Dafür müssen Sie nicht programmieren können. Ein Desktop-Browser genügt.
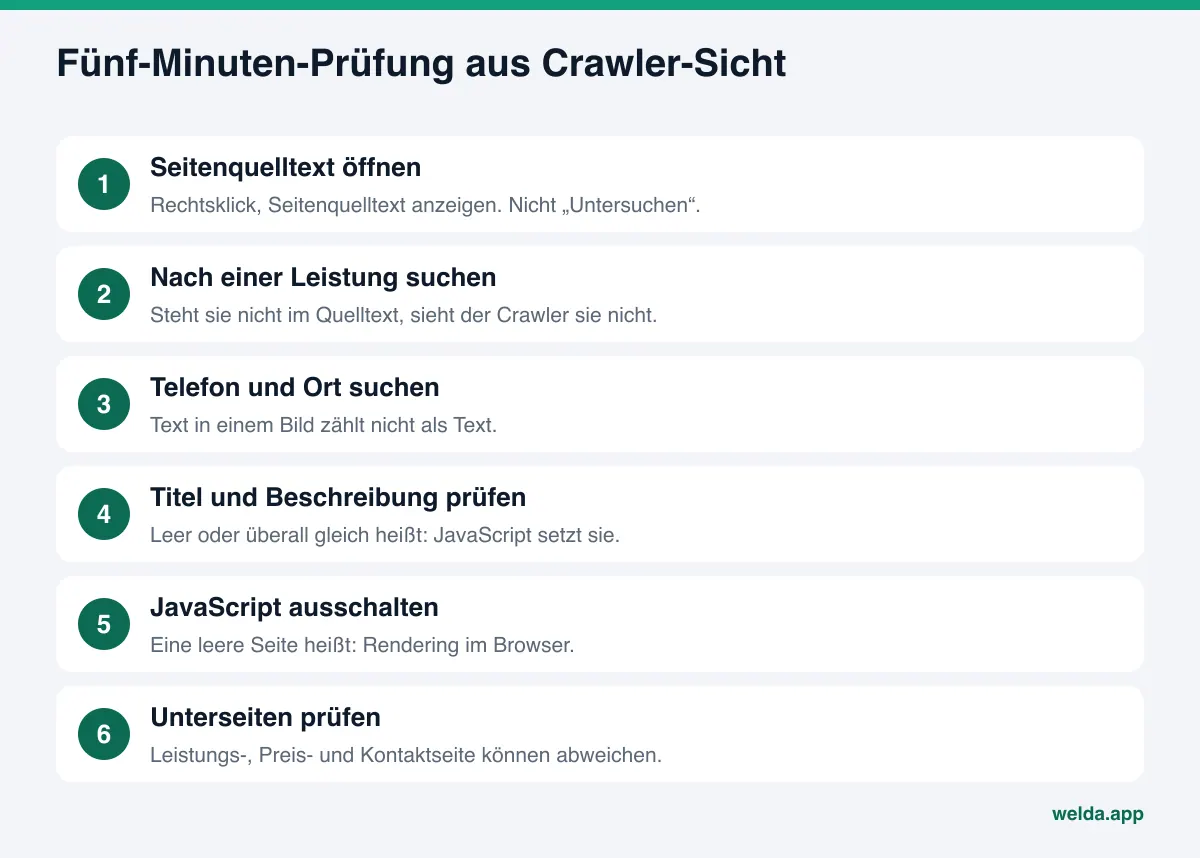
- Öffnen Sie den Seitenquelltext. Klicken Sie auf Ihrer Startseite mit der rechten Maustaste auf „Seitenquelltext anzeigen“ oder setzen Sie
view-source:vor die Adresse. Das ist das HTML, das der Server geschickt hat. Es ist nicht dasselbe wie die Ansicht unter „Untersuchen“, die die Seite nach dem Ausführen von JavaScript zeigt. - Suchen Sie nach einer Leistung. Drücken Sie Strg+F (am Mac Cmd+F) und suchen Sie im Quelltext nach Ihrer wichtigsten Leistung. Finden Sie sie nicht, findet sie ein Crawler ohne JavaScript auch nicht.
- Suchen Sie nach Telefonnummer und Ort. Stehen diese nur in einem Bild oder in einem nachgeladenen Karten-Widget, liest der Crawler sie nicht als Text.
- Prüfen Sie Titel und Beschreibung. Sehen Sie sich oben im Quelltext das
<title>-Element und die Zeilemeta name="description"an. Auf manchen Websites setzt JavaScript diese Angaben; im Quelltext sind sie dann leer oder auf jeder Seite gleich. - Schalten Sie JavaScript aus. Deaktivieren Sie JavaScript vorübergehend in den Browser-Einstellungen oder Entwicklertools und laden Sie die Seite neu. Eine weiße Seite oder ein drehendes Ladesymbol ist ungefähr das, was viele KI-Crawler erhalten.
- Wiederholen Sie das auf Unterseiten. Prüfen Sie Leistungs-, Preis- und Kontaktseite genauso. Die Startseite kann vorgerendert sein, während Unterseiten im Browser entstehen.
Am Ende stehen Sie vor einer von wenigen Situationen. Die Tabelle ordnet jeder Situation den nächsten Schritt zu.
| Was im Quelltext steht | Bedeutung | Nächster Schritt |
|---|---|---|
| Leistungen, Adresse, Telefon, Titel und Beschreibung als Text | Crawler können den Kern der Seite lesen | Weiter mit Inhaltsqualität und Unternehmensangaben |
| Haupttext vorhanden, aber Bewertungen, FAQ oder Preise fehlen | Einzelne Bereiche werden nachgeladen | Diese Bereiche ins Server-HTML verlagern |
| Titel und Beschreibung auf jeder Seite gleich | Seitenbezogene Angaben setzt JavaScript | Angaben serverseitig je Seite erzeugen |
| Nur ein leerer Container und Skriptdateien | Die Website wird vollständig im Browser gerendert | Rendering-Verfahren mit dem Entwickler klären |
| Seite lädt nicht oder zeigt eine Sicherheitsabfrage | Automatisierte Zugriffe werden womöglich blockiert | Firewall- und Bot-Einstellungen prüfen |
Die letzte Zeile hat mit JavaScript nichts zu tun, das Ergebnis ist aber dasselbe: Der Crawler erreicht Ihre Inhalte nicht. Wie Sie prüfen, ob Ihre robots.txt KI-Crawler aussperrt, beschreiben wir in robots.txt für KI-Crawler.
Beispiel: eine Handwerkerseite, die im Browser entsteht
Ein frei erfundenes Beispiel, das keinen echten Betrieb beschreibt: Ein Sanitär- und Heizungsbetrieb in Augsburg hat seine Website vor einigen Jahren als Single-Page-Application bauen lassen. Im Browser sieht sie ordentlich aus: ein Leistungsbereich mit Badsanierung, Heizungswartung und Notdienst, darunter Einzugsgebiet und Öffnungszeiten, ganz unten ein FAQ.
Im Seitenquelltext zeigt sich folgendes Bild:
| Seitenelement | Im Browser | Im Quelltext |
|---|---|---|
| Seitentitel | Firmenname plus „Sanitär und Heizung in Augsburg“ | Nur der Firmenname, auf jeder Seite gleich |
| Leistungsbereich | Drei Leistungen mit kurzer Beschreibung | Fehlt |
| Einzugsgebiet, Zeiten, Telefon | Im Fußbereich | Fehlt |
| FAQ | Sechs Fragen im Akkordeon | Fehlt |
| LocalBusiness-Schema | Unsichtbar, per Tag-Manager eingebunden | Fehlt |
Ein KI-System, das die Frage „Heizungsnotdienst in Friedberg bei Augsburg“ beantwortet, könnte dieser Website kaum mehr als den Firmennamen entnehmen. Welche Leistungen der Betrieb anbietet, welche Orte er anfährt und ob er am Wochenende erreichbar ist, müsste aus anderen Quellen kommen, etwa aus dem Google Unternehmensprofil oder den Gelben Seiten, sofern diese vollständig sind.
Neue Texte braucht der Betrieb hier nicht. Die Texte sind vorhanden. Die Aufgabe besteht darin, sie in das HTML zu bringen, das der Server ausliefert. Genau deshalb gehört diese Prüfung vor jedes Budget für Inhalte: Wenn vorhandener Text den Crawler nicht erreicht, ändert zusätzlicher Text nichts.
Welches Rendering-Verfahren passt zu Ihrer Website?
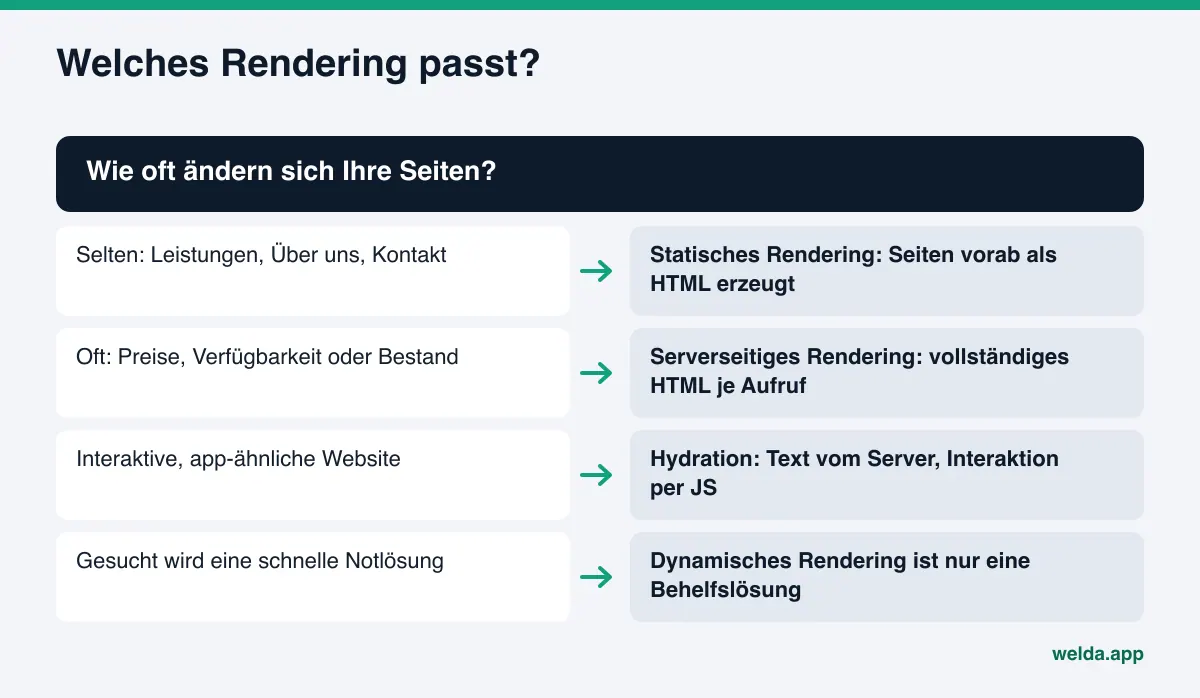
Der Fachbegriff für das Problem lautet Client-Side Rendering. Die Lösung besteht darin, wichtigen Text in das HTML zu legen, das der Server schickt. Dafür gibt es mehrere Wege, und welcher passt, hängt vom Aufbau Ihrer Website ab.
- Serverseitiges Rendering (SSR): Jede Seite wird bei jedem Aufruf auf dem Server zusammengesetzt, Crawler und Kundschaft erhalten dasselbe vollständige HTML. Geeignet für Inhalte, die sich oft ändern.
- Statisches Rendering (Prerendering): Seiten werden vorab als HTML-Dateien erzeugt. Ein einfacher Weg für Seiten, die sich selten ändern, etwa Leistungen, Über uns und Kontakt.
- Hydration: Die Seite kommt vollständig gerendert vom Server, JavaScript ergänzt danach nur die Interaktion. Der übliche Weg für Websites, die sich wie eine App anfühlen sollen.
- Dynamisches Rendering: Crawlern wird eine eigene, vorgerenderte Fassung ausgeliefert. Google bezeichnet das als Behelfslösung und nicht als langfristige Lösung und empfiehlt stattdessen serverseitiges Rendering, statisches Rendering oder Hydration.
Fragen für das Gespräch mit Ihrem Entwickler: „Warum fehlen die Leistungstexte im Seitenquelltext?“, „Lassen sich diese Seiten serverseitig rendern oder vorrendern?“, „Stehen Titel, Beschreibung und Schema-Markup beim ersten Laden im HTML?“, „Ändern sich URLs?“ Die letzte Frage ist wichtig. Ändern sich Adressen, brauchen die alten Weiterleitungen auf die neuen.
Sie müssen nicht alles auf einmal umbauen. Für die meisten lokalen Betriebe gilt diese Reihenfolge: zuerst Startseite und Leistungsseiten, dann Kontakt und Über uns, zuletzt Blog und Aktionsseiten. Interaktive Teile wie ein Terminbuchungs-Widget oder ein Kostenrechner dürfen in JavaScript bleiben, solange dieselbe Information auch als einfacher Text auf der Seite steht.
Was im Server-HTML stehen muss
Gleich welches Verfahren Ihr Entwickler wählt: Bestimmte Angaben müssen bereits in der ersten HTML-Antwort als Text stehen, damit ein KI-System Ihr Unternehmen richtig beschreiben kann. Die Liste eignet sich auch zur Kontrolle nach der Umstellung.
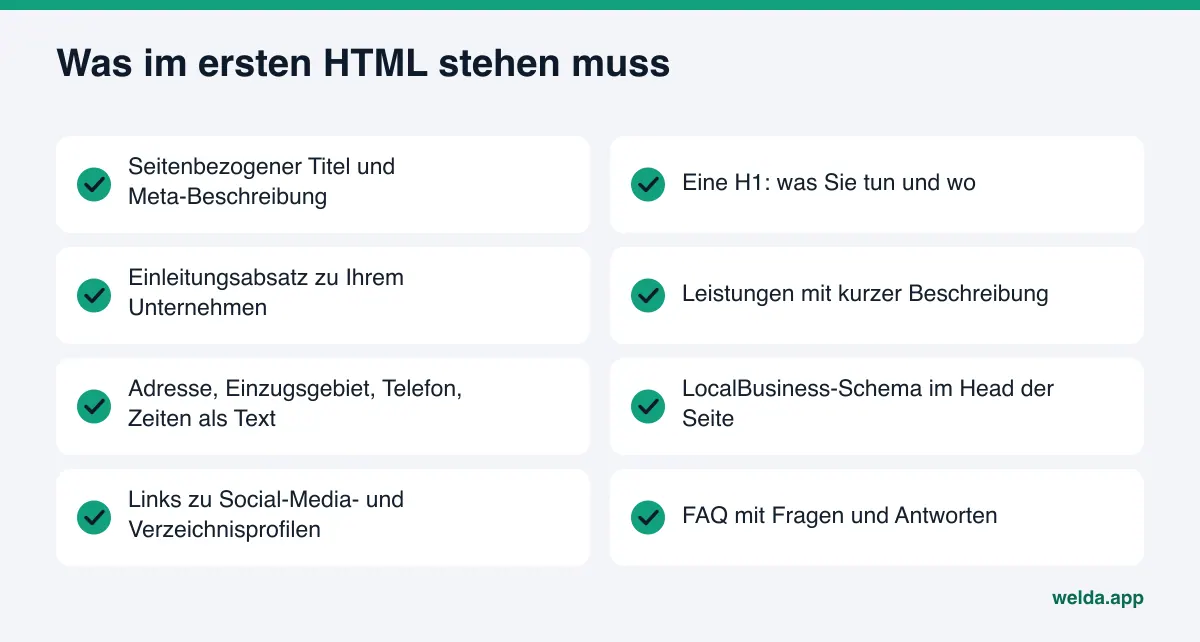
- Seitenbezogener Titel und Meta-Beschreibung
- Eine H1, die sagt, was Sie tun und wo
- Ein Einleitungsabsatz, der Ihr Unternehmen erklärt
- Leistungen oder Produktgruppen mit kurzer Beschreibung
- Adresse, Ort oder Einzugsgebiet, Telefon und Öffnungszeiten als Text, nicht im Bild
- LocalBusiness-Schema als JSON-LD im Head der Seite
- Links zu Ihren Social-Media- und Verzeichnisprofilen
- FAQ mit Fragen und Antworten
Achten Sie besonders auf das Schema-Markup. Manche Websites binden die Unternehmensangaben über einen Tag-Manager oder ein Plugin ein, das JavaScript ausführt. Google liest das nach dem Rendern oft mit, ein Crawler ohne JavaScript nicht. Markup, das im Seitenquelltext steht, ist der verlässliche Weg. Wie Sie Ihre Profile in diesem Markup verknüpfen, lesen Sie unter Social-Media-Profile per sameAs verknüpfen; wie Sie einen Fragen-und-Antworten-Bereich aufbauen, unter FAQ-Seiten für GEO.
Wie Welda JavaScript-Probleme bei der KI-Sichtbarkeit angeht
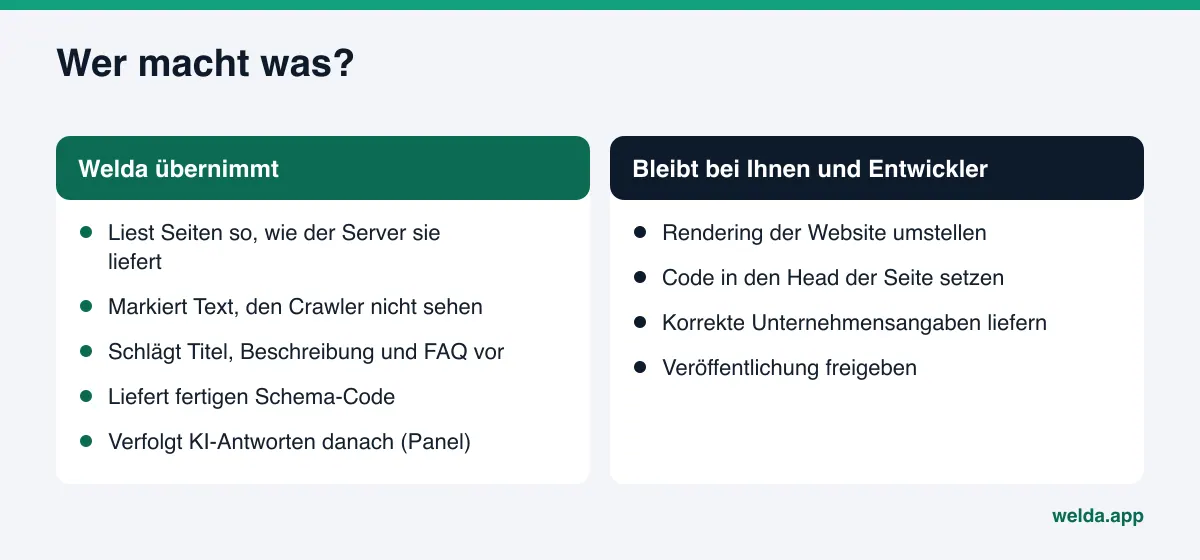
Welda ist eine Software für KI-Sichtbarkeit: Sie misst, wo ein Unternehmen in KI-Antworten erscheint, und ergänzt, was fehlt. Bei diesem Thema besteht die Aufgabe aus drei Teilen: das Problem sichtbar machen, Text und Code für Ihr Server-HTML vorbereiten und danach verfolgen, was sich in KI-Antworten ändert. Das Rendering Ihrer Website umzustellen, bleibt Aufgabe Ihres Entwicklers.
Die kostenlose Analyse liest Ihre Seiten wie ein Crawler
Die kostenlose Analyse liest Ihre Startseite und einige Unterseiten (Leistungen, Preise, Über uns, Kontakt) so, wie der Server sie ausliefert. Sie führt kein JavaScript aus, der Bericht kommt der Sicht eines Crawlers daher nahe. In der Gruppe Zugriff gibt es einen eigenen Punkt „Seitentext ist für Bots sichtbar“; enthält das Server-HTML wenig lesbaren Text, wird er als fehlend oder als Problem markiert. Titel, Meta-Beschreibung, H1 und Schema-Markup werden aus demselben HTML gelesen. Setzt nur JavaScript diese Angaben, erscheinen sie im Bericht als fehlend.
Das macht den Bericht zu einem nützlichen Hinweis. Sieht im Browser alles richtig aus, meldet der Bericht aber fehlenden Titel und fehlende Leistungstexte, liegt die Ursache sehr wahrscheinlich im Rendering, nicht im Inhalt. Zu jeder Lücke steht im Bericht, was gefunden wurde, warum es wichtig ist und wie es sich beheben lässt; diese Seite können Sie unverändert an Ihren Entwickler weitergeben. Die Analyse funktioniert auf Deutsch und Englisch. Wie Sie die einzelnen Abschnitte lesen, erklärt KI-Sichtbarkeitsanalyse verstehen.
Fertiger Text und Code für das Server-HTML
Ein korrigiertes Rendering legt noch nicht fest, was im ersten HTML stehen soll. Die Analyse schlägt für die Startseite Titel, Meta-Beschreibung, H1, Einleitungsabsatz und FAQ vor. Dazu kommt ein fertiges Korrekturpaket zum Einbau auf der Website, das auch den Code für die Unternehmensangaben (Schema) enthält. Ihr Entwickler kann diesen Code direkt in den Head der Seite setzen, statt ihn über einen Tag-Manager einzuspielen. Eine Simulation zeigt, wie stark jede Korrektur den Score voraussichtlich verändert. So entscheiden Sie, welche Seite zuerst an der Reihe ist.
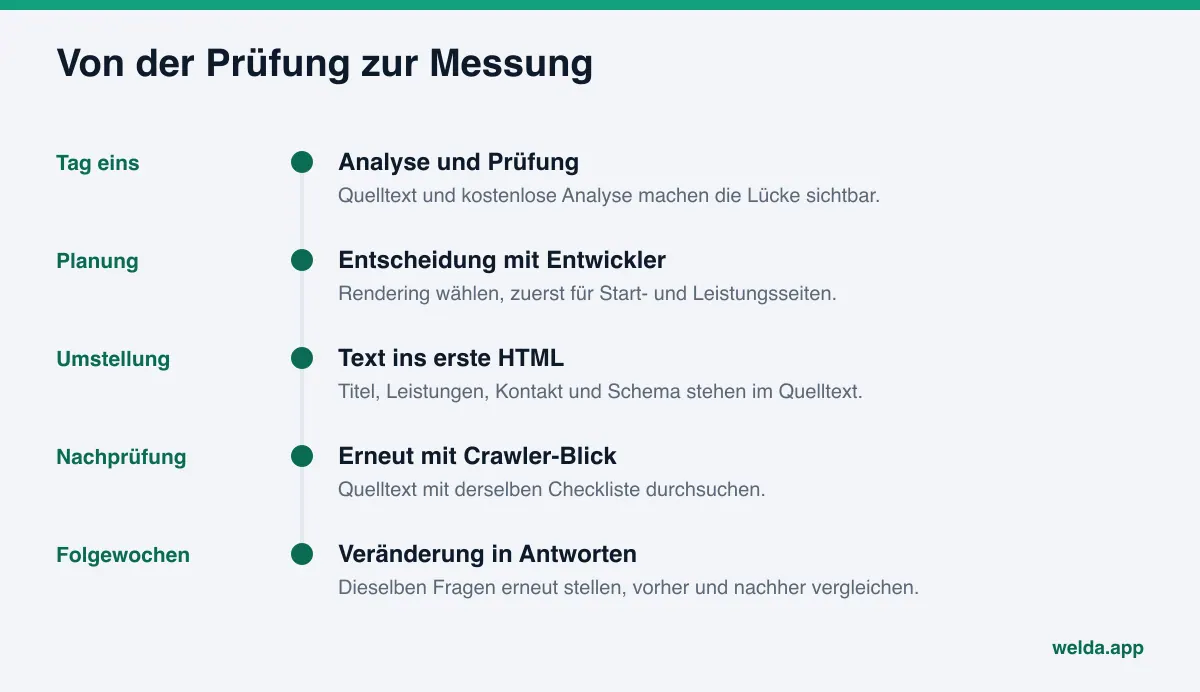
Das Panel: Aufgaben nach Zuständigkeit, danach Messung
Im Welda-Panel stehen Aufgaben in einer einzigen Liste, getrennt danach, wer handeln muss. Angaben, die Welda auf Ihrer Website nicht lesen konnte, werden bei Ihnen erfragt; Welda rät sie nicht. Aufgaben ohne angebundenes System erscheinen als manuelle Aufgabe mit fertigem Text daneben, und technische Probleme, die das Auslesen einer Seite erschweren, landen auf derselben Liste. Die Umstellung des Renderings ist Entwicklerarbeit, Welda übernimmt sie also nicht, aber Problem und Seitentext liegen bereit. Bei WordPress-Websites verbindet sich Welda über einen eigenen Redakteur-Benutzer und ein Anwendungspasswort, ohne Code zu installieren; Inhalte öffnen sich als Entwurf und gehen erst nach Ihrer Freigabe online. Ihre Inhalte bleiben immer auf Ihrer eigenen Website.
Ob eine Korrektur wirkt, prüft das Panel, indem es die wahrscheinlichen Fragen Ihrer Kundschaft je dreimal an ChatGPT, Gemini, Perplexity und Google AI stellt und zeigt, bei welcher Frage und an welcher Stelle Ihr Name fällt. Ein Vorher-nachher-Vergleich stellt die Wochen vor und nach der Änderung nebeneinander. Neue Inhalte brauchen in der Regel Wochen, bis sie in KI-Antworten auftauchen; ein Ergebnis aus der ersten Woche ist daher kein Urteil.
Zum Stand des Produkts: Das Panel befindet sich im Early Access und öffnet zuerst in der Türkei. Die regelmäßige Messung über vier Engines kommt während des Early Access hinzu, Beispielansichten im Panel zeigen repräsentative Daten. Für alle nutzbar ist heute die kostenlose Analyse, und zwar auf Deutsch und Englisch. Über den Preis sprechen wir im Early-Access-Gespräch.
Grenzen: was Welda nicht übernimmt
Wer weiß, wo Weldas Aufgabe endet, führt das Gespräch mit dem Entwickler leichter.
- Welda ändert nicht den Code Ihrer Website. Die Umstellung auf serverseitiges Rendering, ein Theme-Wechsel oder ein Umbau der Seitenstruktur ist Entwicklerarbeit. Welda zeigt das Problem und bereitet den Text vor.
- Keine vollständige Rendering-Prüfung. Die kostenlose Analyse betrachtet einige Seiten und liest das Server-HTML. Sie crawlt nicht jede URL Ihrer Website.
- Keine Garantie für Rankings oder Nennungen in ChatGPT. Auch eine vollständig lesbare Seite ist kein Versprechen; welche Betriebe genannt werden, entscheidet das KI-System.
- Keine erfundenen Angaben. Lassen sich Öffnungszeiten, Einzugsgebiet oder Preise nicht von Ihrer Website lesen, fragt Welda bei Ihnen nach.
- Keine Veröffentlichung ohne Freigabe. Vorbereitete Inhalte kommen zu Ihnen; die Entscheidung über die Veröffentlichung treffen Sie.
- Keine Ranking-Messung. Die kostenlose Analyse misst nicht Ihre Google-Position, ihr KI-Test ist eine einmalige Messung.
Noch ein Hinweis: Ein korrigiertes Rendering reicht allein oft nicht. Sobald Crawler Ihre Seiten lesen können, braucht es weiterhin klare Texte zu Ihren Leistungen und vollständige Einträge auf den Plattformen, auf die sich KI-Systeme stützen. Das Rendering öffnet die Tür; Inhalte und Quellen bestimmen, was hindurchgeht. Wenn Ihre Werte sinken und Sie technische von anderen Ursachen trennen wollen, lesen Sie KI-Sichtbarkeit gesunken.
Checkliste vor dem Gespräch mit Ihrem Entwickler
Füllen Sie diese Liste einmal aus, dann wissen Sie genau, was Sie beauftragen.
- Stehen Ihre drei wichtigsten Leistungen im Seitenquelltext?
- Stehen Telefonnummer, Adresse und Ort als Text im Quelltext?
- Hat jede Seite im Quelltext einen eigenen, gefüllten Titel und eine Meta-Beschreibung?
- Ist das Schema-Markup im Quelltext sichtbar, oder kommt es über ein Plugin oder einen Tag-Manager?
- Stehen FAQ-Fragen und Antworten als Text im Quelltext?
- Bleibt die Seite mit ausgeschaltetem JavaScript leer?
- Sperrt die robots.txt KI-Crawler, oder blockiert eine Firewall automatisierte Zugriffe?
- Ändern sich nach der Umstellung URLs, und sind Weiterleitungen geplant?
Beantworten Sie eine der ersten beiden Fragen mit Nein, sollte das Rendering vor jeder Inhaltsarbeit korrigiert werden. Sonst landet jeder neue Text im selben toten Winkel. Lautet die Antwort nur bei den Fragen 3, 4 oder 5 Nein, ist ein Komplettumbau meist nicht nötig; es genügt, diese Teile ins Server-HTML zu verlagern.
Ein Punkt beim Durchgehen der Liste: Wer nur die Startseite prüft, kann sich täuschen. Auf vielen Websites ist die Startseite vorgerendert, während Leistungs- oder Preisseiten im Browser entstehen. Gerade die Fragen der Kundschaft hängen oft an den Angaben dieser Unterseiten.
Häufige Fragen
Wenn Google meine Website lesen kann, können KI-Crawler das auch?
Nicht unbedingt. Google rendert JavaScript in einem eigenen Schritt, und Gemini greift auf diese Infrastruktur zurück. Viele andere KI-Crawler lesen nur das HTML, das Ihr Server ausliefert. Gute Sichtbarkeit bei Google heißt nicht, dass ChatGPT oder Perplexity Ihre Seiten lesen können.
Meine Website ist mit React gebaut. Brauche ich einen Neubau?
Meist nicht. React und ähnliche Frameworks können serverseitig rendern oder Seiten vorrendern. Bitten Sie Ihren Entwickler zuerst, die wichtigen Seiten beim ersten Laden mit vollständigem HTML auszuliefern. Ein Neubau ist nur nötig, wenn der bestehende Aufbau das nicht zulässt.
Warum unterscheidet sich der Seitenquelltext von der Ansicht unter „Untersuchen“?
Der Seitenquelltext ist das erste HTML vom Server. „Untersuchen“ zeigt die Seite nach dem Ausführen von JavaScript. Um zu sehen, was ein Crawler sieht, nutzen Sie den Seitenquelltext.
Löst eine llms.txt-Datei das Problem?
Nein. Eine llms.txt-Datei ist eine Zusammenfassung. Sie ersetzt keine Seiten, deren Inhalt sich tatsächlich auslesen lässt.
Wann sehe ich nach der Korrektur einen Unterschied?
Einen festen Zeitraum gibt es nicht. Crawler müssen Ihre Seiten erneut besuchen, und neue Angaben müssen in die Antworten einfließen; das dauert in der Regel Wochen. Verfolgen Sie die Entwicklung, indem Sie dieselben Fragen in festen Abständen erneut stellen.
Erkennt die kostenlose Analyse JavaScript-Probleme sicher?
Sie liest Ihre Seiten so, wie der Server sie ausliefert, und markiert wenig sichtbaren Text. Das ist ein deutlicher Hinweis, aber keine vollständige technische Prüfung. Für eine sichere Diagnose und die Korrektur muss Ihr Entwickler den Aufbau der Website ansehen.
Nächster Schritt: Ihre Website mit den Augen eines Crawlers sehen
Probleme zwischen JavaScript-Websites und KI-Crawlern bleiben oft unbemerkt, weil im Browser alles in Ordnung aussieht. Der erste Schritt ist, zu sehen, was Ihr Server tatsächlich ausliefert. Starten Sie die kostenlose KI-Sichtbarkeitsanalyse: Der Bericht zeigt, ob Ihr Seitentext für Bots sichtbar ist, ob Titel, Beschreibung und Schema-Markup gelesen werden und was bei jeder Lücke zu tun ist. Der Link zum Ergebnis kommt per E-Mail und bleibt 14 Tage abrufbar, sodass Sie ihn direkt mit Ihrem Entwickler teilen können.